AIエージェントは、目的と完了条件を受け取り、必要な情報を集め、道具を使い、結果を確かめながら、一件の仕事を終わりまで運ぶ仕組みです。チャットに質問して答えをもらう使い方との違いは、外部の結果を見て次の行動を選び直すところにあります。調査、問い合わせの一次処理、書類の突き合わせなど任せられる仕事の型と、取り消せない操作のように任せない方がよい仕事、失敗が起きる場所、導入前に決めておく条件、費用の見方を順に整理します。
AIエージェントは目的を受け取って終わりまで運ぶ仕組み
AIエージェントとは、人から目的と完了条件を受け取り、途中で情報を集め、道具を操作し、結果を確かめながら、成果物を返すところまで進める仕組みです。途中で失敗したら手段を変え、人の判断が要る場所では止まって確認を求めます。
言葉の範囲は広く、問い合わせを分類するAI、広告を審査するAI、在庫を補充するAIもAIエージェントと呼ばれます。これらは対象の仕事を一つに絞ることで、動きが読みやすく、責任の範囲も決めやすくなります。一方、仕事を一つに限定せず、ファイル、コマンド、Web、外部サービスへ接続して複数の工程を進めるものもあります。この記事では後者を汎用AIエージェントと呼びます。製品の正式な分類ではなく、実行のしかたが共通する一群を指す呼び方です。
開発の現場で使われているCodexやClaude Codeは、この汎用型の代表例です。Anthropicの公式資料はClaude Codeを、コードベースを読み、ファイルを編集し、コマンドを実行し、開発道具と連携するエージェント型のコーディング道具だと説明しています。プログラムを書く仕事に限らず、端末のコマンドとファイル操作は事務作業にも共通する操作口になるため、調査や資料作成にも使われています。
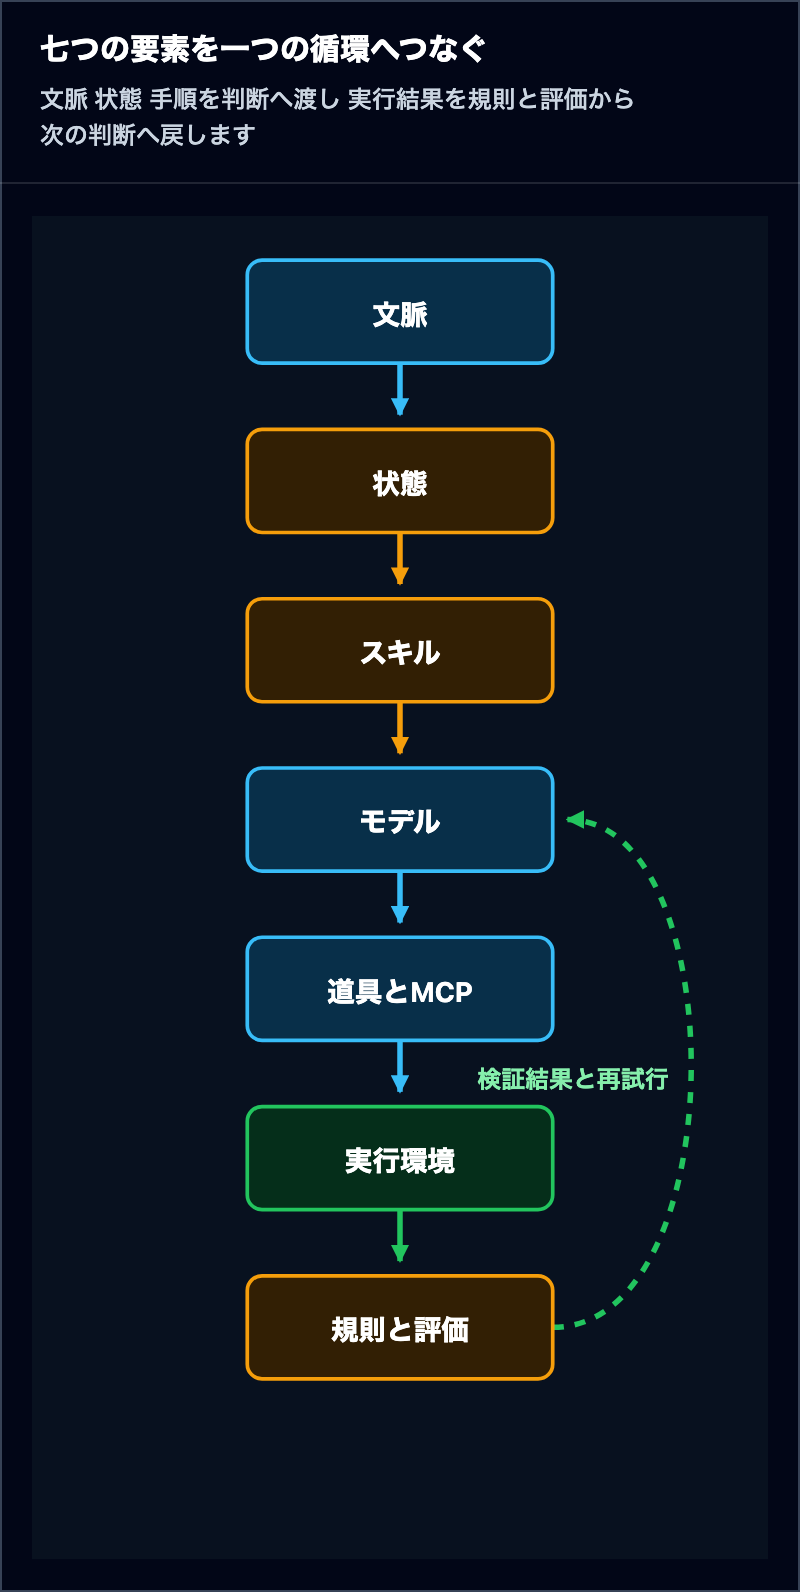
動きは、次の七つの部品の循環として整理できます。
- モデルと推論: 状況を読み、次に何をするか決める。
- 文脈: 依頼文、社内資料、ファイル、過去のやりとりなどの判断材料。
- 記憶と状態: 途中経過、確認済みの事実、未完了の作業、再開する地点。
- スキル: 仕事ごとの手順、判断基準、完了条件をまとめて再利用できるようにしたもの。
- 道具と接続: データを読み、外部システムを操作するための入口。
- 実行環境: ファイル操作やプログラム実行が実際に行われる場所。
- 規則と評価: 権限、承認、記録、結果の検査、失敗したときの停止。
道具をつなぐ共通の決まりとして、Model Context Protocol(MCP)が広く使われています。公式資料は、AIアプリケーションを外部システムへつなぐオープンな標準規格で、電子機器のUSB-Cのように、接続のしかたを共通化するものだと説明しています。ファイル、データベース、検索、社内システムを同じ形式で差し込めるため、道具を増やすたびに専用の作り込みをする必要がありません。
ただし、道具を増やすことと、その道具をいつどの基準で使うかを教えることは別です。前者が接続、後者が手順にあたります。顧客管理システムを読める道具をつないでも、「失注しそうな商談を見つけて」という依頼はまだ実行できません。対象期間、失注とみなす兆候、売上をどの時点で見るか、重複した商談の扱い、根拠の残し方、誰に見せるかを決めて初めて仕事になります。この決めごとをまとめて再利用できるようにしたものが、七つの要素で挙げたスキルです。
スキルには、正常に進む場合の手順だけでなく、止まる条件も書きます。情報が食い違ったら質問へ戻す、対象が多すぎたら上位10件で止める、出典のない主張は成果物に入れない、外部への送信は確認へ戻す、といった内容です。
チャットに聞くのと何が変わるのか
いちばん分かりやすい違いは、終わり方です。チャットは回答を返した時点で終わります。エージェントの側は、成果物が完了条件を満たしたと確かめるか、人へ判断を戻すまで止まりません。
| 見る場所 | チャットへの質問 | AIエージェントへの依頼 |
|---|---|---|
| 渡すもの | 質問と、手元の資料 | 目的、完了条件、使ってよい情報源と道具 |
| 外部への働きかけ | 原則なし | 検索、ファイル読み書き、システム操作 |
| 途中の失敗 | 人が気づいて聞き直す | 結果を読んで手段を変える |
| 終わり方 | 回答を出した時点 | 完了条件を満たすか、人へ戻すまで |
| 残るもの | 会話の履歴 | 成果物、根拠、作業記録、未解決の項目 |
Anthropicの公式資料は、あらかじめ決めたコードの経路でモデルと道具が動くものをワークフロー、モデルが自ら進め方と道具の使い方を決めるものをエージェントと区別しています。つまり、道具を何個つないだかではなく、途中結果を見て次の一手を決めるのが人なのか、コードなのか、モデルなのかが分かれ目です。
一件の仕事が進む順序は、人の社員の動き方に似ています。役割と目標を受け取り、必要な情報源を開き、仕事を小さく分け、手順に沿って道具を使い、実行結果を読んで失敗なら直し、重要な判断だけ人へ確認を求め、成果物と記録を残す。モデルがすべてを知っている必要はなく、必要な情報と道具へ届き、途中結果で手段を変えられることが条件になります。
同じ依頼でどこから分かれるか
「競合3社の新機能を調べ、比較表と出典を作ってほしい」という依頼で考えます。チャットへ同じ文章を投げると、モデルが学習時点までに読んだ知識から比較文を組み立てて返します。速いのですが、いつの情報なのか、どの発表を根拠にしたのかは回答からは確かめられません。
エージェントは、調べ始める前に条件を固めます。対象はどの3社か、いつからいつまでの発表か、「新機能」は正式リリースだけか先行公開も含むのか、使ってよい情報源は公式発表に限るのか、完成形は表なのか文章なのか。決まっていない項目があれば、検索を始めずに質問へ戻します。
条件が決まったら各社の公式発表を探し、発表日、提供地域、対象プラン、機能の説明を項目ごとに保存します。見つからない項目は空欄のまま「未確認」と残し、3社で比較軸が揃わなければ検索語や参照先を変えて調べ直す必要があります。同じ発表を転載しただけの記事は重複として除きます。外部の結果を受けて次の一手を選び直すこの部分が、チャットとの実質的な違いです。
最後に、表の各行から根拠のURLへたどれるか、期間の外にある発表が混ざっていないか、製品名が公式の表記と合っているかを自分で検査します。合格しない行だけを調べ直し、それでも埋まらなければ未確認の項目を明記したまま人へ戻すのが正しい振る舞いです。この依頼を社外へ出す資料にするかどうかは、別の判断として人が決めます。
任せられる仕事の三つの型
任せやすい仕事には共通点があります。必要な手順を最初から全部は書けないが、途中の結果を見れば次にやることが決まり、できあがったものを検査できる、という三つです。この条件に合う仕事は、次の三つの型に分かれます。
| 型 | 具体例 | AIに任せる範囲 | 人が確かめる場所 |
|---|---|---|---|
| 集めて形にする | 競合3社の新機能を調べ、出典付きの比較表にする | 検索、一次資料の特定、項目の抽出、表の組み立て | 各行から根拠へたどれるか、対象期間から外れていないか |
| 突き合わせる | 届いた請求書を発注記録と照合し、差異の理由を付ける | 読み取り、対応する発注の特定、差異と欠落の指摘 | 保留にした行の判断、台帳への登録 |
| 振り分けて下書きする | 問い合わせを内容で分類し、返信案を作る | 分類、過去の対応例の参照、返信文の作成 | 分類の誤り、送信するかどうか |
集めて形にする型では、対象と期間と完成形式を先に固定するところが勝負どころです。「新機能」の定義や使ってよい情報源が曖昧なら、エージェントは検索を始める前に質問へ戻るべきです。見つからない項目を推測で埋めず「未確認」のまま残せるかどうかで、成果物の使えるかどうかが変わります。Web調査を任せる場合の道具の選び方と、取得漏れの確かめ方は「AIにWeb調査を任せるには」で扱っています。
突き合わせる型は、経理や総務の定型作業に多くあります。架空の請求書7ファイルで読み取りから台帳への登録まで通した検証では、金額の食い違いと発注番号の欠落を根拠付きで保留できました。一方、登録処理の作り方によっては、同じ請求が二重に記録されています。読み取りと判断を任せても、台帳への登録は別の仕組みと権限に分けた方が安全です。手順と失敗は「請求書照合はどこまでAIに任せられるか」にまとめています。
振り分けて下書きする型では、分類の対象を最初から広げないことが大切です。会議室の予約、売上集計、契約書検索のように行き先が違う依頼を一つの入口で受けるなら、どの仕組みへ渡す仕事かを最初に決める部分と、固定処理で済む部分を分けます。その分け方は「一つのAIチャットで社内業務を受ける」で整理しています。
自分の仕事がどの型に当たるかは、いま人が何に時間を使っているかで見当が付くはずです。資料を探して読んでまとめ直す時間が長ければ集めて形にする型、二つの一覧を照らし合わせる時間が長ければ突き合わせる型、届いたものを仕分けて返す時間が長ければ振り分けて下書きする型です。どの型にも当てはまらず、その場で相手と条件を詰めながら決めている仕事は、まだ人の側に残ります。
三つの型に共通するのは、調査や下書きまでを任せ、外部へ影響する最後の操作を分けている点です。成功したかどうかを検査できる成果物で止めると、失敗しても被害が広がりません。逆に言えば、成果物を見て良し悪しを判断するところは人に残る仕事です。任せる範囲が広がるほど、確認する目の重要さは増えます。
いまは任せない方がよい仕事
反対に、向かない仕事もはっきりしています。
第一は、元へ戻せず、その場で人の責任判断が必要な操作です。送金、医療や法務の判断、顧客への正式な通知、契約の締結が当てはまります。調査や下書きまでを任せ、最後の実行は人が押す形に分けます。
第二は、必要な手順を最初から全部列挙できる仕事です。毎月同じ形式のファイルを同じ場所へ集計する処理なら、通常のプログラムや自動化ツールの方が速く、安く、結果も揃います。Anthropicの公式資料も、複雑さは成果が実際に良くなるときだけ足すべきだと述べています。エージェントにすると、毎回モデルが手順を考え直す費用と、結果の揺らぎが加わるだけです。
判断に迷ったら、実行記録を見ます。人が直す場所が毎回同じ、使う道具の並びがほぼ一定、待ち時間の大半が考える時間ではなく決まった処理、という状態が揃っていれば、その工程は固定した処理へ戻す時期です。申込フォームの回答を表計算へ転記してチャットへ通知する、といった仕事が典型で、自動化ツールで組んだ方が結果も費用も安定します。候補の選び方は「転記と通知の自動化はどれを選ぶか」で比較しています。
第三は、できあがったものを検査できない仕事です。正解が一つに決まらず、根拠もたどれない依頼では、間違っていることに誰も気づけません。「うちの事業をどうすべきか」といった問いは、人が判断材料を集めるところまでで止めます。
三つとも、モデルの性能が上がれば解決する話ではありません。取り消せるか、手順を固定できるか、検査できるかという仕事の性質の問題です。
失敗はだいたい同じ四か所で起きる
うまくいかない事例は、原因の場所が限られています。
| 失敗の形 | 何が起きるか | 先に決めておくこと |
|---|---|---|
| 終わらない | 完了条件がないため、調べ続けるか、途中で勝手に終える | 成果物の形式と、満たすべき条件を依頼文へ書く |
| 途中で狂う | 判断を長くつなぐほど、前の誤りが後ろへ伝わる | 工程を短く切り、途中で前提を検査する |
| 権限が広すぎる | 読むだけのはずが、書き込みや送信まで届く | 読み取りと書き込みを分け、操作ごとに承認を置く |
| 再現できない | 途中経過が会話の中だけに残り、後から追えない | 成果物、参照元、実行した操作をファイルへ残す |
「途中で狂う」は、一つ一つの判断が悪くなくても起こります。判断を直列に10回つなぐと、各回が正しくても、最初の取り違えが後ろの9回へそのまま引き継がれるためです。出張手配なら、候補探しと旅程案の作成までをモデルへ任せ、予算計算と社内規程の照合は決まった計算で固定し、予約の確定は人へ戻す、という切り方になります。どこまでをモデルの判断に任せ、どこをコードで固定するかの境界は「AIが状況を見て次の行動を選ぶ」で詳しく整理しています。
「権限が広すぎる」は、外部から取り込んだ文章に指示が混ざっているときに厄介になります。Webページやメールの本文には、エージェントへ宛てた命令が仕込まれていることがあり、読むだけのつもりの作業が書き込みや送信まで届いてしまいます。OpenAIのCodexは、技術的に何ができるかを決める隔離環境と、実行前に人へ確認を求める承認規則という二層で制御し、既定ではネットワーク接続を無効にしていると公式資料が説明しています。読む仕事と書く仕事を分け、外部の文章をそのまま実行側へ渡さない設計は、製品を問わず共通の考え方です。権限と承認の具体的な設計は「AIにメールや顧客情報を安全に任せる」で扱っています。
導入前に確認する七つの問い
製品を選ぶとき、モデル名だけでは実力も危険性も分かりません。次の七つに答えられるかを見ると、任せられる範囲が具体的になります。
- 何を目標として受け取れるか。完了条件をどう書くのか。
- どの情報へアクセスできるか。社内のどのデータが読める設定になるのか。
- どの道具と外部システムを操作できるか。書き込みはどこまで可能か。
- 途中の状態をどう保持し、止まったところから再開できるか。
- 失敗をどう検知し、どこまで自分で直すのか。
- どの操作で人の承認が必要か。承認画面に何が表示されるか。
- 結果と根拠をどこに、どんな形で記録するか。
社内へ持ち込むときは、この七つを一件の仕事に当てはめて書き出します。先ほどの請求書照合なら、目標は「届いた請求書を発注記録と照合し、差異の理由を付けた一覧を出す」、読める情報は当月の請求書と発注一覧まで、操作できるのは読み取りと一覧ファイルの作成だけ、台帳への登録は別の承認付き作業、という形に収まります。記録に残すのは、どの請求書をどの発注と対応させ、なぜ保留にしたかという経緯です。
この書き出しで空欄が残る行があれば、そこでいったん導入を止めます。いま人が画面の間で転記している箇所は、道具の接続が足りていないしるしです。担当者によって結果がぶれるなら、手順と判断基準が足りていません。一業務から始めて承認と復旧まで作る進め方は「AIエージェントを一業務から安全に導入する」にあります。
費用は三つの層で見る
費用の見積もりでは、料金表の単価だけを見ると外れます。実際にかかるのは次の三つです。
一つ目は、モデルの利用料です。従量課金では、入力と出力の量に応じてトークン単位で課金されます。トークンは文章やコードを処理する単位で、同じ仕事でも読み直しと修正が増えれば合計は増えます。契約プランの利用枠に含まれる形の製品もあり、その場合は枠を超えたときの扱いが確認の対象です。1回あたりと月額の目安は、AI API料金計算に入力と出力のトークン数を入れると計算できます。
二つ目は、実行環境の費用です。エージェントを動かすサーバー、隔離環境、保存領域、接続先サービスの利用料が加わります。長く動かす仕事ほど、ここが効いてきます。業務系の製品では、利用者1人あたりの席数課金と、処理した件数や実行した回数で増える従量課金が組み合わさっていることも多く、どちらが自社の使い方で先に効くかを見積もっておいてください。
三つ目は、人の確認時間です。成果物を読んで採否を決める時間、失敗をやり直す時間、手順を直す時間が含まれます。導入初期はここが最も大きく、慣れるほど減ります。
やり直しの費用も忘れずに数えてください。安い単価のモデルでも、途中で何度も詰まって読み直せば合計は高くなります。逆に、単価の高いモデルが少ない往復で終えれば、一件あたりは安く済むこともあります。作成役と確認役を分けるべきかどうかも含め、分業の損得は「AIの分業はどこまで得になるか」で条件別に比べています。
最初の一件をどう選ぶか
最初に選ぶのは、外部へ影響を出さず、成果物を検査できる仕事です。指定した情報源の更新候補を5件出す、出典付きの調査メモを作る、問い合わせを分類して返信案まで作る、といった範囲が向いています。どれも成功したかどうかを人が短時間で判定できる仕事です。
一件を動かしたら、入力、参照した資料、使った道具、出力、失敗した理由を記録します。同じ場所で人が毎回直しているなら、それは手順か判断基準の不足です。直した内容を会話の訂正で終わらせず、次回も効く形へ戻すところまでが導入の作業になります。うまくいったかを本番前に測る方法は「AIエージェントの品質を本番前に測る」で扱っています。
任せる範囲を広げるのは、一件を再現できるようになってからです。社内の複数業務へ広げる段になると、共通の手順や接続をどう組み替えるかという設計が必要になります。その組み立て方は「AIエージェントに社内業務を任せる」で説明しています。
AIエージェントを見るときは、何を観測し、誰が次の行動を決め、何で完了を検証し、どこで人が止められるかを確認します。この四点を押さえれば、単発の回答機能、決まった手順を繰り返す自動処理、状況に応じて手段を変えるエージェントを区別でき、自分の仕事のどこに入れられるか判断できます。
参照リンク4件
2026年9月21日時点の公式資料を確認しています。仕様は更新される可能性があります。