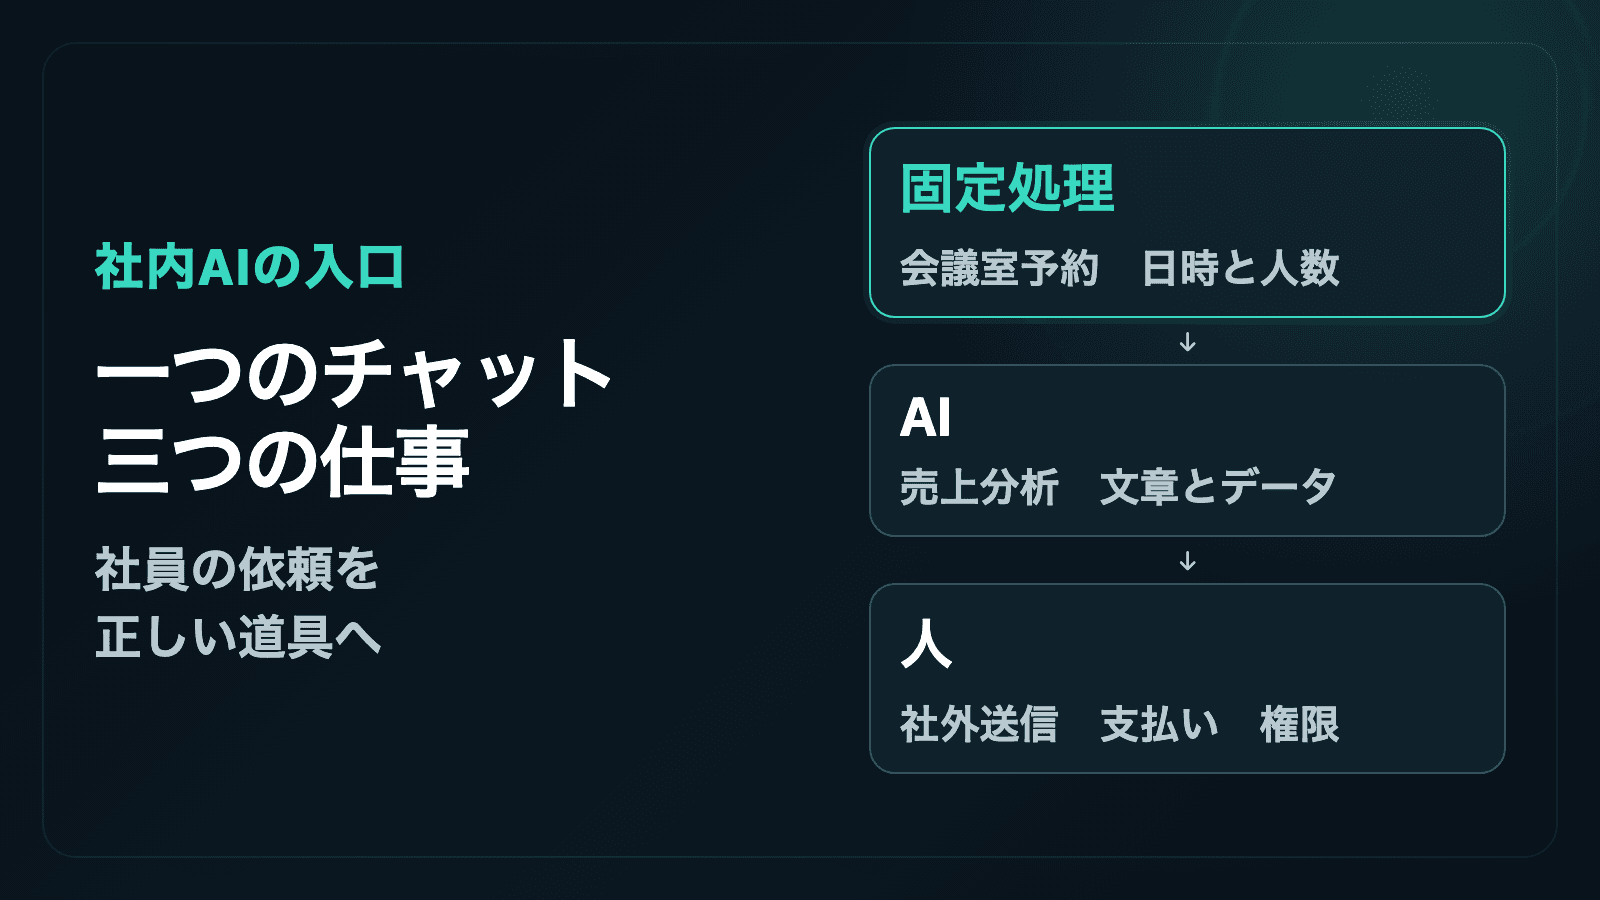
この記事は、会議室予約や売上集計など、複数の社内業務を一つのAIチャットから頼める仕組みを企画・開発する人に向けています。社員が文章を送った直後、AIチャットが選ぶ行き先は、予約システム、売上データ、文書保管庫のいずれか。選択を誤ると仕事が終わらず、送信や権限変更では影響が社外や会社のデータへ及びます。日時や人数だけで決まる予約は普通のプログラム、文章の意味を読む仕事はAI、重要な操作は人へ渡す分け方を説明します。
社員に見えるのは一つのチャットだけ
会社には、会議室を予約する画面、売上を見る画面、契約書を探す画面があります。これまでは社員が目的に合う画面を自分で選び、項目を入力していました。一つのAIチャットへ仕事を集めると、社員は最初にどのシステムを開くか考えず、やりたいことを文章で頼めます。
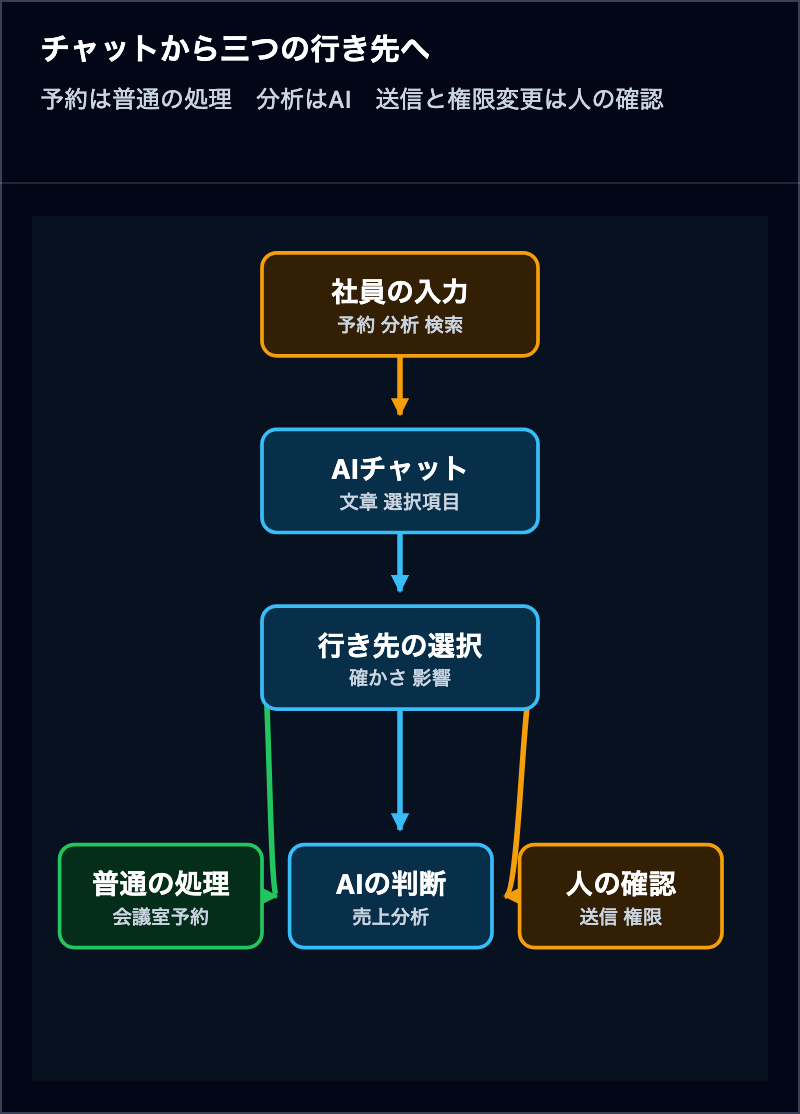
その代わり、画面を選ぶ仕事は裏側へ移ります。AIチャットは社員の文章を受け取ったら、最初に予約、集計、文書検索などの行き先を選ばなければなりません。必要な情報が足りなければ聞き返し、外部送信や権限変更なら人の確認で止めます。
たとえば、作業メニューで「会議室予約」が選ばれ、日時と人数もそろっていれば、普通のプログラムが空室を調べて予約できます。「売上が落ちた理由を知りたい」なら、AIが売上データや過去の報告を読み、何を比べるべきか考えます。「この見積書を取引先へ送って」なら、AIが宛先と文面を用意しても、送信ボタンは人が押す形にできます。
この記事が扱うのは、社員が文章を送った直後に、どの仕事へ渡すかを決める部分です。AWSは、一つのAI画面から専門のAI、道具、決められた業務処理へ仕事を渡す仕組みを「ルーティング」と説明しています。三つの役割を分ける鍵は、入力だけで行き先が一つに決まるかどうかです。
行き先が決まる仕事までAIに考えさせない
処理の手順と行き先が入力から決まる仕事は、AIより普通のプログラムへ渡します。作業メニューが会議室予約で、日時、人数、場所がそろっているなら、空室確認へ進むと決められるからです。同じ入力なら毎回同じ処理になり、なぜそこへ渡したかも説明できます。
2026年9月2日、Google DevelopersはAI Agents Challengeの参加チームが採用した三段階の処理を紹介しました。最初に正規表現で注文状況や予約取消のような定型入力を拾い、残りを低コストのGeminiで分類し、複雑なものだけを高性能モデルへ送っています。そのチームでは、最初の規則だけで受信メッセージの40%以上を処理しました。
ただし、40%はそのチームの入力と規則で得た数字です。別の会社が「四割をルールで処理する」と先に目標を置く根拠にはなりません。ルールを広げれば、処理できる件数と一緒に、違う行き先を選ぶ件数も増える可能性があります。
確かめるべきことは二つです。ルールだけで何件を処理できたか。そして、その処理先が人の判断と何件一致したか。この二つを分けないと、自動化が増えたのか、誤った分岐が増えたのか見えません。
単語は用件より先に目へ入る
文章を振り分けるとき、単語ルールは真っ先に浮かびます。「認証」と書いてあれば認証担当、「文書」なら文書担当へ送るという対応表なら、担当者も挙動を想像しやすく、実装も難しくありません。
ところが、単語が示すものは用件だけではありません。障害が起きた場所、使っていた道具、依存先、試した手順、エラーメッセージにも同じ語が混ざっています。
GoogleのAIエージェント開発用ソフトウェアには、利用者や開発者から不具合報告が届く公開ページがあります。そこにauth_credentialという部品名を含む報告がありました。認証の問題に見える件名に対し、保守者が付けた担当ラベルは中核機能。認証情報を扱う部品の中で起きた競合状態を直す仕事だったためです。
test(cli)で始まる報告も、コマンド操作の担当ではなく、道具を扱う担当へ分類されていました。別の報告では、プログラム上のTokenという語を認証用トークンとして拾えますが、実際の担当は処理の追跡です。
文章に出た単語は、どこで何を見たかを教えてくれます。それだけでは、次に誰が何を直すかまでは決まりません。
公開Issue 238件で単語ルールを試した
単語のずれが例外なのかを確かめるため、Google Agent Development KitのPython版に届いた公開Issueを使いました。Issueは、開発者が不具合や改善要望を投稿するページです。投稿には件名があり、保守者は文書、評価、道具、AIモデル、認証などの担当ラベルを付けています。文章と、人が決めた行き先を同時に確認できるため、今回の材料にしました。
2026年9月3日07:22 JSTにGitHubの公式窓口からデータを取得し、コード変更の提案であるPull Requestは除外しました。最初の38件だけを見てルールを作り、そこで固定したルールを、まだ見ていない238件へ当てています。
比べたのは三種類です。認証、文書、道具などの関連語を広く拾うルール。短い文字列が別の単語へ紛れ込まないよう境界を付けたルール。そして、docs:のように投稿者が種類を明示した場合と、OpenAPIという固有名がある場合だけを拾うルールです。
| 比較したルール | 処理先を確定 | 人のラベルと一致 | 全238件への適用率 | 確定した中の一致率 |
|---|---|---|---|---|
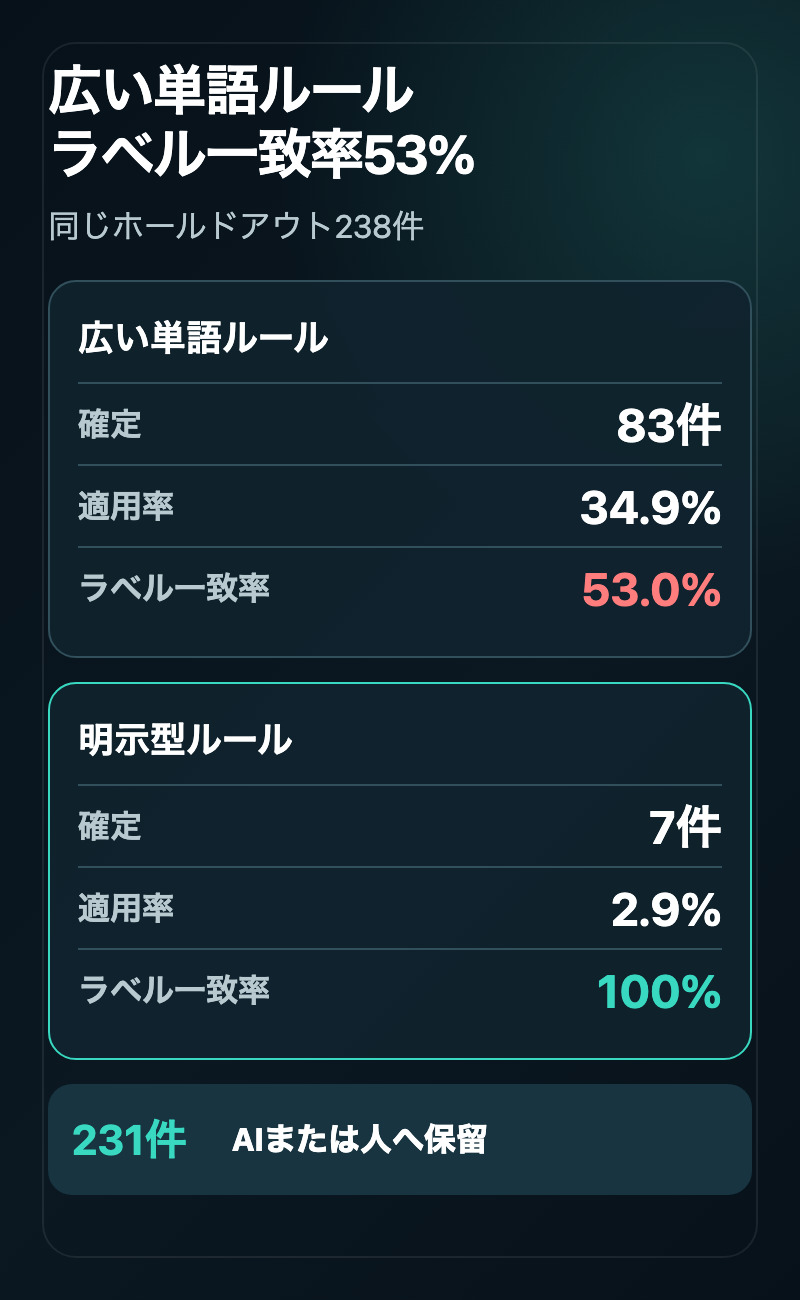
| 関連語を広く拾う | 83件 | 44件 | 34.9% | 53.0% |
| 単語の境界を付ける | 73件 | 35件 | 30.7% | 47.9% |
| 種類や固有名が明示されたものだけ | 7件 | 7件 | 2.9% | 100% |
広いルールが確定した83件のうち、人のラベルと一致したのは44件でした。不一致の39件中4件には比較できる担当ラベルがないため、誤りとは断定できません。それでも35件は別の担当ラベルが付いています。短い部分一致を防いだ後も一致率は47.9%で、文字列の実装を直すだけでは改善しませんでした。
明示されたものだけを拾う最後のルールは、文書3件とOpenAPI関連4件の計7件です。7件すべて一致しましたが、母数が小さいので、明示型なら常に100%になるという結果ではありません。見えたのは、頻出語より「投稿者が選んだ種類」や「行き先が一つに決まる固有名」の方が、確定ルールへ置きやすいという差です。
この比率を顧客対応や社内AIへそのまま移すこともできません。対象は英語の開発リポジトリ一つで、本文や会話履歴を読まず、件名だけを使った実験です。238件という数字は一般的な正解率ではなく、単語だけで行き先を決める危うさを調べた一例です。
確実な合図は入力時に受け取る
固定処理へ安全に渡せる範囲は、単語辞書を増やすより、社員から明示情報を受け取る方が広げやすくなります。
会議室の例なら、文章に「火曜」と書かれているだけでは足りません。新しい予約なのか、変更や取消なのかは別の話です。作業メニューで「会議室予約」が選ばれ、日時、人数、場所も確認できたとき、初めて空室確認の固定処理へ一意に渡せます。
明示情報の受け取り方はフォームだけではありません。専用の受付メールアドレス、社内AIで選ぶ作業メニュー、決められた件名の接頭辞、検証済みの契約番号でも構いません。Zendeskも、受付先、入力フォーム、言語、注文番号、製品種別などを、業務ルールの条件として使えると案内しています。
利用者が選択を間違えることはあります。固定処理の結果を修正できるようにし、別の処理へ送り直した件数を残します。次のルールを増やす根拠になるのは、目立つ単語ではなく、別の期間でも同じ条件から同じ行き先が決まった記録です。
AIは文章を読み人は影響を引き受ける
明示情報だけで決まらない文章は、AIが読む範囲です。「先月、関西の売上が落ちた理由を知りたい」と頼まれたら、売上データ、前年同月、営業報告などを照らし、調べる順序と回答案を作ります。参照すべきデータが分からない、依頼の意味が二通りある、過去にない仕事なら、そこで社員へ聞き返します。
Microsoft Q&Aが採るのは、AIが質問へ五つのタグ候補を出し、投稿者が一つを選ぶ方式です。公開後はモデレーターも正確さを確かめ、必要なら修正。つまり、AIは候補を出しますが、行き先を確定するのは人です。
支払い、契約、権限、社外送信に関わる依頼では、行き先が合っていても、その後の操作を人が承認します。文章の意味を正しく読めたことと、会社として実行してよいことは別の判断だからです。
三つの経路は最後に合流させます。固定処理、AI、人のどこを通っても、必要な情報がそろっているか、許可された処理だけか、結果と判断理由が記録されたかを同じ出口で確認します。Googleが紹介した別チームの事例でも、主モデルと代替モデルの出力を同じ検証関数へ通していました。
過去30件を三つの箱へ分けてみる
自社で始めるなら、実際に届いた文章を30件だけ並べます。30件で正確さを証明することはできませんが、自分たちの入口に何が届き、どこで判断に迷うかは見えてきます。個人情報や秘密は、検証へ持ち込む前に削除するか、扱える環境を用意してください。
表には「入力」「最終的に動いた処理」「人が送り直した理由」の三列を用意します。次に、一件ずつ三つの箱へ置いていきます。
- 入力項目だけで行き先が一つに決まるため、固定処理へ渡せる。
- 文章や履歴を読めば候補を出せるため、AIへ渡す。
- 情報が足りない、前例がない、影響が大きいため、人が決める。
判断が割れた文章は「未分類」のままです。無理に既存の箱へ押し込むと、評価用の記録そのものまで曖昧になります。
ルールを作った30件とは別の期間で試し、最初は実際の処理先を変えません。予測した行き先だけを記録し、ルールが確定した割合、人の最終判断との一致率、送り直した割合、行き先が決まるまでの時間を見ます。
最初から大きな自動化率を狙う必要はありません。今回、明示情報だけで確定できたのは238件中7件でした。それでも、なぜその7件を固定処理へ渡したかは説明できます。小さな確定経路を作り、AIと人が直した記録から、次に広げられる条件を探します。
参照リンク11件
- Google Developers Blog4 engineering patterns behind the strongest AI Agents Challenge submissions
- GitHub DocsREST API endpoints for issues
- GoogleAgent Development Kit
- GitHubgoogle/adk-python Issues
- GitHub APIgoogle/adk-python Labels
- GoogleWorkflow Triage Sample
- AnthropicTicket routing
- AWSルーティングのワークフロー
- ZendeskRouting and automation options for incoming tickets
- Zendeskインテリジェントトリアージについて
- Microsoft LearnQ&A 自動タグ付け
2026年9月4日時点の公式資料を確認しています。仕様は更新される可能性があります。