AIエージェントを業務へ入れるには、モデルの前後に受付、権限、承認、状態保存、記録、復旧を組み合わせた実行基盤が必要です。最初から完全自動化するのではなく、低リスクな一業務を依頼から結果確認まで通し、人が止められる小さな閉ループとして運用します。この記事では、その実行基盤を作る順番と、試験運用から対象を広げる判定基準を整理します。
一件の仕事を最後まで管理する枠組み
AIエージェントは、文章を返すだけでなく、資料を読み、外部サービスを操作し、途中結果を見て手段を変えます。便利さは、依頼者が複数の画面を行き来せず、目的と完了条件を渡せば一連の作業を任せられることです。
同じ仕組みは、誤った判断を外部の変更へ変える力も持ちます。たとえば問い合わせ対応を任せるには、顧客情報を読み、返信案を作り、送信先を選ぶ権限が欠かせません。未信頼のメールに悪意ある指示が含まれていたり、宛先を取り違えたりすれば、情報漏えいや誤送信へつながります。
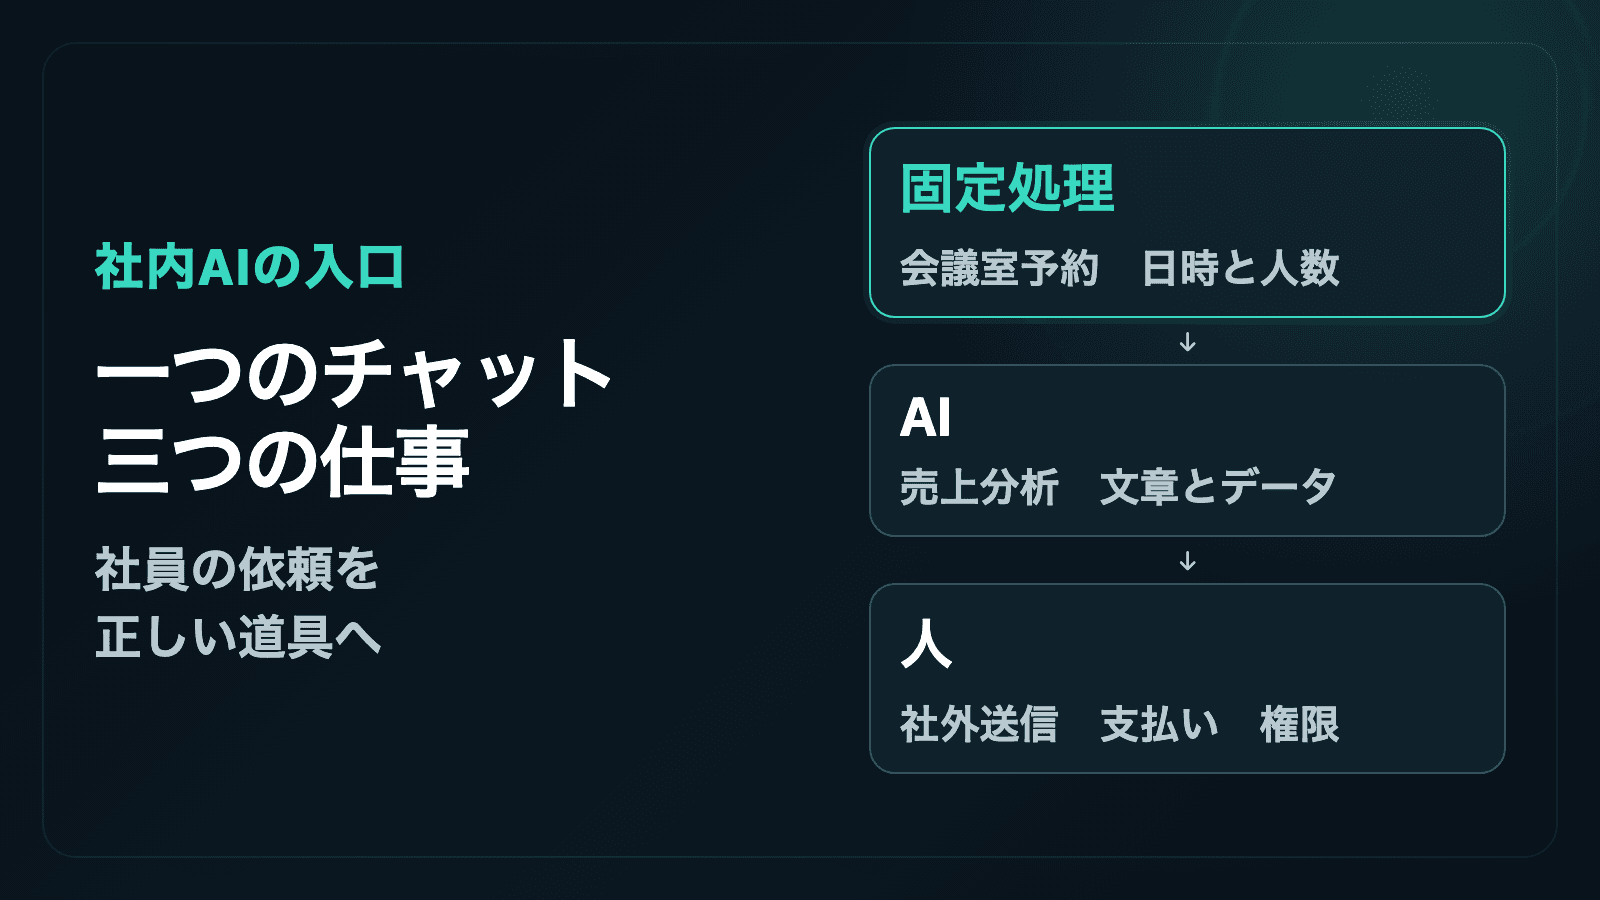
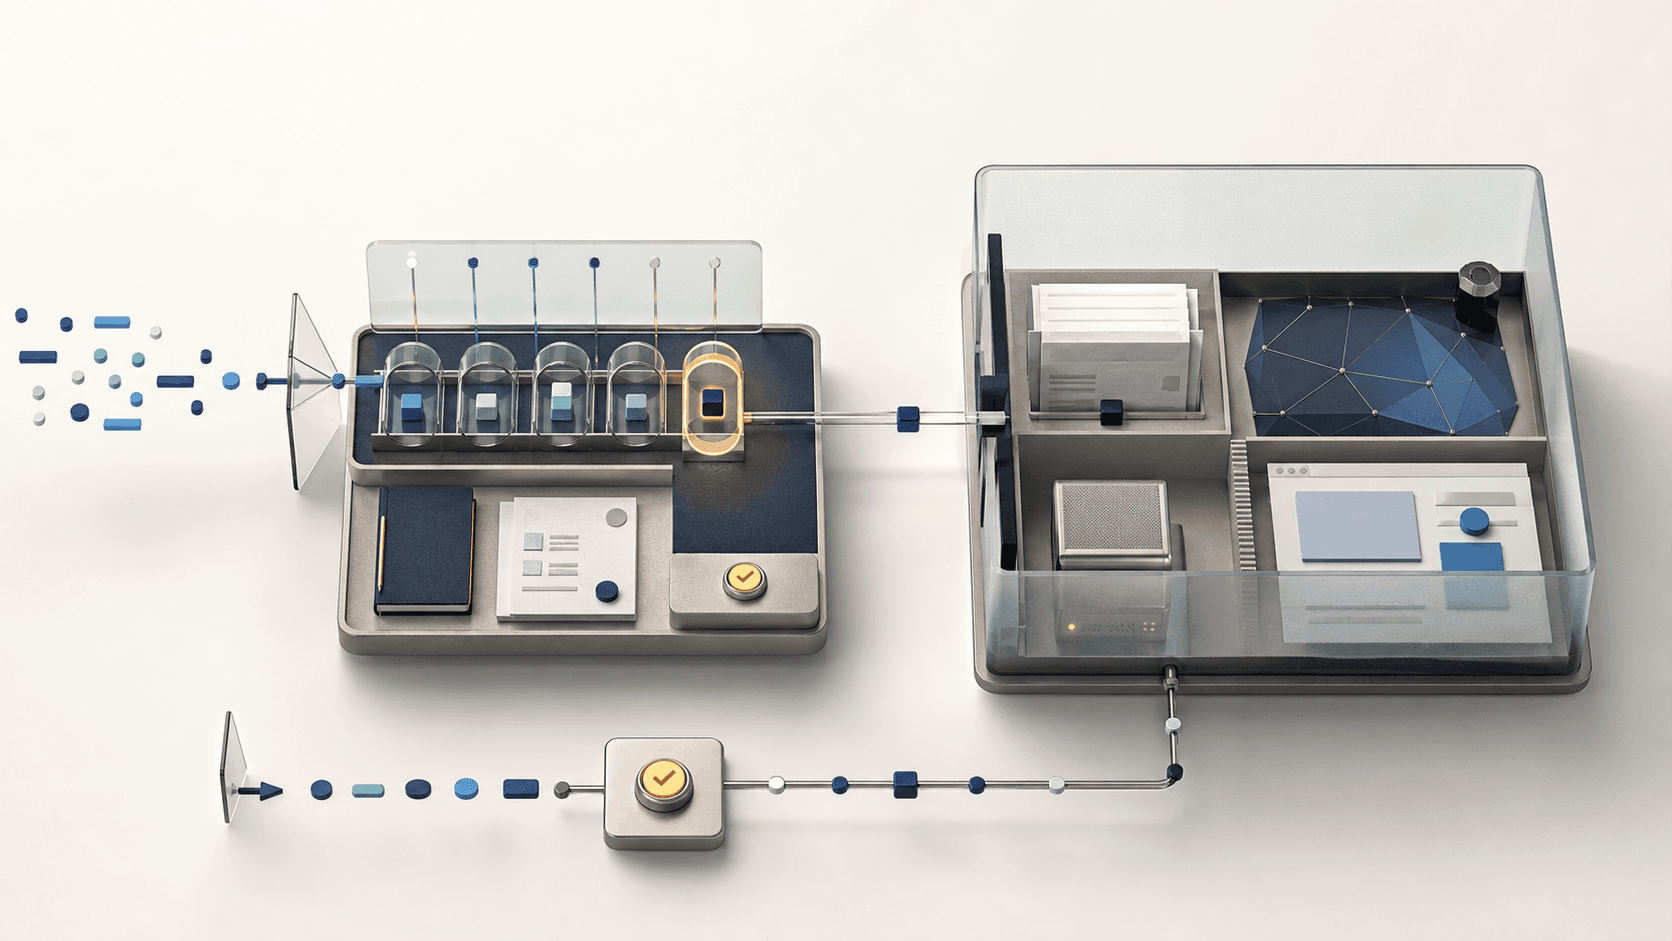
そこで必要になるのが、一件の仕事を受け付け、実行範囲を決め、途中状態を保存し、危険な操作の前で止め、結果を元データと照合する実行基盤です。この記事では、この実行基盤を業務ランタイムと呼びます。一般に「AIOps」と呼ばれるIT運用の分析・自動化とは対象が異なります。
業務ランタイムの役割
- 受付:依頼者、入力、完了条件を一件の仕事として保存する
- 権限:読める情報と実行できる操作を仕事ごとに限定する
- 承認:外部へ影響する操作の直前で対象と差分を確認する
- 状態保存:いまどこまで進み、次に何が必要かを残す
- 記録:読んだ資料、道具の引数、外部の結果を結び付ける
- 復旧:途中停止しても二重実行せず、安全な地点から再開する
最初に選ぶ一業務
最初の対象は、件数の多さより、完了と失敗を判定できるかで選びます。入力が特定でき、期待する成果物があり、失敗しても人が元へ戻せる業務が向いています。
| 最初の対象 | 自動化する範囲 | 最初に向く理由 |
|---|---|---|
| 指定資料の調査 | 出典付きメモの作成 | 根拠と成果物を照合できる |
| 問い合わせ対応 | 分類と返信案の作成 | 送信前に人が確認できる |
| コード修正 | 修正案とテスト | テストと差分で判定できる |
| 購入・送金・公開 | 情報収集と差分作成まで | 最終操作を承認後へ分離できる |
購入、送金、公開、削除、権限変更のように影響の大きい操作は、最初から自動実行しません。準備と最終操作を別の処理へ分けます。
試験運用の前に、次の五点を一枚へ書き出します。
- 誰が依頼できるか
- 何を入力として読めるか
- 何を完成とするか
- どの操作で人へ戻すか
- 失敗時に何を元へ戻せるか
この五点を決められない業務は、エージェントを導入する前に人の業務手順を整理する必要があります。
受付と実行の分離
依頼を受け取る処理は、長いAI処理をその場で始めず、一件の仕事として保存して実行待ちへ渡します。Webフォーム、Slack、メール、社内画面のどこから受けても、依頼者、入力、完了条件、期限、許可された操作を同じ仕事番号へ結びます。
会話履歴だけを保存しても、どこまで外部操作を終えたか、何を再実行してよいかは分かりません。仕事の状態と成果物を分けて残します。
保存する仕事の状態
- 受付済み・実行待ち・実行中
- 情報待ち・承認待ち
- 完了・失敗・中止
- 実行済みの操作と生成物
- 次に必要な入力と再開地点
Anthropicの長時間実行に関する検証でも、会話の圧縮だけでなく、作業一覧や進捗などの成果物を次の実行へ引き継ぐ構成が使われています。長く動かすほど、モデルの記憶へ任せず、外から読める状態を残すことが重要になります。1

権限と承認の置き場所
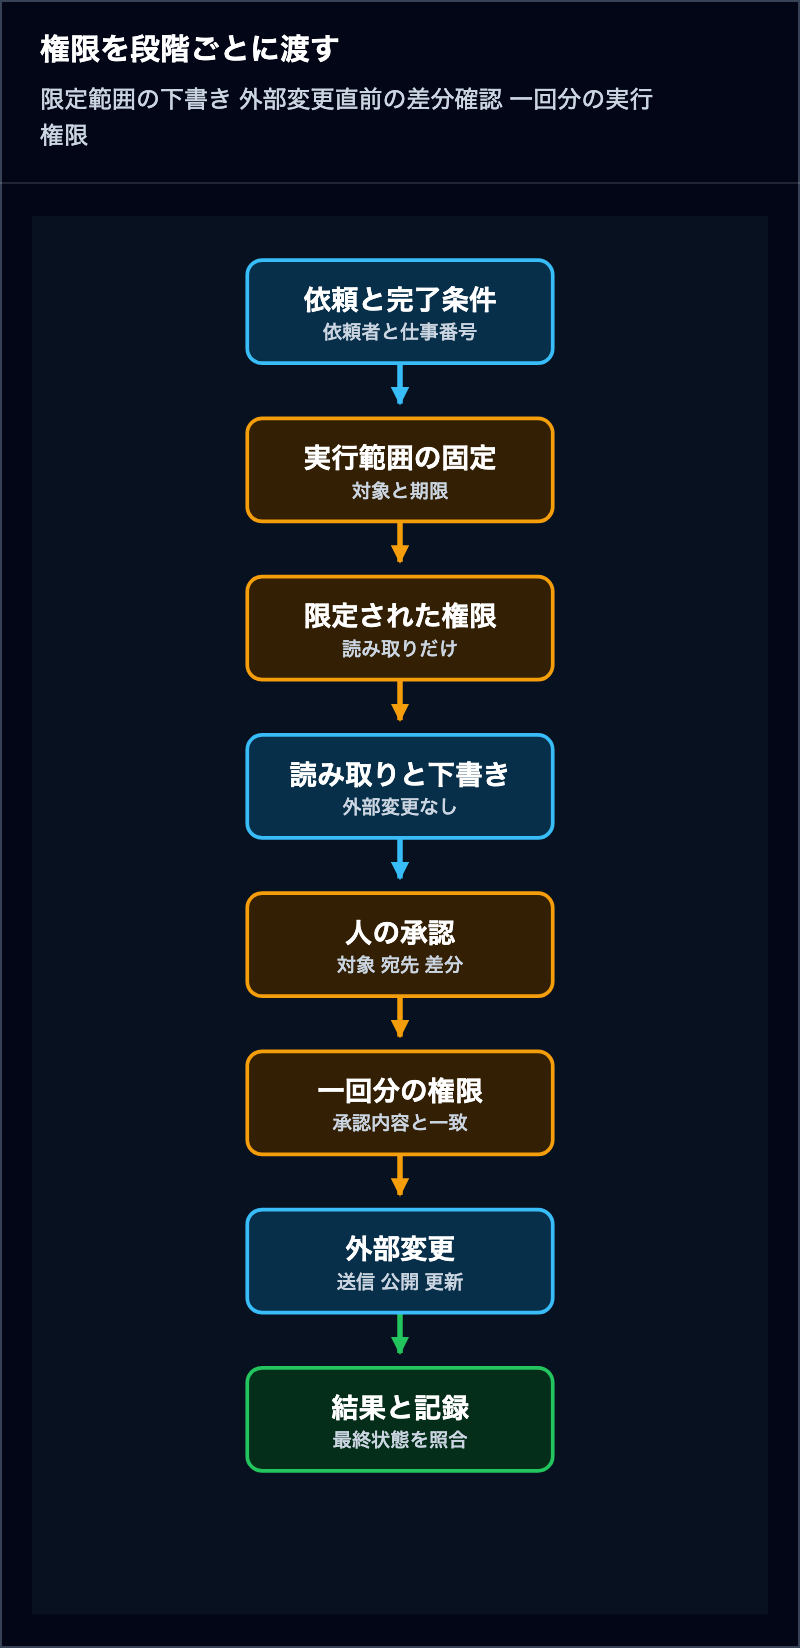
エージェントへ渡す権限は、役職名ではなく一操作の範囲で決めます。
- 調査:指定した保存先の読み取り
- 下書き:仕事用フォルダへの書き込み
- 公開・送信:承認後の一回だけ使える実行権限
- 顧客情報:対象の顧客IDと必要項目だけ
個人のブラウザ履歴、ホームフォルダ、全顧客のデータ、長期間有効な認証情報をまとめて渡しません。
承認画面に出すもの
- 誰の依頼か
- 誰へ何を送るか
- どの記録を変更するか
- 変更前後の差分
- 承認後に変わっていないことを確かめる値
承認後に宛先や本文が変わった場合は、同じ承認を使い回しません。
経済産業省のAI事業者ガイドラインは、環境とリスクの分析、目標設定、システム設計、運用、評価を継続するガバナンスを示しています。国内企業の実装例でも、人からエージェント、道具やデータへ続く認可、禁止する行動、人が判断へ入る位置、監視と評価が共通基盤の構成要素です。57
隔離された実行場所
エージェントがファイルを変更したり、取得したプログラムを動かしたりする仕事には、普段使う端末や本番環境から分けた実行場所が前提です。仕事ごとの作業フォルダまたは使い捨て環境を用意し、読み書きできる場所、接続先、利用時間、計算量を制限します。
実行場所へ置くものも、仕事単位で絞ります。
- 必要な入力ファイルと道具だけを置く
- 読み書きできるフォルダと接続先を固定する
- 認証情報を用途別に分け、短時間で無効にする
- 外部の文章やコードを未信頼入力として扱う
- 利用時間、計算量、外部通信へ上限を置く
隔離が狭めるのは失敗したときの到達範囲であり、成果物の品質までは保証しません。誤った成果物を作ること自体は防げないため、実行後に元データ、テスト、業務規則と照合し、完了条件を満たすかを確かめます。
記録と復旧
運用記録を残す目的は、後から一件の仕事を説明し、途中から再開できるようにすることです。同じ仕事番号へ次を結びます。
- 依頼と完了条件
- 使用した手順の版と参照元
- 道具の呼び出しと引数
- 変更差分と人の承認
- 生成物と外部の最終結果
モデルの内部推論を保存することより、何を読み、何を変更し、外部で何が起きたかを追えることが重要です。
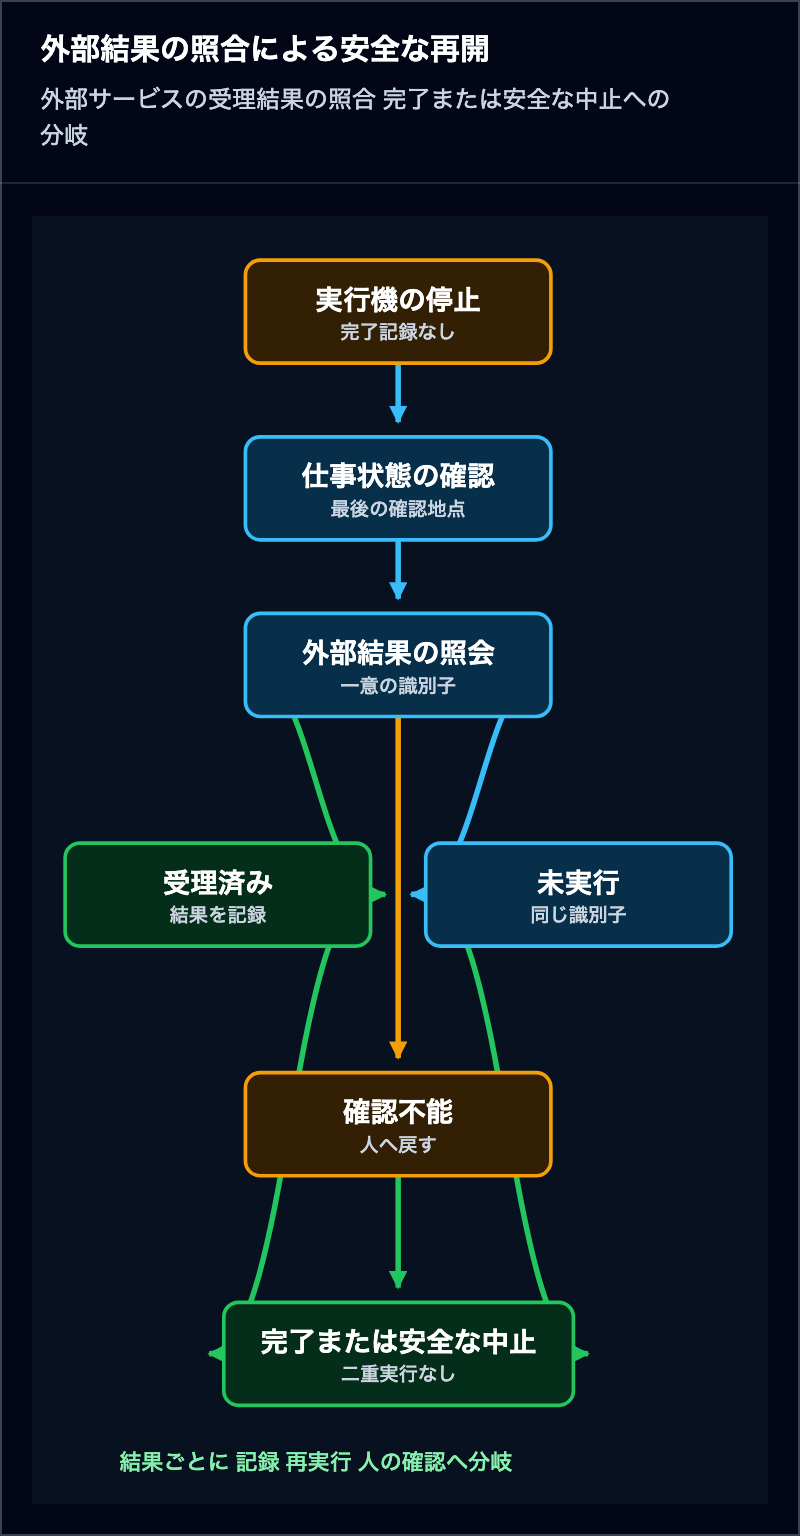
失敗時は、処理全体を最初から繰り返しません。最後に確認できた地点から再開し、同じ送信や登録を二重に行わない識別子を外部操作へ付けます。時間切れ、回数上限、費用上限、承認期限、強制中止を状態の一部にします。
OpenAIとAnthropicの実行基盤も、モデルそのものとは別に、実行の循環、操作の経路、記録、隔離環境を扱う構成です。製品ごとの実装は異なりますが、モデルを交換しても仕事の状態と証跡を残せる境界が運用上の要点です。234
一つの仕事番号を最後まで追う
問い合わせへの返信案作成を例にすると、一件の仕事は次の順に進みます。
- 受付:
job-1042を発行し、依頼者、顧客ID、受信文、契約情報、完成条件、禁止操作を保存する - 下書き:顧客情報を取得し、返信案と根拠を成果物として保存する
- 承認:宛先、件名、本文、参照した契約、変更前後の値を人へ見せる
- 実行:承認内容が変わっていないことを確かめ、
job-1042/send/1の識別子で送信する - 復旧:停止した場合は外部サービスへ識別子を照会し、受理済みなら記録だけを補い、未実行なら同じ識別子で再送する
外部側が同じ識別子の二重受付を防げない場合は、自動再送せず、送信結果の照合か人の確認へ戻します。
この例では、会話を保存するだけでは足りません。業務状態、承認した正確な引数、外部操作の識別子、外部の受理結果が揃って初めて安全に再開できます。ランタイムの価値は、正常時の自動化より、どこで止まっても「次に何をしてよいか」を機械と人が同じ記録から判断できることにあります。
試験運用から広げる基準
試験運用では、自動化率だけを成功指標にしません。まず二〜四週間、一つの業務で、人による処理とエージェントを使う処理を同じ完了条件で比べます。件数が少ない場合は期間を延ばし、通常例だけでなく、情報不足、重複依頼、外部サービスの停止、承認拒否も試します。
最低限追う指標は、次の五つです。
| 観点 | 確認するもの |
|---|---|
| 成果 | 完了率、重大な誤り、差し戻し率 |
| 時間 | 受付から完了まで、人の確認時間 |
| 安全 | 権限外の試行、承認前の外部操作、情報漏えい |
| 復旧 | 中断から再開できた割合、二重実行の有無 |
| 費用 | AI利用料、外部サービス料、人の作業時間 |
公開前に「一つでも該当したら広げない」条件を決めます。
- 権限外の読み書きが起きた
- 承認前に外部操作した
- 別の顧客や対象を変更した
- 送信や登録を二重実行した
- 意図的な停止から再開も安全な中止もできなかった
通常例の完了率、人の確認時間を含む一件の費用も基準処理と比較します。
合格線は業務によって違いますが、重大な安全条件を平均点で相殺しない原則は共通です。公開後に許容する失敗率から逆算せず、発生時の影響と検知・復旧可能性で重大条件を決めます。軽微な文章修正と、顧客データの誤更新を同じ「差し戻し一件」として数えません。
対象を広げるのは、通常例の平均が良いときではなく、重大な失敗を止められ、失敗理由が記録され、人が復旧できると確認できたときです。権限、対象部署、処理件数を一度に増やさず、一つずつ変えて再評価します。
承認を増やしすぎない
人の承認は安全策ですが、すべての道具呼び出しへ確認を置くと、処理時間の大半が待ち時間になり、確認者は差分を読まずに通し始めます。承認の回数が多いほど安全とは限りません。見るべきなのは、元へ戻せない副作用、権限の拡大、機密情報の外部送信、業務上の責任判断です。
同じ読み取り処理を毎回承認させる代わりに、許可されたデータ範囲と期間を最初に固定します。範囲内の取得は記録だけ残し、承認を集中させるのは外部へ影響する次の操作です。
- 元へ戻せない変更
- 権限の拡大
- 機密情報の外部送信
- 金額、宛先、公開範囲の決定
複数の小さな変更は、最終的な対象と差分を一つの承認画面へまとめます。途中で宛先、金額、公開範囲が変われば再承認します。
承認の働き方も、試験運用で測る対象です。
| 指標 | 読み取り方 |
|---|---|
| 人の確認時間 | 表示する情報が多すぎないか |
| 承認待ち時間 | 業務の停止点になっていないか |
| 却下率 | エージェントの判断や対象選択に問題がないか |
| 承認後の修正率 | 差分表示と完成条件が十分か |
ほぼ必ず承認され、確認後の修正もない項目は、自動検査へ移せないかを検討します。人を律速から外すには、承認を消すのではなく、機械で検査できる条件を増やします。
小さな閉ループから始める
AIエージェントの業務導入は、モデルを選んで画面へ置けば完了するものではありません。依頼を仕事として保存し、必要な権限だけを渡し、危険な操作の前で人へ戻し、隔離された場所で実行し、結果と変更を記録して初めて継続運用できます。
最初の成果は、一件の仕事について、誰の依頼で、何を読み、どこまで実行し、なぜ止まり、どう再開したかを説明できることです。無人で動き続けることは、最初の目標にしません。この小さな閉ループが安定すれば、次の業務へ同じ受付、承認、記録、復旧の仕組みを再利用できます。
参照リンク7件
2026年8月20日時点の公式資料を確認しています。仕様は更新される可能性があります。