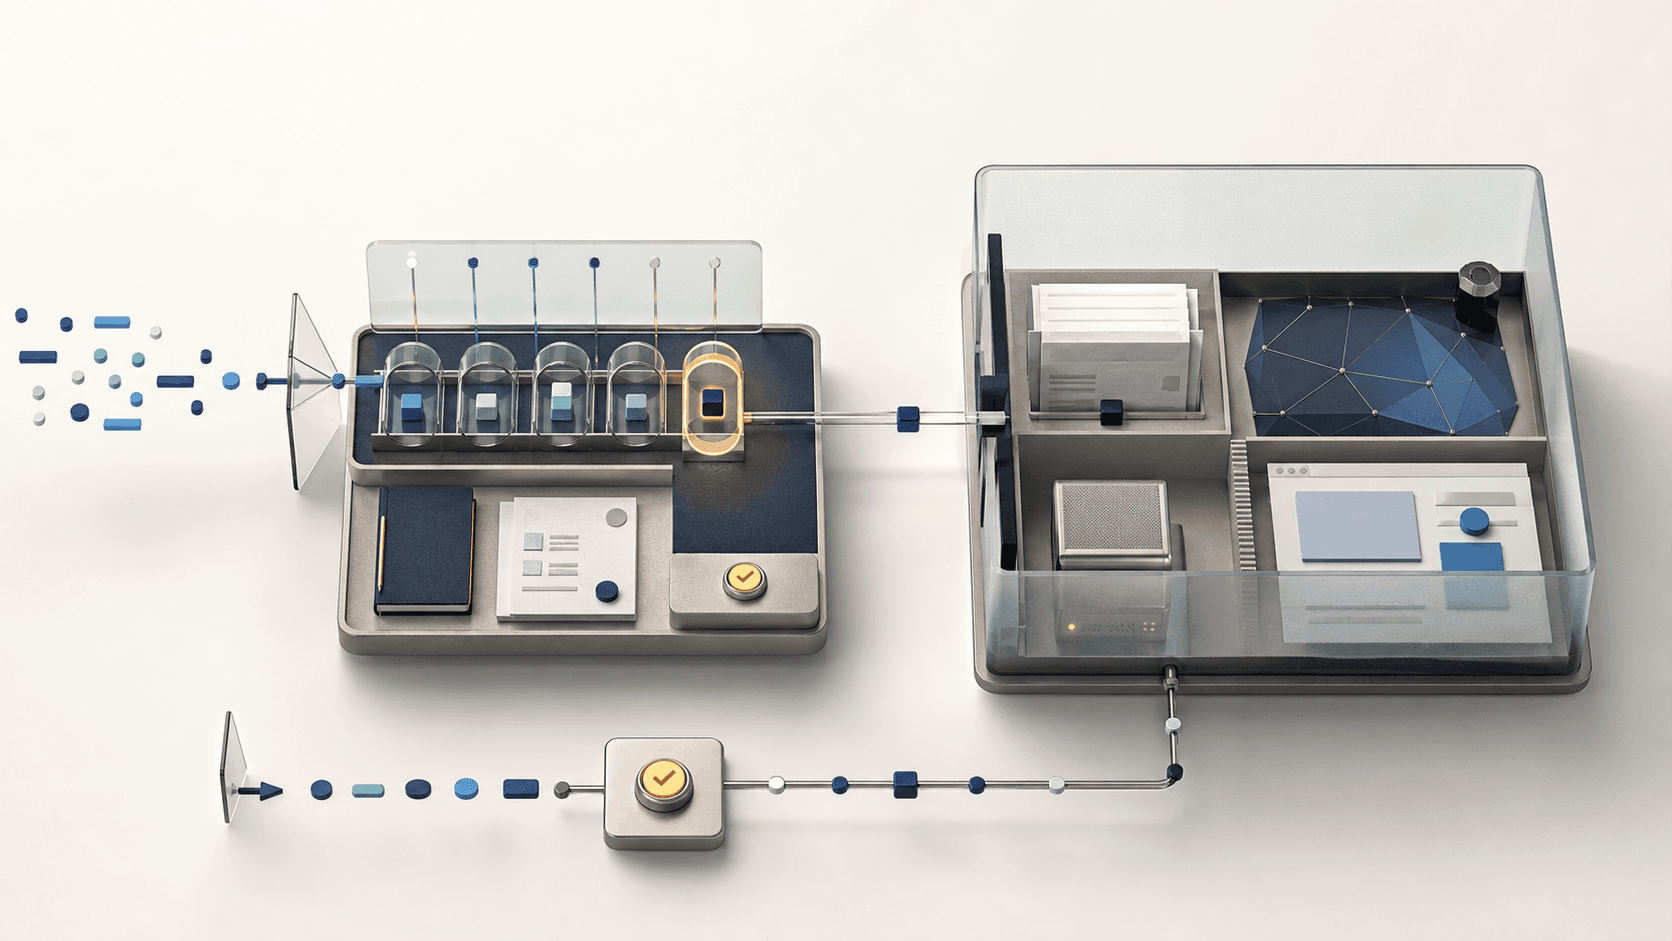
AIエージェントは、回答文だけでなく、外部の道具を使った過程と、最後に業務システムへ残った結果を評価します。一回の成功例ではなく、実際の仕事から作った評価課題を複数回実行し、変更前後の合格率、重大な失敗、時間、費用、人の修正量を同じ条件で比べるのが基本です。この記事では、小さな評価用データの作り方から採点、公開前の判定、本番の失敗を次の試験へ戻すところまでを説明します。
外部の結果まで含む評価
問い合わせ対応エージェントは、丁寧な返信を書くだけでは完了しません。顧客を正しく識別し、契約と過去の履歴を確認し、必要なら返金処理を行い、その結果を記録するところまでが仕事です。最終文面が正しく見えても、別の顧客を更新していれば失敗です。
AIエージェントは複数回にわたって道具を呼び、途中の結果で次の行動を変えます。一つの誤りが後の操作へ伝わるため、入力と最終回答の組だけでは原因を追えません。利用した資料、道具の選択と引数、外部システムの最終状態、人へ確認した位置を含む実行記録が必要です。
Anthropicは、評価課題、試行、採点方法、実行記録、最終状態、評価を動かす仕組みを分けて説明しています。「エージェントを評価する」ときは、AIモデルだけでなく、指示、道具、実行環境を含む全体を測るという考え方です。1
既公開記事「生成AIの失敗はどこで起きるか」は一件の失敗原因をモデル、文脈、検索、道具へ切り分けます。この記事が扱うのは、その失敗を再現できる評価課題へ変え、次の変更で同じ事故を防ぐ運用です。
完了条件から評価課題を作る
評価は「賢い」「自然」といった印象ではなく、実際の業務で何をもって完了とするかから始めます。返金対応なら、対象顧客が一致する、規定内の金額である、必要な承認がある、記録が一件だけ残る、利用者へ結果を説明する、といった条件です。
最初から数百件を集める必要はありません。Anthropicは初期段階の目安として、実際の失敗や要件から作った20〜50件の単純な課題を挙げています。件数そのものを基準にするのではなく、通常例、境界例、情報不足、拒否すべき依頼、道具の失敗、悪意ある入力を含めます。1
OpenAIの評価手順も、仕事の定義、テスト入力での実行、結果分析と改善という三段階で、評価データの形式と採点基準を分けて示す構成です。23 道具を使うエージェントでは、回答文だけでなく外部システムの最終状態までが検査対象になります。
各課題には、次の情報を持たせます。
- 利用者からの依頼と初期状態
- 利用できる資料と道具
- 完了後に成立してほしい状態
- 絶対に起きてはいけない状態
- 採点方法と合格点
- 既知の正しい実行例
期待される操作だけを入れると、何でも実行するエージェントへ偏ります。「検索すべき例」と「検索しない例」、「確認を求める例」と「そのまま進める例」を対にすれば、不要な行動も失点にできます。
採点方法を組み合わせる
採点は、プログラム、人が定めた基準に沿って判定するAI、人の確認を組み合わせます。確実に検査できる項目を先にプログラムで調べ、意味や表現の判断だけを後段へ残します。
| 採点方法 | 向いている対象 | 注意点 |
|---|---|---|
| プログラム | 計算、形式、テスト、データベースの最終状態 | 意味のよさは拾いにくい |
| 判定用AI | 根拠との整合、説明の網羅性、会話の品質 | 人の判定と定期的に照合する |
| 人 | 重要な例、専門判断、判定用AIの校正 | 費用と時間がかかる |
正解を一つの文章へ固定すると、別の正しい方法まで誤って不合格にしかねません。外部操作を含む仕事では、途中の手順を細かく縛るより、許可された範囲で目的を達成し、禁止した状態を作っていないかを重く見ます。ただし、承認を飛ばす、権限外の情報を読む、根拠を捏造するといった禁止事項があれば、結果が正しくても不合格です。
判定用AIには、評価項目と合否例を渡します。その判定が専門家と一致するかを定期的に確認し、特定の長さや言い回しを好む偏りがあれば基準を直します。AIによる採点を、正解そのものとして扱いません。
一回の成功と再現性を分ける
同じ入力でも、AIエージェントの行動は毎回同じになりません。一回だけ成功した課題と、繰り返して安定して成功する課題を分けて見ます。
候補を複数作り、そのうち一つが成功すればよい仕事では、複数回のうち少なくとも一回成功する割合が役立ちます。顧客対応や外部操作のように毎回の成功が必要な仕事では、複数回をすべて成功できるかが重要です。試行回数を増やすと前者は上がり、後者は下がるため、同じ「成功率」として混ぜません。1
小さな評価用データでは一件の偶然が全体を大きく動かすため、新旧の構成を同じ課題、同じ道具、同じ実行環境、同じ上限で複数回走らせます。数ポイントの差だけでは結論を出せません。どの課題で、どの種類の失敗が増減したかを実行記録まで読みます。
品質と退行を別の集合で見る
評価用データは、まだできない仕事を測る集合と、以前できた仕事を守る集合へ分けます。前者は能力を伸ばすための課題で、最初は合格率が低くても構いません。後者は、過去の不具合や重要な通常例を集めた退行防止の課題で、ほぼすべての合格が前提です。
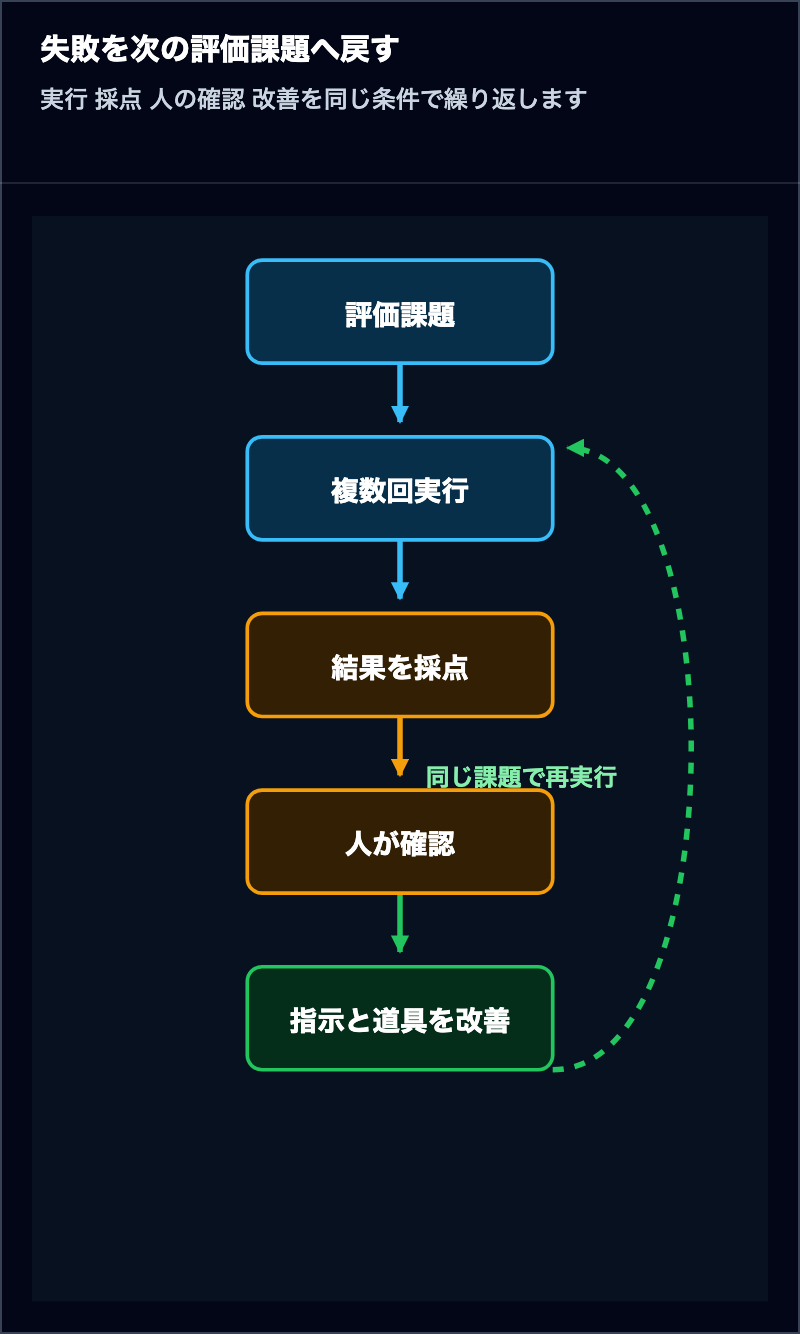
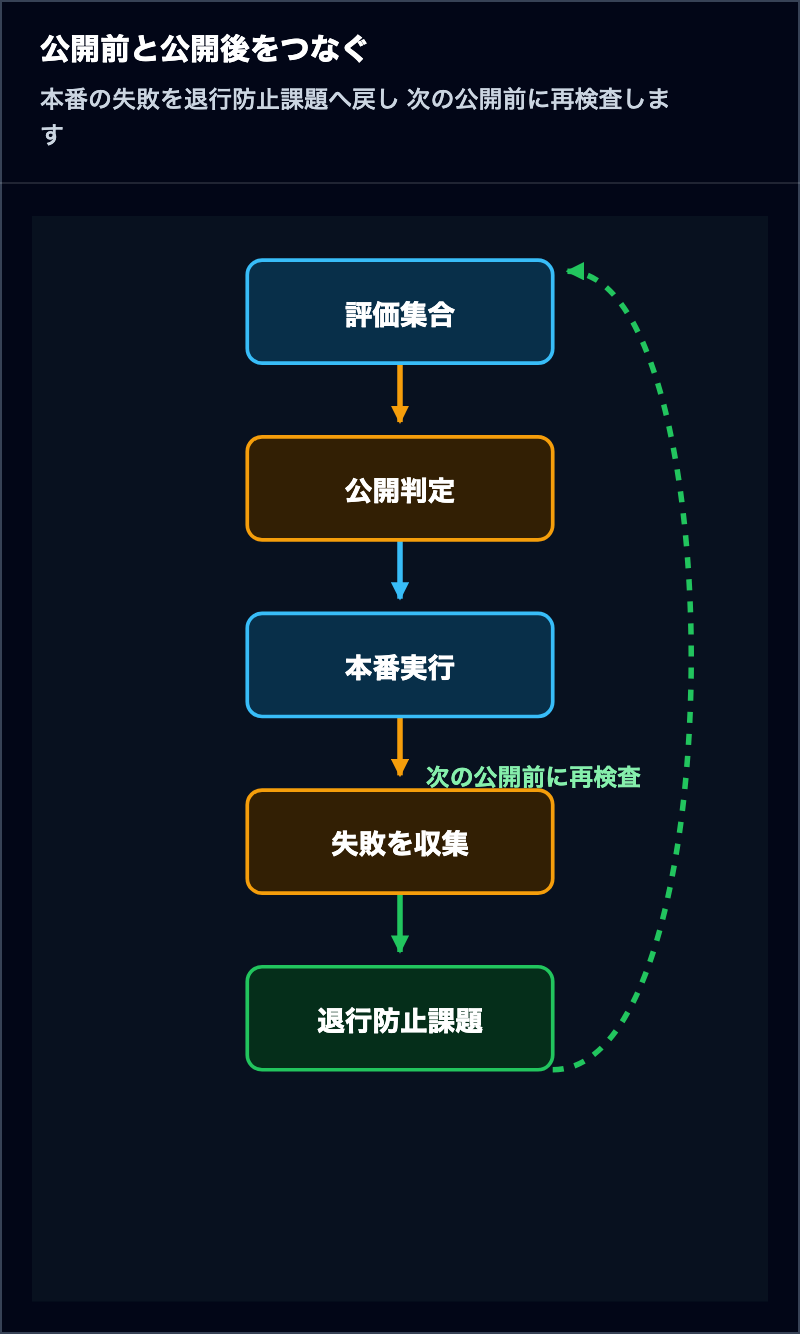
本番で起きた失敗は、個人情報や認証情報を除き、再現できる初期状態と依頼へ直して退行防止の集合へ加えます。修正後にその一件だけでなく全体を再実行し、別の仕事を悪化させていないかを確かめます。
評価用データの内容を日々の調整へ使いすぎると、その集合だけに合う構成になります。開発中に使う集合と最終判定まで見ない保留集合を分け、新しいモデル、指示、道具、検索方法を採用する前に、保留集合と安全上の必須課題で退行がないことを確認します。
一件の返金失敗を評価課題へ変える
本番で「同姓の別顧客へ返金を登録した」という失敗が起きたとします。会話文だけを評価用データへコピーしても再現できません。二人の顧客、注文履歴、返金規程、利用できる検索道具、承認状態を、失敗時と同じ初期状態として小さな検証環境へ作ります。個人情報は架空値へ置き換えますが、取り違えを起こした曖昧さは残します。
合格条件は「説明が丁寧」ではなく、注文番号と顧客IDが一致し、返金額が規程内で、必要な承認を取得し、正しい注文へ一件だけ記録が残ることです。禁止条件には、別顧客の情報を読む、承認前に変更する、同じ返金を二度作る、根拠のない注文番号を補うことを置きます。最終文面は判定用AIや人が見ても、顧客IDとデータベースの最終状態はプログラムで検査できます。
この課題だけを直すと、モデルが「同姓なら必ず質問する」という過剰な規則を覚える恐れがあります。そこで、注文番号だけで一意に特定できる例、同姓だが別地域の例、顧客は一人でも注文が複数ある例、検索結果が一時的に空になる例を対にし、正しく進む能力と止まるべきときに止まる能力を同じ集合で測ります。
変更前後を各課題で複数回実行し、重大な誤更新は一件でも公開不可、通常例の合格率は基準以上、人の確認時間と費用は許容範囲という門を置きます。合格率の平均が上がっても、別顧客への変更が一度でも増えた版は採用しません。一件の事故を、再現可能な初期状態、機械で見られる最終状態、公開を止める条件へ変えるところまでが評価ループです。
時間 費用 人の負担を同時に測る
正確さだけを最大化すると、毎回最も高価なモデルを使い、何度も検索し、すべてを人が確認する構成が勝ちます。業務として続けるには、品質を満たした構成同士で、完了までの時間、AIと外部サービスの費用、人の確認時間を比べることが欠かせません。
一件の実行について、少なくとも次を記録します。
- 仕事の完了と重大な失敗
- 道具の選択、引数、失敗、再試行
- 最初の応答と全体の所要時間
- AI利用量、外部サービス料、再試行を含む費用
- 人が修正した箇所と確認に使った時間
- 中止、情報待ち、承認待ちの理由
平均だけではまれに極端に遅い処理や重大な誤りが隠れるため、中央値に加えて遅い側の値を見て、重大な安全違反は平均点と相殺しない合否条件にします。
公開前の評価を運用へ戻す
公開前の評価は、変更を実利用者へ出す前に同じ課題を繰り返せる点が強みです。公開後の監視は、想定していなかった入力や環境変化を見つける点が強みです。どちらか一方では足りません。
公開前には、自動評価、重要例の人による確認、権限と承認の試験を行います。公開後には、失敗率、時間切れ、道具のエラー、承認拒否、利用者からの差し戻しを監視し、定期的に実行記録を抜き取って読みます。大きな変更は一部の利用だけへ出し、業務成果が改善するかを確認してから広げる進め方が安全です。6
情報処理推進機構の導入・運用ガイドラインも、生成AIの性能評価が通常のシステムより難しく、導入担当と運用担当が協力して基準を作る必要を説明しています。経済産業省と総務省のAI事業者ガイドラインは、運用と評価を一度で終わらないガバナンスの循環として位置付けています。45
評価ループ自体を保守する
評価用データも古くなります。規程、商品、道具、利用者の入力が変われば、以前の正解が現在の業務成果と一致しないことがあります。各課題へ作成理由、参照した規程の版、最後に人が確認した日を持たせ、根拠が失効した課題を更新または廃止します。
退行防止の集合へ失敗を足し続けると、実行時間と費用が増え、似た例が結果を支配するようになります。同じ原因を持つ課題を分類し、代表例は毎回、残りは定期実行へ分けます。重大な安全例は削らず、通常例の構成比も本番から離れないようにします。集合の大きさではなく、失敗の種類と利用分布をどれだけ覆っているかが管理の対象です。
採点器も版を持つ製品です。判定用AIのモデルや指示を変えたら、専門家が合否を付けた固定例で校正します。自動採点が上がっても、本番の差し戻し、再問い合わせ、処理完了が改善しないなら、測っている代理指標がずれている証拠です。その項目を増やすのではなく、業務成果へ近い最終状態の検査へ置き換えます。
評価の保守責任も決めておく必要があります。誰が本番失敗を課題へ変え、誰が古い課題を見直し、誰が公開を止めるかが不明なら、評価は一覧表で止まります。評価ループが健全かどうかは、課題件数ではなく、失敗から再現例までの時間、古い根拠を持つ課題の割合、人と自動採点の不一致、公開後に初めて見つかった失敗の種類で確認できます。
失敗を再現できる資産へ変える
評価ループの目的は、点数の表示ではなく、失敗を再現できる課題へ変え、原因をモデル、指示、検索、道具、権限、実行環境へ切り分け、修正による退行を公開前に見つけることです。
最初の一週間は、実際の仕事から20件前後を選び、完了条件と禁止事項を書き、確実に検査できる項目だけを自動化すれば十分です。人が実行記録を読んで判定し、繰り返し現れる観点から採点を増やします。評価項目の数より、誰が失敗を課題へ戻し、誰が修正し、どの基準で公開を止めるかを決める方が先です。
AIエージェントの品質は、モデル名だけでは説明できません。同じモデルでも、道具、権限、入力、実行環境で結果は変わります。評価用データと実行記録をチームの共有資産にすれば、モデルや実装を変えても、業務で守るべき合格線を持ち続けられます。