生成AI製品の品質は、一件の失敗を正しい場所へ戻せるかで決まります。古い料金プランを案内した一件を追い、検索、文脈、指示、モデル、道具、評価を実行記録から切り分ける方法を説明します。
失敗をモデル名へ直結させない
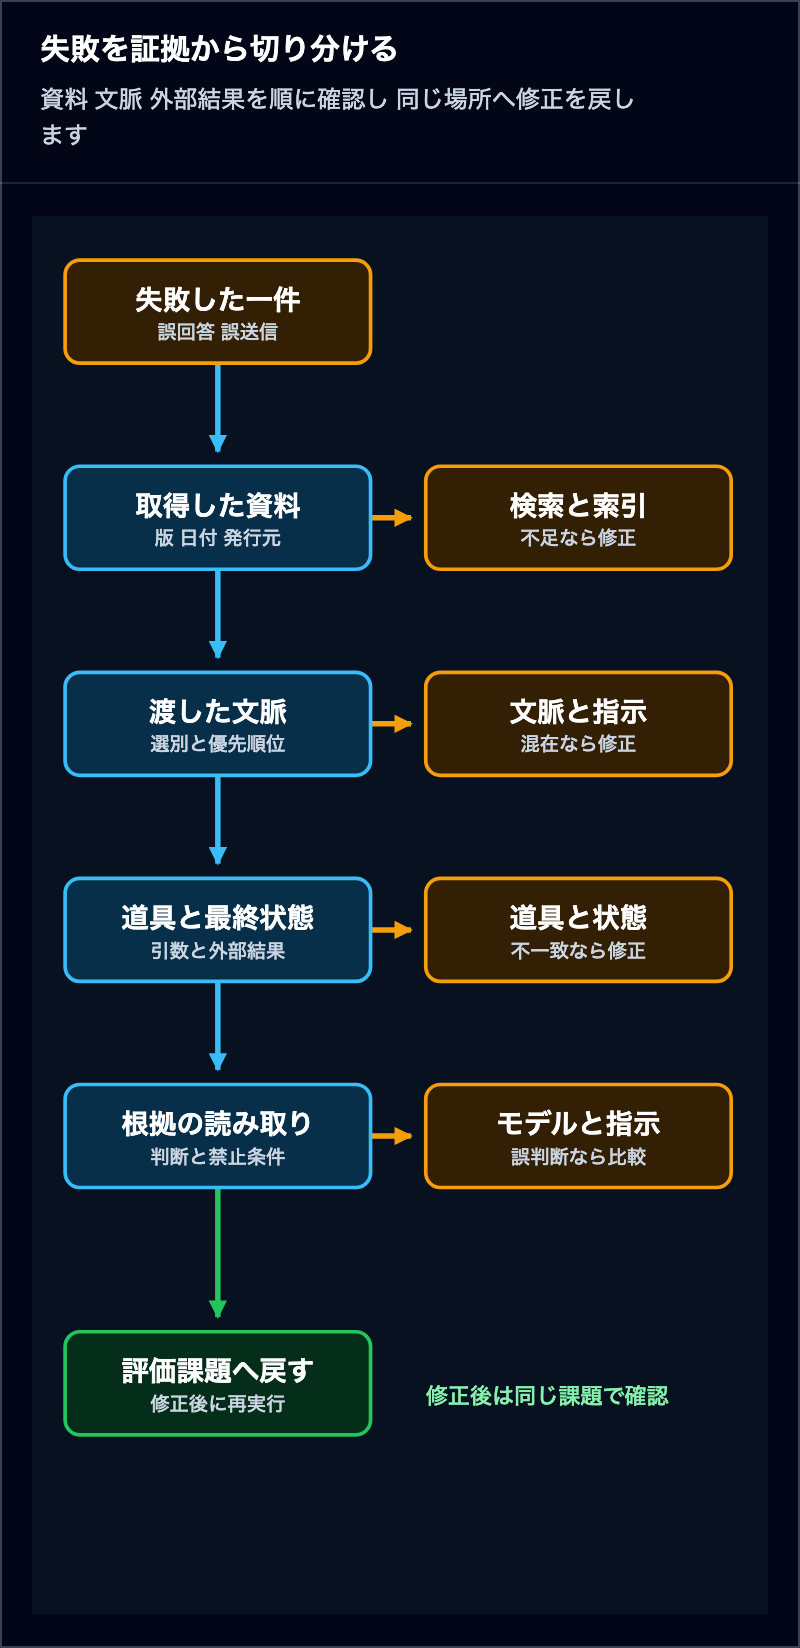
問い合わせAIが、すでに終了した法人向けプランを案内したとします。画面に見える失敗は一つでも、原因は同じではありません。
- 検索漏れ。最新版が検索結果に入っていない。
- 版の選択ミス。最新版はあるが旧版を選んだ。
- 文脈の混在。新旧両方を、優先順位なしでモデルへ渡した。
- 根拠の読み違い。正しい資料から誤った値を抜いた。
- 外部操作の誤り。値は正しいが、別の顧客や宛先へ送った。
検索漏れなら索引を直し、版の混在なら文脈を直し、顧客の取り違えなら道具と事前検証を直します。最新版を取得できていないのにモデルだけを強くしても、答えは改善しません。
OpenAIの現行モデル利用指針も、代表的な仕事で構成を比較し、指示、例、道具を一群ずつ変えて同じ評価を再実行する方法を示しています。1
一件の誤案内を実行記録から追う
利用者の質問は「現在使える法人向けプランと解約条件を教えてください」です。製品は次の順に仕事を進めます。
- 公式資料を検索する
- 今回必要な箇所をモデルへ渡す
- 回答案を作る
- 顧客情報と送信先を確認する
- 返信し、外部サービスの結果を記録する
誤回答が起きたら、この順番を前からたどります。
| 観測した事実 | 主に疑う場所 | 最初に試す修正 |
|---|---|---|
| 最新資料が検索結果へ入っていない | 検索と索引 | 更新時刻、対象範囲、取得元を直す |
| 新旧資料を区別せずモデルへ渡した | 文脈 | 有効日と優先順位を構造化する |
| 正しい資料から誤った値を選んだ | モデルと指示 | 抽出形式、例、モデルを一つずつ比較する |
| 値は正しいが別の顧客へ送った | 道具と状態 | 顧客IDの選択と送信前検証を直す |
| 禁止条件を満たすのに送信した | 評価と承認 | 送信を止める決定論的な検査を置く |
残すべき記録
- 検索語と、取得した文書のURL・版・有効日
- モデルへ実際に渡した抜粋
- 道具の名前、引数、返り値
- 生成した回答と送信前検査
- 外部サービスで確定した最終状態
最終回答だけでは、誤った資料から文章を作ったのか、正しい回答を誤った宛先へ送ったのかを区別できません。原因の切り分けに必要なのは、何を読み、どの値を渡し、外部で何が起きたかを再現できる記録です。
検索と文脈を分けて調べる
検索と文脈は、似ていますが役割が違います。
| 層 | 役割 | 典型的な失敗 |
|---|---|---|
| 検索 | 必要な資料を候補へ入れる | 最新版が候補にない |
| 文脈 | 候補から今回の判断材料を選ぶ | 最新版はあるが旧版だけを渡す |
この二つをまとめて「情報不足」と呼ぶと、同じ事故を繰り返します。対策の第一歩は、文書へ次の項目を持たせることです。
- 発行元と文書番号
- 公開日と有効開始日・終了日
- 対象製品、地域、顧客区分
- 置き換え前後の版
検索では本文の類似度だけでなく、現在有効か、公式資料か、対象が一致するかで絞り込み、モデルへ渡すときにも新旧資料を長文のまま並べず、現行版と失効版を構造化して示します。
Anthropicは、文脈を有限の注意資源として捉え、必要な情報をその都度取得する構成を説明しています。3 資料の価値を決めるのは量ではなく、今回の判断に必要な証拠の密度です。
道具は外部操作の契約になる
道具は、モデルの判断を検索、計算、顧客情報の取得、送信へ変える接点です。人向け画面を自由文で操作させるのではなく、業務上の一操作を明確な引数へ分けます。
たとえば送信道具で別項目にするのは、次の五つです。
- 顧客ID
- 宛先
- 件名と本文
- 承認番号
- 二重実行を防ぐ識別子
Anthropicは、エージェント向けの道具を、決定論的なソフトウェアと非決定論的なモデルの間の契約として説明しています。4 OpenAIの関数呼び出しも、引数の形を定義し、アプリケーション側が実行結果を返す構造です。5
道具の採点基準
- 正しい道具を選んだか
- 引数は元データと一致するか
- 同じ操作を二重実行していないか
- 失敗後に安全に停止・復旧したか
文章の品質と外部操作の品質は、別々に採点します。
モデルを疑う条件
モデルを比較するのは、次の前提がそろった後です。
- 必要な資料を取得できている
- 正しい版だけが文脈へ入っている
- 道具の定義と実行環境が固定されている
- 同じ入力と条件で失敗を再現できる
この状態でも、根拠にない値を補う、禁止条件を無視する、同じ比較を繰り返し誤るなら、モデル能力、推論設定、指示、例を比較します。
一回の成功よりも、重要な仕事を繰り返しても禁止条件を守れるかを見ます。顧客への返信や外部更新では、偶然の成功より再現性が問われるためです。
モデルを替えるときは、指示や検索方法を同時に変えません。基準構成と候補構成へ同じ課題、文脈、道具、上限を渡し、失敗の種類ごとに差を確かめます。1
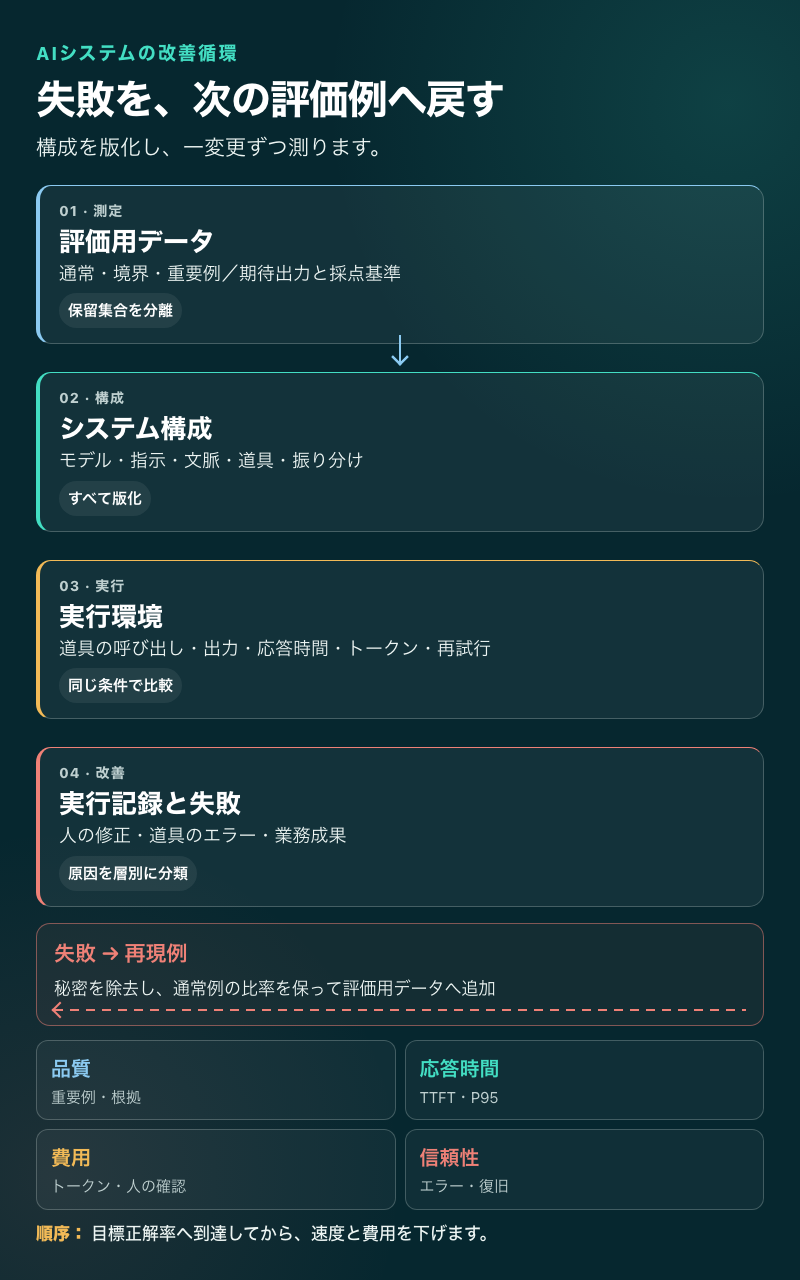
失敗を評価課題へ戻す
原因を修正したら、本番の一件を再現できる評価課題へ変えます。今回保存する一組は次のとおりです。
- 古いプランと現行プランの資料
- 利用者の依頼
- 検索できる範囲
- 期待する回答と根拠
- 選ぶべきプランID
- 送信してはいけない条件
個人情報は架空値へ置き換えますが、誤りを起こした版の紛らわしさは残します。
一件だけを直すと、「日付が二つあれば新しい方を選ぶ」といった過剰な規則へ偏りがちです。将来開始するプラン、地域限定プラン、更新日だけ新しい旧版、日付が欠けた資料も対にします。答える例と、情報不足として止まる例の両方が必要です。
OpenAIの評価機能は、評価の定義、テストデータ、採点方法、実行結果を分けて管理します。2 Anthropicも、最終回答だけでなく、道具利用と環境の最終状態を含む実行記録を評価対象にしています。6
一件の結果を分解して採点する
| 採点対象 | 確認すること |
|---|---|
| 回答文 | 現行プランと条件を正しく説明したか |
| 根拠 | 正しい版を引用したか |
| 操作 | 正しいプランIDと顧客IDを選んだか |
| 最終状態 | 禁止条件なら送信せず停止したか |
評価が本番とずれる条件
評価用データが合格しても、本番が同じように成功するとは限りません。ずれの兆候は主に四つです。
- 正解の劣化。商品、規程、索引が変わり、評価の正解が古い。
- 入力分布の偏り。整った依頼ばかりで、短文や入力漏れがない。
- 採点器の偏り。長い回答を、簡潔で正しい回答より好む。
- 保留集合の漏えい。最終判定用の課題を調整に使っている。
各課題へ根拠資料の版と最終確認日を持たせます。自動採点の点数だけでなく、差し戻し、再問い合わせ、処理完了と結び付くかを公開後に確認します。
平均点より先に見るのは、重大な誤送信や根拠の捏造が増えていないかです。小さな集合で数ポイント上がっても、重大事故が一件増えたなら採用しません。
合格後に速度と費用を下げる
最適化には順番があります。
- 品質の合格線を固定する
- 固定規則で処理できる絞り込みや集計をプログラムへ戻す
- 独立した取得を並列化し、不要な呼び出しと長い出力を減らす
- 共通の指示や道具定義へキャッシュを使う
- 合格した構成同士で、仕事単位の費用と時間を比べる
OpenAIの速度最適化資料は、呼び出し回数、出力量、並列化、利用者が感じる待ち時間を分けて考える方法を示しています。8 繰り返し使う共通部分は、指示文のキャッシュで費用と待ち時間を減らせます。9
ただし、キャッシュは正しさを改善しません。簡単な依頼を小さいモデルへ振り分ける場合も、振り分けの誤りを含めて評価します。
比べるのはモデル料金ではなく完了費用
完了費用には、モデル利用料だけでなく、検索、外部サービス、再試行、人の確認、失敗後の手戻りを含めます。安いモデルが確認作業を増やすなら、製品全体では高くなります。
新しいモデルを採用する条件
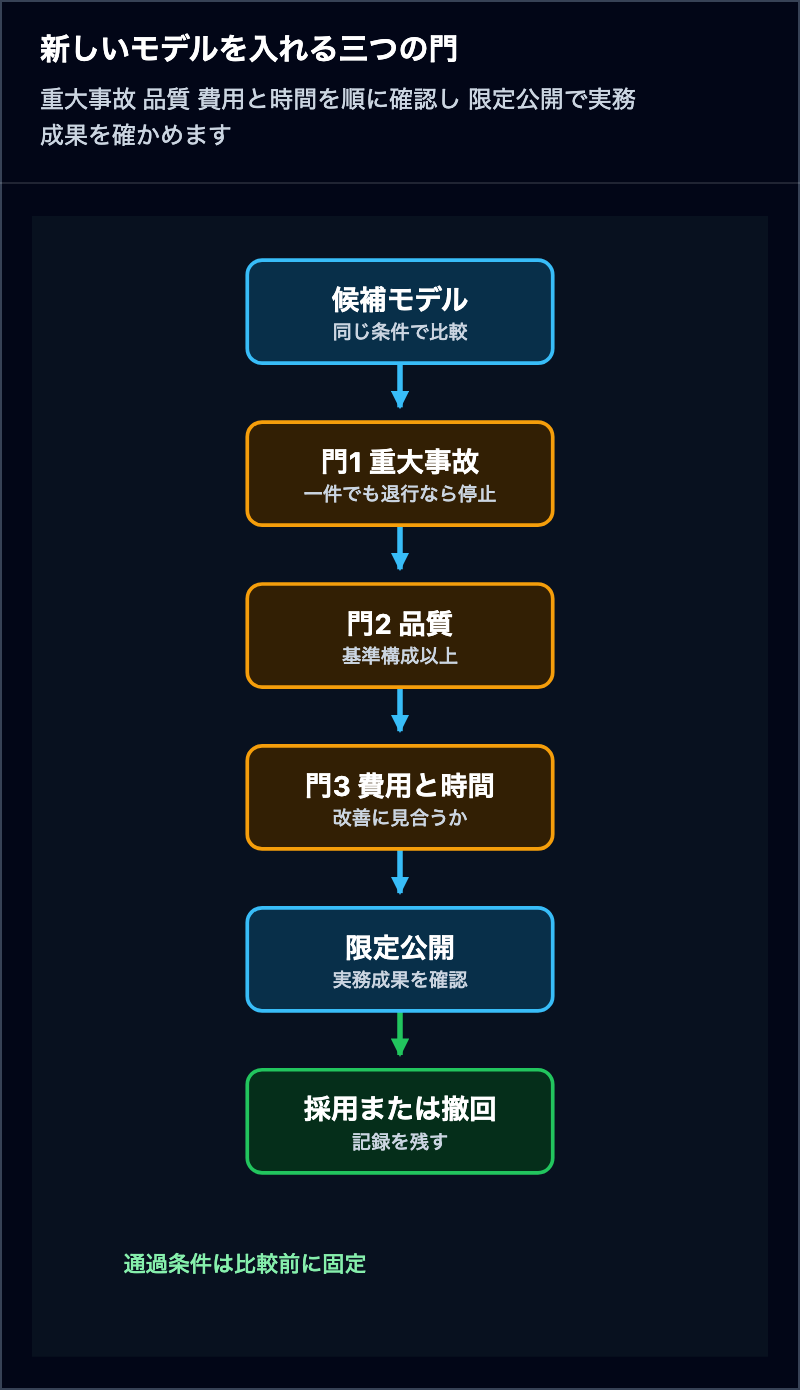
新しいモデルは、現在の本番構成を基準にし、同じ評価課題、検索条件、道具、応答上限で比較します。採用を止める条件は、比較を始める前に決めます。
| 観点 | 同じ一件で測るもの | 採用を止める例 |
|---|---|---|
| 品質 | 完了条件、根拠、重要例の合格 | 誤送信や根拠捏造が増える |
| 応答時間 | 最初の応答、全体時間、遅い側の値 | 利用者の期限を超える |
| 費用 | モデル、道具、再試行、人の確認 | 完了費用が許容予算を超える |
| 信頼性 | 形式エラー、時間切れ、復旧 | 同じ入力で結果が安定しない |
事前評価を通過したら一部利用だけで試し、公開前の点数と実際の業務成果が一致しなければ、モデル名の新しさを理由に全面移行しません。
診断できる運用が製品差になる
生成AI製品の差は、強いモデルをどれだけ早く採用するかだけでなく、一件の失敗を再現し、原因と同じ場所へ修正を戻せるかで決まります。
公開前の最終チェック
- 取得した資料と有効日を再現できる
- モデルへ渡した文脈を再現できる
- 道具の引数と外部の最終状態を確認できる
- 本番の失敗を評価課題へ戻せる
- 一変更ごとに同じ評価を再実行できる
検索の問題をモデルで隠し、道具の問題を指示文だけで抑えると、次の入力で事故が形を変えて現れます。モデル競争が速くなるほど、製品側の資産になるのは特定のモデル名ではなく、自社の仕事を同じ物差しで再評価し、安全に交換できる診断能力です。
参照リンク12件
- OpenAIModel guidance
- OpenAIWorking with evals
- AnthropicEffective context engineering for AI agents
- AnthropicWriting effective tools for agents — with agents
- AnthropicDemystifying evals for AI agents
- OpenAIFunction calling
- AnthropicBuilding effective agents
- OpenAIProduction best practices
- OpenAILatency optimization
- OpenAIPrompt caching
- 情報処理推進機構テキスト生成AIの導入・運用ガイドライン
- 経済産業省・総務省AI事業者ガイドライン 第1.2版
2026年8月20日時点の公式資料を確認しています。仕様は更新される可能性があります。