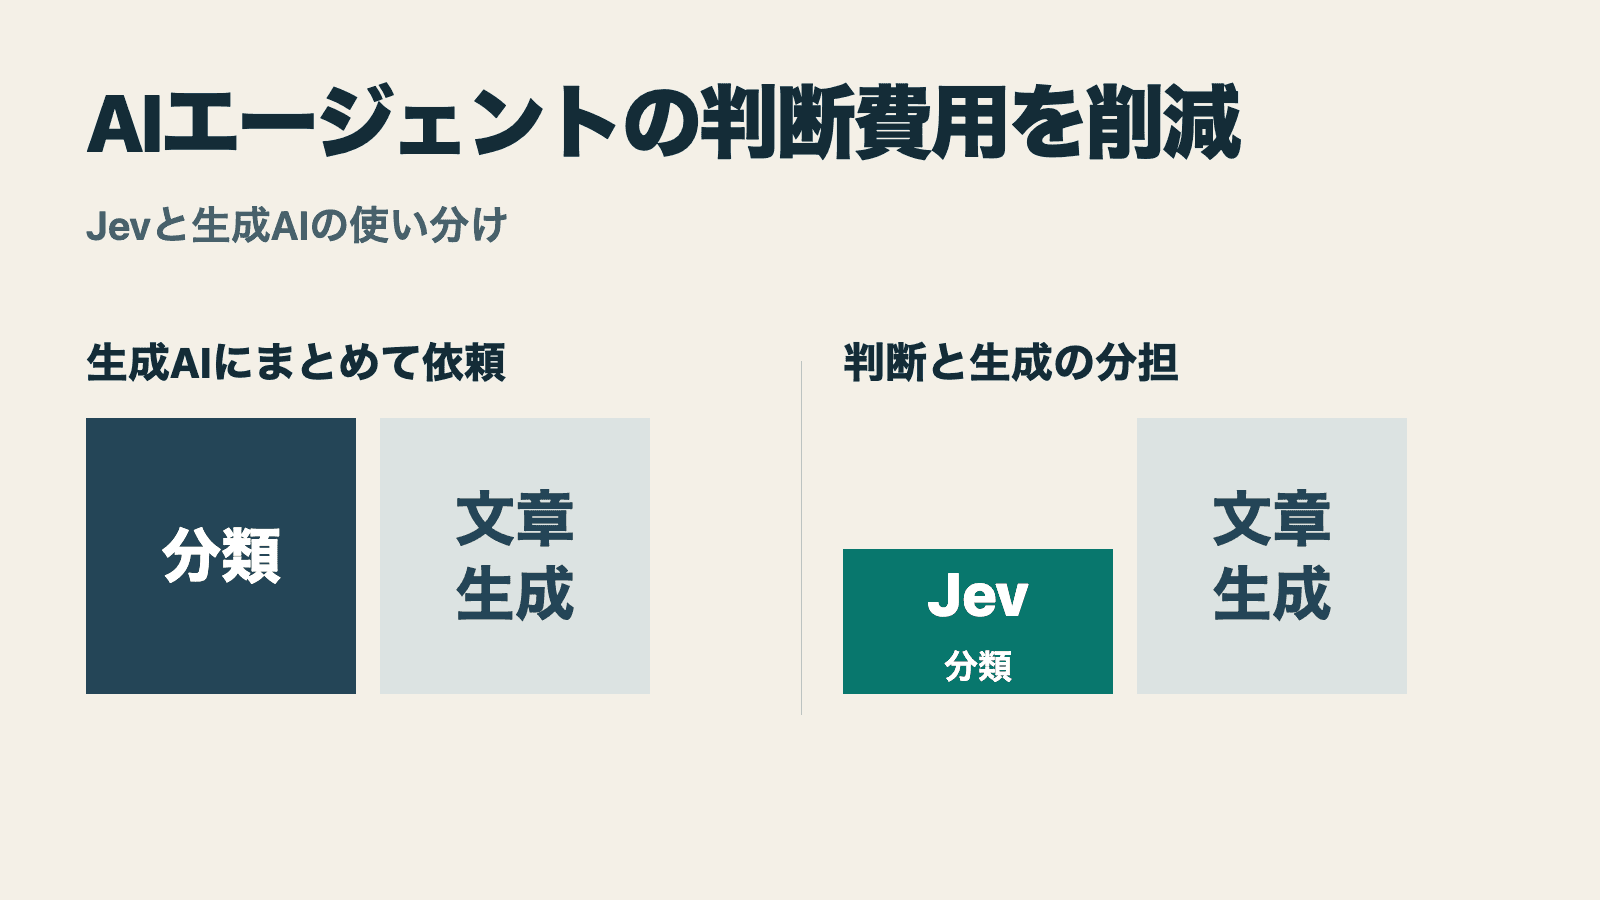
同じLLMへ文章の作成も分類も検査もまとめて通すと、費用と待ち時間が件数に比例して増えます。2026年9月に早期アクセスで公開されたJevは、文章を作らず候補の確率だけを返すモデルです。提供元の公開評価では業務フロー1件あたり0.0004ドル・0.4秒で、同じ評価のGPT-5.6 Terraは0.0304ドル・10.1秒でした。ただし請求書処理では12.9ポイント下回り、費用が約200倍のGPT-5.6 Solには四つの仕事すべてで負けています。どの判断を文章生成から切り離し、どれをコードと人に残すかを、公開評価と振り分け研究から整理します。費用の数字は公開価格からの計算です。
LLMへ全部通すと費用と待ち時間が積み上がる
問い合わせが一日に一万件届く窓口を考えます。全件を最上位のモデルへ送れば品質は高めやすいものの、費用と待ち時間が件数に比例して膨らみます。逆に安いモデルへ一括で置き換えると、大半の易しい案件は問題なく処理できても、まれに混ざる難しい案件で事故が起きます。
よく検討されるのは、案件ごとに最適なモデルを割り当てる設計です。ただし後で見るように、評価された振り分け手法は、商用のものを含めて、入力の長さなどで分ける単純な方式を安定して上回れていません。
先に効くのは、モデルの割り当てを細かくすることより、そもそも文章を作らせなくてよい判断を工程から切り出すことです。問い合わせの分類、優先度づけ、生成物の検査は、答えの候補がこちら側で先に決まっています。候補が決まっている判断に文章を書かせ、JSONへ整形し、壊れていれば再試行する。この往復が、費用と待ち時間の大きな部分を占めています。
切り出した判断をどこへ渡すか、判定の後をどの処理へ分けるか、判定を工程のどこへ置くか、閾値をどう運用するか、導入効果を何と比べて測るか。決めることはこの五つです。具体例には、2026年9月に早期アクセスで公開されたJevを使います。同じ分岐は小型モデルの構造化出力や専用の分類器でも組めるため、Jevが手に入らない段階でも設計は先に試せます。なお、以下の費用と速度はすべて公開価格と公開評価から計算した値で、APIを呼んで測った実測値ではありません。
候補が決まっている判断は文章を作らせない
Jevは、TypeSafe AIが2026年9月15日に早期アクセスで公開した、文章を生成しないAIモデルです。入力はテキストまたはJSONで、答えは次の三種類から指定します。いずれもプログラムがそのまま読める形式で返ります。16
| 質問 | 何を決めるか | 返すもの |
|---|---|---|
| Choice | 有限の候補から一つを選ぶ | 選択結果、各候補の確率、確信度 |
| Score | 定義した段階上で評価する | スコア、各段階の確率、確信度 |
| Noul | 命題が真かを判定する | 真である確率 |
顧客から「同じ料金を二度請求された」と連絡が来た場面で考えます。業務システムが必要とするのは丁寧な説明文ではなく、処理を先へ進めるための値です。Choiceで「請求」「技術」「契約」から担当を選び、Noulで「返金を求めている」「緊急対応が必要」を別々に判定すれば、コードはその確率を読んで分岐できます。複数の質問は同じ入力を見ますが、互いに独立した問いとして一度に処理されるため、検査項目を増やしても呼び出しは一回で済みます。1
価格は入力100万トークン当たり0.042ドルで、出力は課金対象外、応答時間は提供元の説明で70〜500ミリ秒です。入力だけを課金対象にする料金体系は使い方にも影響し、渡す状態が短いほど安くなります。制約も先に押さえます。画像、音声、動画は扱えません。一度に送る状態と全質問の合計は64000トークンまで、状態と最も長い質問の合計は32000トークンまでで、選択肢は255個までです。無関係な情報が増えるほど精度が落ちることも提供元が公開しています。質問はまとめ、判定材料は必要な部分だけに絞ります。これが設計の基本形です。23
任せてはいけないものもはっきりしています。金額が発注額と一致するか、期限を過ぎていないか、権限があるか、上限を超えていないか。字面どおりの読み取り、算数、数え上げ、日付や時刻の比較、二重否定をはさんだ遠回しな条件で不安定になり得ると、提供元自身が公開しています。これらは確率ではなくコードで確かめます。3
費用対効果が出る条件も四つに絞れます。件数が多いこと、大半は易しく一部だけが難しいこと、難しい案件の見逃しによる損失が詳しい確認へ回し過ぎる費用より大きいこと、正誤が事後に分かり確信度と実際の正答率を見ながら境界を調整できることです。どれか一つでも欠けていれば、単価の安さだけで導入効果は決まりません。
公開評価は仕事ごとに勝ち負けが入れ替わる
TypeSafeは、セキュリティ事案、エージェントの実行記録、請求書処理、顧客対応という四つの仕事を公開評価に使いました。各仕事を一発の依頼へ詰め込まず、狭い意味判断とコード上の規則へ分解しています。2026年9月17日時点の四つの平均は次のとおりでした。4
| モデルと方式 | 精度 | 1件当たり費用 | 時間 |
|---|---|---|---|
| Jevによる業務フロー | 67.8% | 0.0004ドル | 0.4秒 |
| GPT-5.6 Terraによる業務フロー | 67.9% | 0.0304ドル | 10.1秒 |
| GPT-5.6 Solによる業務フロー | 74.1% | 0.0836ドル | 23.3秒 |
| Claude Opus 5による業務フロー | 73.1% | 0.1761ドル | 37.8秒 |
| GPT-5.6 Lunaによる業務フロー | 66.8% | 0.0033ドル | 12.9秒 |
平均だけなら、JevはGPT-5.6 Terraとほぼ同じ精度で、費用は約76分の1、時間は約25分の1です。けれども仕事ごとに見ると、両者の勝ち負けは入れ替わります。
| 仕事 | Jev | GPT-5.6 Terra | 差 |
|---|---|---|---|
| セキュリティ事案 | 61.7% | 51.2% | +10.5 |
| 顧客対応 | 76.0% | 72.7% | +3.3 |
| エージェント実行記録 | 71.6% | 73.0% | -1.4 |
| 請求書処理 | 61.8% | 74.7% | -12.9 |
差が最も大きい請求書処理は、金額、数量、日付、発注から納品、請求への対応関係まで含む仕事です。請求書の意味分類には使えても、金額計算や一致判定はコードへ残すべきだという設計上の示唆になります。勝ち負けが入れ替わるのは平均精度が並んだTerraとの間の話で、1件当たりの費用がJevの約200倍かかるGPT-5.6 Solは四つの仕事すべてでJevを上回り、差は請求書処理で17.3ポイントに達します。Claude Opus 5も、Jevが3.6ポイント上回った顧客対応を除く三つで上回りました。4
この表の絶対値を実運用の正答率として読むことはできません。正解は実際の業務結果ではなく、GPT-6 AstraとClaude Fable 5.1を高い思考設定で動かした回答の平均で、業務フローもTypeSafeのモデル能力チームが作っています。読み取れるのは行同士の差までです。一方で、Jevを使わない場合にも効く知見が一つあります。四つの仕事すべてで、長い依頼文一つに任せるより、質問を分解して正確な規則をコードへ移した方が、各モデルの精度、速度、費用が改善しました。4
外部の初期試験も出ています。Everyの評価責任者Mike Taylorは、37本の文章へ21項目の検査をかけ、777件の判断を0.7秒未満、推定0.25セントで得たと報告しました。同じEveryで最高経営責任者のDan Shipperは、12本の合成文章に意図的に七つの欠陥を埋めて試し、Jevは六つを検出しましたが、逃した一件は三回の試行すべてで同じように見逃しました。開発者のMichael Leeは分類やモデルの振り分けなど約5000リクエストを約2ドルで試し、中央値約150ミリ秒、95パーセンタイル約350ミリ秒だったと報告しています。速度と低価格は提供元の主張と整合し、精度は仕事によって変わり、日本語の公開評価は見当たりません。1317
安い判定を繰り返せば偶然の揺れは減らせますが、同じモデルの読み違いは消えません。詳しい確認には、コードによる検算、別の提供元のモデル、人のいずれかを使います。提供元はハルシネーションしないと表現しますが、保証されるのは定義した候補を外れた値や壊れたJSONを返さないことだけで、技術の問い合わせを請求へ誤分類することはあります。返ってくる確信度も、似た100件へ0.9を返したならおよそ90件が正しい、という集団単位の性質です。一件ごとの正しさの保証ではありません。15 モデルの素性と外部試験の詳しい読み方は「文章を作らないAIをどこまで信じるか」で扱っています。
モデル名より先に役割を決める
モデルを振り分ける研究は、ここ数年で積み上がりました。FrugalGPTは、易しい問い合わせを安いモデルへ送り、難しいものだけを高性能なモデルへ回す段階式の方法で、最良の単体モデル並みの性能を最大98%の費用削減で達成したと報告しています。RouteLLMは、条件によっては2倍を超える費用削減を品質を損なわずに達成したとしています。どちらも特定のデータセットとモデルの組で得た結果です。78
横断的に測り直したのが2026年のLLMRouterBenchです。21のデータセット、33のモデル、40万件を超える事例に10の代表的な振り分け手法を当てました。統一評価の下では大半の手法が似た性能へ収束し、商用の振り分けサービスを含むいくつかの最近の手法は、入力の長さなどで分ける単純な方式を安定して上回れませんでした。理想的な振り分けとの差の主な原因は、正解できるモデルが候補の中にいるのに案件をそこへ送れないことで、候補モデルを増やすほど追加の効果は小さくなるとも報告しています。914
したがって、毎回三つのモデルを呼んで良い答えを選ぶ設計は、費用と待ち時間を確実に増やす割に、見合う品質の向上が保証されません。かといって、GPTは通常案件、Claudeは難問、Geminiは検証、と役割を固定することもできません。Googleの公開資料でも、Geminiは速度と費用効率を狙うFlash系から、複雑な問題解決や長時間のエージェント処理を狙うPro系まで複数のモデル群として提供されており、通常案件にも難案件にも長い入力の専門案件にも使えます。1516
そこでモデル名より先に役割を四つ決め、自社の事例を使ってそれぞれにどのモデルを入れるかを決めます。
| 役割 | 決め方 | 入り得るモデル | 変わったときにやること |
|---|---|---|---|
| 通常案件の担当 | 自社の代表事例で、正しく完了した1件当たりの費用と、遅い側から5%に入る完了時間が最も良いものを選ぶ | GPT、Claude、Geminiのいずれでもよい | 設定ファイルのモデルIDを差し替える |
| 難しい案件の担当 | 通常担当が実際に誤った案件だけを集め、そこで最も成績が良いものを選ぶ。通常担当と同じ誤りをしにくいことも確かめる | 同上。Gemini Pro系も候補 | 閾値を測り直す |
| 専門案件の担当 | その案件で必要な能力から選ぶ。長い入力、画像、音声、動画、検索、コード実行など | 必要な機能を持つモデル。長い入力と映像ならGeminiも候補 | 対象となる案件の条件を定義し直す |
| 異なる方法による再確認 | 通常担当と同じ誤りをしにくいかを、危険案件や抜き取りで測る | 別の提供元のモデル、コードによる検査、人の確認など | 抜き取る割合を見直す |
CodexやClaude Codeのような開発エージェントは、同じ欄に置きません。これらはコードを編集し、テストを走らせ、コマンドを実行して作業そのものを完了させる実行役です。開発エージェントへ回すかどうかは、どのモデルが強いかではなく、コードや外部ツールを実際に動かす必要があるかで決めます。
役割を固定しつつモデルを入れ替えられるように、コードには役割名を書き、具体的なモデルIDと閾値は設定ファイルで管理します。振り分ける条件が変わらなければ、モデルを入れ替えても呼び出す側のコードは変わりません。

判定の後を四つの処理へ分ける
切り出した判定に具体的なモデル名を選ばせず、次にどの処理へ進むかを選ばせると、行き先は四つに整理できます。
| 決定 | 意味 | 続く処理 |
|---|---|---|
| 通常処理 | このまま進めてよい | 既定の処理、または通常担当モデルの出力をそのまま採用 |
| 情報を補う | 情報が足りない | 情報の追加取得、確認質問、再実行 |
| 別のAIで再検討 | 難しい、または誤ったときの損失が大きい | より高性能なモデル、異なる方法による検査、詳しい検証 |
| 人が確認 | 取り返しがつかない、または責任を伴う | 承認待ちの一覧へ送る |
四つに分けておくと、後でモデルの順位が入れ替わっても分岐の条件はそのまま使えます。判定が返すのは行き先であって、モデルの優劣ではないからです。

判定を置くのは入力直後と実行直前と生成直後
判定を置く場所は三つです。担当者や顧客から入力を受けた直後、外部ツールや社外システムを呼ぶ直前、そして生成物が出た後です。
この三つは実装側の枠組みにも用意されています。OpenAI Agents SDKは、入力、出力、ツールの三種類のガードレールを持ちます。入力ガードレールは既定ではエージェントと同時に動き、先に検査を終えてから動かす設定へも切り替えられます。同時に動かせば待ち時間は短くなりますが、止める判断が出る前にトークンを使ってしまうことがあります。12
判定材料と質問を合わせて2000入力トークンを渡し、一回判定する場合の費用は、公開価格から 2000 ÷ 1,000,000 × 0.042 で約0.000084ドルです。判定が数百ミリ秒でこの水準に収まるなら、生成を始める前に結果を待つ負担は小さくなります。取り返しのつかない外部ツールの実行については、生成と判定を同時に動かさず、判定の結果を待ってから進める設計が現実的な選択肢に入ります。危険な処理を安い費用で先に止められることが、判定を切り出す具体的な利点の一つです。2
導入効果を確かめやすいのは、このうち外部ツールを呼ぶ直前です。失敗による損失が最も大きくなりやすく、Anthropicの整理でも、誤りが積み重なるエージェントの性質に対して工程の途中へプログラムによる検査を置くことが勧められています。始めやすいのは、承認待ちの一覧を危険度と確信度で並べ替える用途です。最終判断は人が行うため影響を限定でき、人がつけた結果を確信度の調整データとして残せます。11
置かない場所も決めておきます。採用、与信、医療、送金のように誤りの影響が大きく説明責任も伴う判断は、確率一つで自動実行せず、人へ返す経路に置いたままにします。

閾値は決めた後も測り直す
案件を四つの処理のどれへ進めるかは、返ってきた確率と、あらかじめ決めた閾値で決まります。この閾値は入力やモデルの変化で実態と合わなくなります。
2026年に公開されたConformal Cascadeは、この問題を正面から扱っています。安いモデルから高性能なモデルへ段階的に切り替える仕組みでは確信度の閾値で次へ回すかを決めますが、モデルが返す確信度と実際の正答率にはずれがあり、閾値は組み合わせる二つのモデルと業務領域ごとに調整し直す必要があります。同論文は、確信度の数値そのものではなく、手元の調整用データから作った答えの集合が一つに絞れたかどうかで決める規則を提案し、段数をK、許容する誤り率をαと置くと、採用した段の答えが正解を含む確率は少なくとも1−K×αになると示しました。ただし評価は18の多肢選択ベンチマークと重みが公開された四つのモデル群に限られ、正解の候補を有限個に絞れることが前提です。10
そのため、0.9以上なら自動処理してよい、といった普遍的な数値は置けません。閾値は次のように運用項目として扱います。
- 確率帯ごとの実際の正答率を検証用データで測ってから境界を決める
- 難しい案件を任せるモデルを替えたら閾値を測り直す
jev-latestのように中身が更新されるIDではなく、jev-1.13.0のように版を固定したIDを使い、新しい版へ切り替える前に同じ事例で測り直す- 詳しい再検討へ回した案件の割合を日々監視し、明確な理由なく下がったら見逃しが増えた可能性を疑う
確信度そのものの読み方にも注意が要ります。較正とは、似た100件へ0.9を返したならそのうちおよそ90件が正しい、という集団単位の性質です。個別の一件が90%の確率で正しいという保証ではありません。5
判定を挟むことで新しく増える失敗も三つあります。本来は高性能なモデルや人の確認へ回すべき案件を通常処理へ通す見逃し、同じモデルで検出と最終確認まで済ませて読み違いをそのまま通すこと、入力の言語や顧客層や業務規則が変わって閾値が古くなることです。見逃した割合を主要指標として先に定義しておかないと、費用が下がったという報告だけが残ります。

費用より難しい案件の見逃しで決まる
難しい案件だけを高性能なモデルへ回すと、費用がどう動くかを粗く計算します。公開評価で、GPT-5.6 Terraを使った業務フローは1件0.0304ドル、GPT-5.6 Solでは0.0836ドルでした。1件当たり3回判定してその費用を約0.00025ドルとし、10%だけをSolへ回して残りをTerraで処理すると、0.00025 + 0.9 × 0.0304 + 0.1 × 0.0836 で約0.036ドルになります。全件をSolで処理する場合の約43%です。4
この計算は導入見積もりには使えません。読み取れるのは、判定と生成にかかる費用の大小関係だけです。そして節約が意味を持つのは、Solへ回した10%が本当に再検討すべき10%と重なっている場合だけです。無作為に10%を選んでも費用は同じだけ下がりますが、品質はほとんど改善しません。
そのため、比較対象には複雑なAIを使わない方式も必ず入れます。現在の運用、全件を中位のモデル一つで処理する案、入力の長さや単純な規則だけで分ける案、判定を挟んで分ける案の四つを、同じ事例で並べます。測る指標も全体の正答率ひとつではありません。正しく完了した1件当たりの総費用、遅い側から5%に入る案件の完了時間、難しい案件の見逃し率、詳しい確認へ回し過ぎた割合、確信度の範囲ごとの実際の正答率とそのずれを並べます。
試験用の事例には、通常の案件だけでなく、判断が難しい案件、用意した選択肢のどれにも当てはまらない案件、情報が足りない案件、判定を誤らせようとする入力、日本語で表現を変えた入力も混ぜます。最初は本番の処理を変えず、裏側で判定結果だけを記録し、そこから閾値を調整します。
比べる相手も、生成モデルだけではありません。有限の候補を高速に選ぶ仕事には、従来からルール、専用分類器、再ランキングモデル、小型モデルの構造化出力があります。十分な教師データがある一種類の判定を大量に回すだけなら、専用の分類器のほうが速く、安く、社内で管理しやすい可能性があります。最適化した専用分類器とJevを同じ条件で比べた結果は、提供元の発表にも第三者の研究にも見当たりません。公開直後の現時点では、ここが最も大きな未検証部分です。
Jevを使う場合は、工程の中で何度も呼び出すほど利用上限の影響も受けます。公開されている上限は毎秒25万トークン、毎分1200リクエストで、需要に応じて調整中と明記されています。毎分1200回を均等に使えると仮定しても、1件につき5回呼ぶ設計では平均して毎秒4件しか処理できません。渡す状況説明を短くし、複数の質問を一度にまとめる設計は、費用だけでなく利用上限への対策にもなります。2
ここまでの四つの処理、判定を置く三つの場所、閾値を調整し続ける運用は、Jev固有のものではありません。同じ分岐は、小型モデルの構造化出力でも、専用の分類器でも、用意した選択肢を既存の生成モデルへ示して確からしさを読む形でも組めます。数値、日付、権限はコードで確かめ、責任を伴う最終判断は人へ返します。この二つを動かさず、その間にある曖昧な選択だけを安く速く繰り返すのが、使い分けの中身です。下がるのは費用と待ち時間ですが、その設計が成功したかどうかは、詳しい確認が必要な案件を見逃していないかで決まります。
参照リンク17件
- TypeSafe AIIntroducing System One Models & Jev
- TypeSafe AI DocsModels
- TypeSafe AI DocsModel jaggedness — Jev 1.13
- TypeSafe AI業務フロー評価
- TypeSafe AI DocsConfidence
- TypeSafe AI DocsPrimitives (Questions)
- Chen, Zaharia, ZouFrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance
- Ong et al.RouteLLM: Learning to Route LLMs with Preference Data
- Li et al.LLMRouterBench: A Massive Benchmark and Unified Framework for LLM Routing
- Dou et al.Conformal Cascade: Distribution-Free Accuracy Guarantees for Multi-Tier LLM Inference
- AnthropicBuilding Effective Agents
- OpenAI Agents SDKGuardrails
- EveryMini-Vibe Check: TypeSafe's Jev Judged Everything I’ve Written in 0.7 Seconds
- Hu et al.RouterBench: A Benchmark for Multi-LLM Routing System
- Google AI for DevelopersGemini models
- Google AI for DevelopersLong context
- Michael Lee(X)約5000回のJev早期試用
2026年9月18日時点の公式資料を確認しています。仕様は更新される可能性があります。