Jevは文章を生成せず、あらかじめ定めた候補の確率だけを返すモデルです。提供元はハルシネーションしないと表現しますが、保証されるのは型を壊さないことだけで、技術問い合わせを請求へ誤分類することはあります。返ってくる確信度も、似た100件のうち何件が正しいかという集団単位の性質で、一件ごとの正しさではありません。公開評価と外部の初期試験、専用分類器との未比較まで含めて、何を任せてよいかの判断材料を整理します。
ソフトウェアが使うためのAIという賭け
この記事が扱うのは、文章を作らないAIそのものです。何を返し、どこまで信じてよいのか。返ってくる値の形、公開評価と外部試験の読み方を確かめ、専用分類器との比較がまだない点まで含めて見ます。判定の後をどの処理へ分けるか、閾値をどう運用するか、導入効果を何と比べて測るかという設計側の手順は「LLMの使い分けでコストと待ち時間を下げる」で扱っています。
TypeSafe AIの共同創業者で最高経営責任者のDiogo Almeidaは、Jevの発表文で一つの問いを立てました。チャットの中では何年も前からモデルが人間を超えているのに、その知能を使った自動化はどこにあるのか。1
彼はOpenAIで、人間の指示に従うようモデルを訓練する研究に関わりました。2022年の論文「Training language models to follow instructions with human feedback」の共著者で、ここで示された手法がInstructGPT、そしてChatGPTへつながります。人間の好みから強化学習する手法そのものの原型は2017年の別の論文にあり、そちらの著者にAlmeidaは入っていません。34
その当事者が、自分の関わった路線を疑う側へ回りました。人間に好まれるよう最適化してきたことが、ソフトウェアの内部で使うときには足かせになる、というのが本人と会社の説明です。2024年にErik Gafni、Sasha Shengと会社を興し、約2年のステルス期間を経て、2026年9月15日に4000万ドルの調達とともに姿を現しました。モデルの名前は19世紀の経済学者William Stanley Jevonsにちなみます。蒸気機関の効率が上がったとき、石炭の消費は減らずに増えました。一回の判断が安く速くなるほど判断を使う回数そのものが増える、という読みにTypeSafeは賭けています。1256
Jevは文章ではなく型付きの判断結果を返す
顧客から「同じ料金を二度請求された」と連絡が来たとします。業務システムが必要とするのは、丁寧な説明文ではなく、処理を先へ進めるための値です。請求担当へ送るか、返金を求めているか、すぐ人が見るべきか。この三つをプログラムが読める形で受け取れれば、次の処理が決まります。
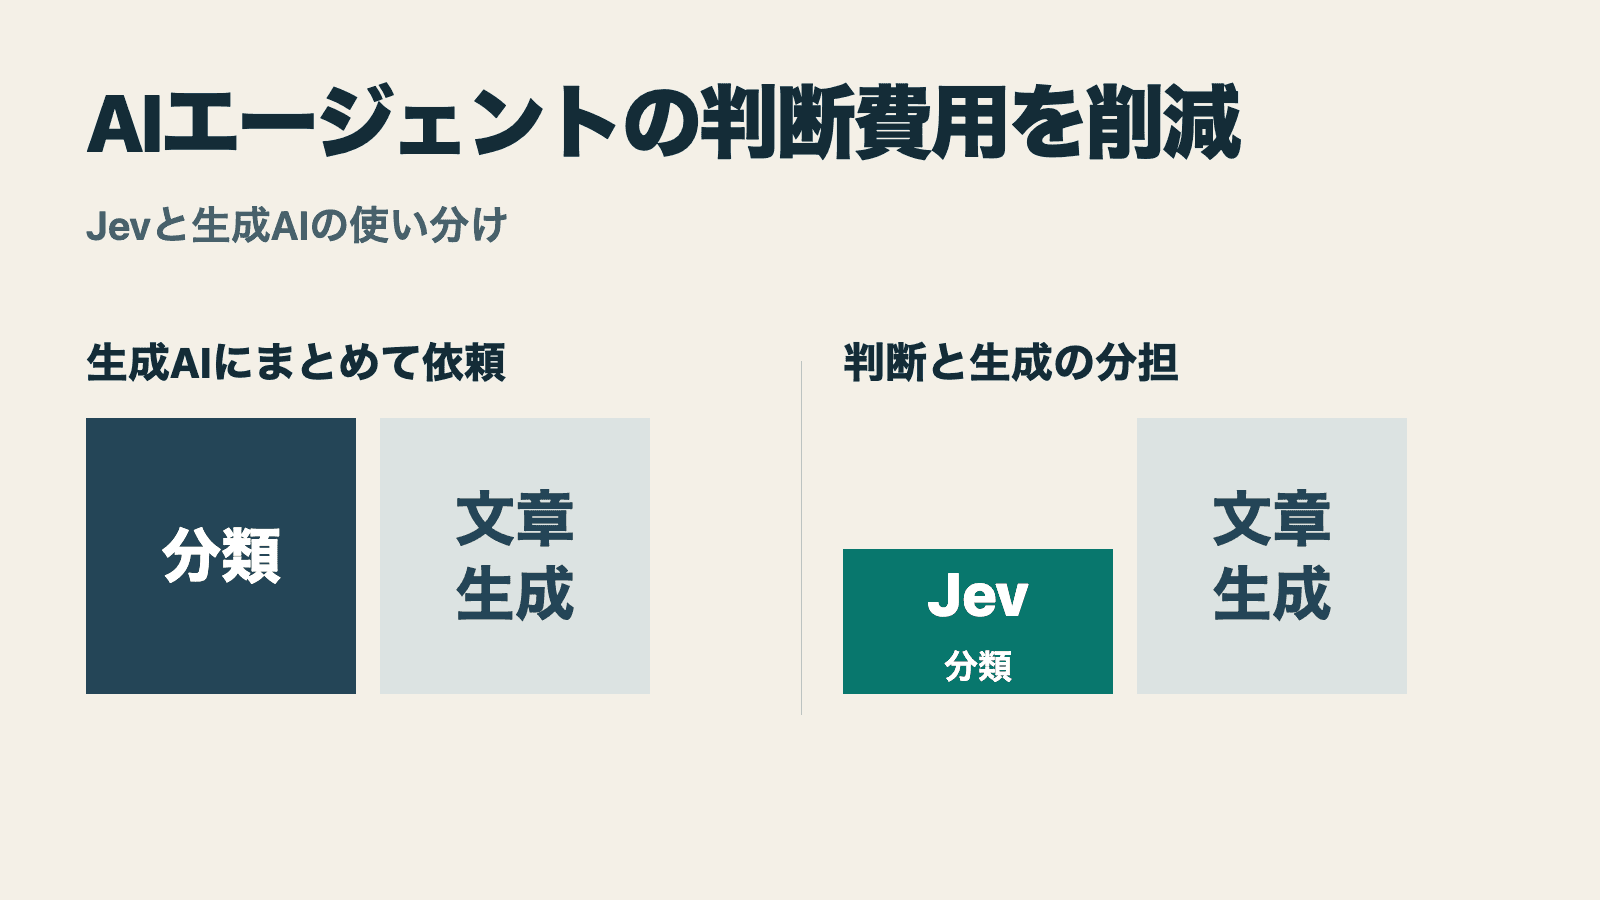
従来は、こうした判断にも大規模言語モデルへ文章を書かせ、JSONに整形し、壊れていれば再試行していました。Jevはその文章生成を最初から行いません。入力された文章やJSONを読み、あらかじめ定めた候補、段階、真偽の確率だけを返します。TypeSafeはJevを最初の「System One Model」と呼びます。用意された質問は三種類です。1789
| 質問 | 何を決めるか | 返すもの |
|---|---|---|
| Choice | 有限の候補から一つを選ぶ | 選択結果、各候補の確率、確信度 |
| Score | 定義した段階上で評価する | スコア、各段階の確率、確信度 |
| Noul | 命題が真かを判定する | 真である確率 |
先ほどの問い合わせなら、Choiceで「請求」「技術」「契約」から担当を選び、Noulで「返金を求めている」「緊急対応が必要」を別々に判定できます。複数の質問は同じ入力を見ますが、互いに独立した問いとして一度に処理されます。コードはその確率を読み、請求担当へ送る、確信度が低ければ人へ回す、といった分岐を実行します。
できることを狭くした結果、プログラムが読む値を直接返せるわけです。制約も先に押さえます。入力は文字列、JSON、テキスト配列に限られ、画像、音声、動画は扱いません。一度に送る状態と全質問の合計は64000トークン、状態と最も長い質問の合計は32000トークン、Choiceの候補は255個までです。11

文章生成を省いて速さと安さを得る
通常のLLMは、前に出した文字列を参照しながら次のトークンを一つずつ生成するため、説明が長いほど計算と待ち時間が増えます。TypeSafeの説明では、Jevは同じ入力に対する複数の確率判断を並列に返し、出力を一語ずつ積み上げません。ただし、その構造もパラメータ数も、訓練データや再現可能な学習手順も公開されておらず、外から内部を断定できる段階ではありません。122
公開価格は入力100万トークン当たり0.042ドルで、出力は課金対象外です。応答時間は70〜500ミリ秒、候補選択や段階評価のような狭い判断ではLLMより40〜200倍高速というのが提供元の説明です。トップページに掲げる193.6倍速く444.6倍安いという数字は、自社が設計した四つの業務フローから出た高い側の値だと提供元自身が書いています。現行版はJev 1.13で、公開レート上限は毎秒25万トークン、毎分1200リクエスト、需要に応じて動的に調整中と明記されています。1014
入力だけを課金対象にする料金体系は、使い方にも影響します。渡す状態が短いほど安く、公開評価ではJevの1件当たり費用が顧客対応の0.0001ドルに対し、請求書処理では0.0011ドルと11倍の差でした。精度にも同じ傾向があり、公式資料は状態に無関係な情報が増えるほど精度が落ちると認めています。長い文脈をそのまま渡す使い方は、費用と精度の両方で不利になります。1114
公開評価は仕事によって勝ち負けが入れ替わる
TypeSafeは、セキュリティ事案、エージェントの実行記録、請求書処理、顧客対応という四つの仕事を公開評価に使いました。四つの平均は、Jevが精度67.8%、1件当たり0.0004ドル、0.4秒。GPT-5.6 Terraが67.9%、0.0304ドル、10.1秒です。精度はほぼ並び、費用は約76分の1、時間は約25分の1になります。ただし仕事ごとに見ると勝ち負けは入れ替わります。セキュリティ事案ではJevがTerraを10.5ポイント上回り、金額や日付の対応関係を含む請求書処理では12.9ポイント下回りました。1件当たりの費用がJevの約200倍かかるGPT-5.6 Solは、四つの仕事すべてでJevを上回っています。14

これらの数値は、実運用の正答率として読むことができません。正解ラベルは実際の業務結果ではなく、GPT-6 AstraとClaude Fable 5.1を高い思考設定で動かした参照回答の平均で、精度はその参照回答との一致度です。ワークフローはTypeSafeのモデル能力チームが作り、比較対象のLLMは同社が用意した比較用の仕組みを通して確率付きの構造化回答を返します。どのモデルも8割に届かないのは、比べている相手が現実の確定値ではないことの反映でもあります。1521
一方、この評価にはJevを採用しない場合にも使える知見があります。四つの仕事すべてで、長いプロンプト一つに任せるより、質問を分解し、正確な規則をコードへ移した方が、各モデルの精度、速度、費用が改善しました。比べているのはモデルだけではありません。14
外部の初期試験が示した速さと見落としの癖
Everyの評価責任者Mike Taylorは、37本の文章へ21項目の検査をかけ、777件の判断を0.7秒未満、推定0.25セントで得たと報告しました。同じEveryで、最高経営責任者のDan Shipperは12本の合成文章に意図的に七つの欠陥を埋め、この試験のために用意した四つの検査項目を、JevとClaude Fable 5.1の双方へ同じ条件で実行させました。Mike Taylorの21項目とは別の項目です。Jevの中央値は0.35秒、Fableは8.83秒で約25倍の差があり、推定費用は約580分の1でした。その代わり、Fableが七つすべてを検出したのに対し、Jevは六つです。逃した一件は三回の試行すべてで同じように見逃しました。安いモデルを繰り返せば偶然の揺れは減らせても、同じ読み違いを繰り返す系統的な誤りは消えません。17
早期アクセスを得た開発者のMichael Leeは、分類やモデルの振り分けなど約5000リクエストを約2ドルで試し、中央値約150ミリ秒、95パーセンタイル約350ミリ秒だったと報告しました。N8 Programsは、MMLUやGPQAなどの多肢選択問題でJevを思考なしのGPT-5.6 Terraと比較し、知識と言語推論では近い結果、数学では明確に劣るとしています。返した確率と実際の正答率のずれは平均1.74ポイントで、課題によって0.26から6.96ポイントの幅がありました。どちらも一人の環境での初期報告です。1819
公開初期の第三者試験は、速度と低価格については提供元の主張と整合します。精度は仕事によって変わり、長期運用と日本語の評価はまだ空白です。
ハルシネーションゼロは正答率100%ではない
TypeSafeはJevについてハルシネーションしないと表現します。ここで保証されるのは、定義していない部署名、壊れたJSON、説明文を突然返さないことです。Choiceの候補が「請求」「技術」「契約」なら、必ずその範囲の型に合う値を返します。公開評価の型エラー0%も実測ではなく、定義した型に合わない値を出せない設計から来る数字です。1
しかし、技術問い合わせを「請求」と誤分類することはあります。存在しない道具名は作らなくても、許可された道具の中から危険なものを選ぶ可能性は残ります。The Registerも、構造化された回答は誤判断を排除しないため、通常のLLMと同じ意味でのハルシネーションゼロと比べるのは公平でないと指摘しています。形式は壊さないが、判断は間違える。導入の設計はこの前提から始まります。20
確率にも同じ注意が要ります。較正とは、モデルが似た100件へ0.9を返したなら、そのうちおよそ90件が正しい、という集団単位の性質です。個別の一件が90%の確率で正しいという保証ではありません。JevのChoiceとScoreが返す確信度も、候補間の確率分布がどれだけ一つへ集中したかを要約した値です。入力の言語、顧客層、業務規則、モデル版が変われば、確率の意味もずれます。0.9以上を自動処理する、と先に決めるのではなく、自社の過去事例で0.9帯が実際に何割正しいかを測り、誤りの損失に応じて閾値を決めます。816
比べる相手はLLMだけではない
JevをLLMとだけ比べると、最も近い代替を見落とします。有限の候補を高速に選ぶ仕事には、従来からルール、専用分類器、再ランキングモデル、小型LLMがあります。
| 手段 | 向く仕事 | 強み | 残る弱み |
|---|---|---|---|
| 決定的なコード | 金額計算、日付比較、上限、権限 | 正確、高速、監査しやすい | 曖昧な文章の意味を扱いにくい |
| 専用分類器・再ランキング | 大量で安定した一種類の判定 | 高速で自社最適化しやすい | 教師データ、学習、更新が必要 |
| Jev | 有限候補を持つ曖昧な意味判断 | 自然言語で問いを定義し、型と確率を返す | 自由文を作れず、内部構造は非公開 |
| 文章を生成するモデル | 計画、調査、文章、コード、未知の問題 | 開かれた候補を考え、理由を説明できる | 遅延と費用が大きく、出力が揺れる |
Jevが埋めようとしているのは、コードには曖昧すぎるが、推論LLMへ毎回考えさせるには狭すぎる判断です。「この問い合わせは怒りを含むか」「この実行記録は人が見るべきか」「どの文書が質問に最も関係するか」は、候補を先に決められても単純な文字列一致では解けません。79
一方、十分な教師データがある一種類の分類なら、専用分類器の方が速く、安く、社内で管理しやすい可能性があります。TypeSafeの発表には、最適化した専用分類器との同条件比較がありません。Jevの新規性は分類ができることではなく、専用学習なしに多様な意味判断を一つのAPIで扱い、確率付きで大量に並列処理できるという主張にあります。独立した比較が出るまで、ここがJevの評価で最も大きな空白として残ります。
一つの繰り返し判断から始める
2026年9月17日時点で、Jevは早期アクセスです。コンソールは誰でも開くことができ、Googleアカウントかメールアドレスでのログイン画面が表示されます。ただしAPIの呼び出しにはAPIキーが必要で、その入手手順は公開ドキュメントに書かれていません。公式は待機リストから順次招待すると説明しています。日本語性能の公開評価もありません。手元で呼び出せるようになったときのために、向く仕事と最初の試し方を整理しておきます。1213
Jevに向く仕事には四つの条件があります。答えの候補を先に定義できること、入力の意味を読まないと決められないこと、同じ判断を大量に繰り返すこと、誤りを検知して保留や修正ができることです。問い合わせの振り分け、優先度判定、エージェント実行記録の監視、文書候補の選別、LLM出力の規則違反検査が当てはまります。向かないのは、自由な文章やコードの生成、未知の選択肢の発見、厳密な算数と日付比較、長い多段階推論、画像や音声の直接理解です。送金、診断、採用、不正利用の断定など、誤りの影響が大きく説明責任もある判断を、確率一つで自動実行してはいけません。11
始め方は一つに絞ります。いま小型LLMか人が繰り返している判断を一つ選び、過去事例から通常の例、難しい例、候補外、情報不足、敵対的な入力、日本語の言い換えを集めます。比較相手には現在のルール、専用分類器、小型LLMを並べ、同じ事例で正解率、見逃し、誤警告、確率の較正、95パーセンタイルの待ち時間、一件当たり費用を測ります。最初は実際の処理を変えない並走期間とし、入力、質問、返った確率、モデルの固定バージョン、コードが選んだ経路、最終結果を記録します。jev-latestは更新で中身が変わるため、閾値を調整した後はjev-1.13.0のような固定IDを使い、新版へ移る前に同じ事例で測り直します。10
ボトルネックは意思決定の設計へ移る
JevはLLMを置き換えません。文章、コード、計画、未知の問題を扱うLLMと、正確な計算や権限を担うコードの間に、意味を読んで有限の候補を選ぶ部品を置こうとしています。組み込むと作業がなくなるのではなく、場所が変わります。必要になるのは、長いプロンプトの調整ではなく、漏れのない候補、一つの意味に絞った質問、損失に応じた閾値と例外経路の設計です。モデルが説明を書かない分、なぜその処理へ進んだかを追える記録もアプリケーション側で作ります。1417
公開初期の証拠は、速度と費用については有望です。精度は仕事によって差があり、日本語、長期の確率較正、価格とサービス水準の持続性は未確認のままです。Almeidaが立てた問いは残ります。チャットで超人的なモデルがあるのに、自動化はなぜ進まないのか。答えの一つが、判断のたびに文章を書かせていたことだとすれば、意味の判断を小さく分け、LLMの前後へ何度も置くことで、安いモデルとコードを組み合わせて失敗を途中で止められるかもしれません。成否を判断する基準は、公表された倍率ではなく、その構成が自社の失敗率と処理時間をどこまで下げるかです。
参照リンク22件
- TypeSafe AIIntroducing System One Models & Jev
- TypeSafe AITeam
- Ouyang et al.Training language models to follow instructions with human feedback
- Christiano et al.Deep reinforcement learning from human preferences
- DCVCTypeSafe emerges from stealth with a new way of doing AI
- SiliconANGLETypeSafe AI exits stealth with $40M to build AI for use by software
- TypeSafe AI DocsIntroduction
- TypeSafe AI DocsSystem One
- TypeSafe AI DocsPrimitives (Questions)
- TypeSafe AI DocsModels
- TypeSafe AI DocsModel jaggedness — Jev 1.13
- TypeSafe AI DocsAPI reference
- TypeSafe AIConsole
- TypeSafe AI業務フロー評価
- TypeSafe AISystem One Adapter for Python
- TypeSafe AI DocsConfidence
- EveryMini-Vibe Check: TypeSafe's Jev Judged Everything I’ve Written in 0.7 Seconds
- Michael Lee(X)約5000回のJev早期試用
- N8 Programs(X)JevとGPT-5.6 Terraの多肢選択評価
- The RegisterTypeSafe AI debuts model for machines that plays Doom
- The DecoderFormer OpenAI researcher builds an AI model that judges options instead of writing text
- Ju Lin's AI WeblogJev: State In, Typed Decisions Out
2026年9月17日時点の公式資料を確認しています。仕様は更新される可能性があります。