AIエージェントに収集用の道具を渡すと、Webページから商品名や価格を抜き出し、比較できる表にまとめる作業まで任せられます。ただし、サイトに接続すること、必要な項目を取り出すこと、対象を漏れなく集めることは、それぞれ別の仕事です。Agent-Reach、Patchright Enhanced、Scraplingの公開資料を調べ、そのうちScraplingで練習用ページからの抽出を試しました。道具の選び方と、取得漏れを確かめる方法を整理します。
20件の表ができても全件を集めたとは限らない
Web調査で手間がかかるのは、ページを見つけた後にもあります。商品名と価格を表へ移す、別のページで同じ項目を探す、更新前の値と比べる。決まった項目を繰り返し集める作業なら、AIが抽出用のプログラムを作り、実行結果を確かめる使い方ができます。
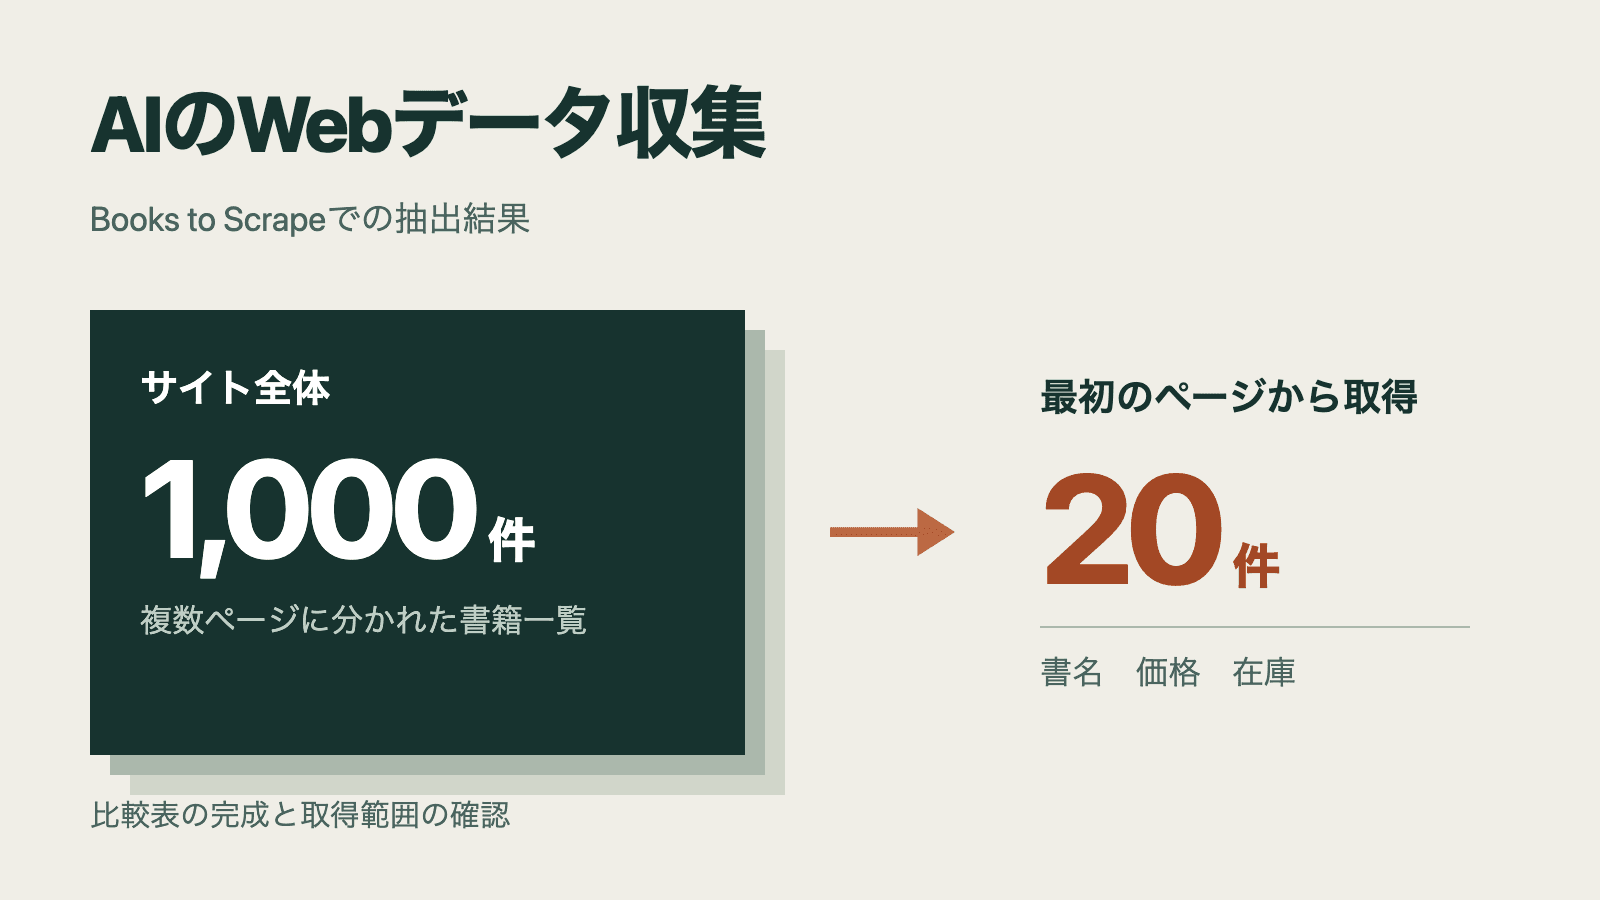
筆者は、スクレイピングの練習用に公開されているBooks to Scrapeで試しました。スクレイピングとは、Webページから必要な情報をプログラムで取り出すことです。ページを1枚取得して保存し、プログラミング言語Pythonで使うデータ抽出ライブラリScraplingで、書名・価格・在庫表示を読み取りました。次は、取得した20件のうち先頭の3件です。価格も在庫も練習用のデータです。
| 書名 | 価格 | 在庫表示 |
|---|---|---|
| A Light in the Attic | £51.77 | 在庫あり |
| Tipping the Velvet | £53.74 | 在庫あり |
| Soumission | £50.10 | 在庫あり |
20件すべてで書名・価格・在庫の欄が埋まり、先頭3件は保存した元ページの値とも一致しました。ただ、元ページが示すのは全体で1,000件、そのうち1〜20件を表示しているという範囲です。今回取り出したのは最初の1ページ分で、残り980件には進んでいません。
「最初のページにある商品を集める」という依頼なら、今回の20件で範囲を満たします。「このサイトの商品をすべて集める」なら、残りのページも対象です。同じ表でも、何を依頼したかで完了の判断が変わります。
全件収集を任せるなら、元ページの件数表示と取得件数を突き合わせ、同じ商品を重ねて数えていないかも確認します。途中で止まった場合は、取得できた範囲と未取得の範囲を分けて返すところまで依頼します。AIへの指示で先に決めたいのは、表の見た目より、どの範囲がそろえば仕事を終えてよいかです。
3つの道具は収集の違う工程を受け持つ
道具を選ぶときは、接続できないのか、ページの中身を取り出せないのかを分けて考えます。動画やSNSごとの準備を減らしたいならAgent-Reach、ブラウザを動かす処理ならPlaywright系、同じ項目を抜き出す処理ならScraplingが候補です。収集先とページの作りに応じて、必要なものを選びます。
| 道具 | 主に受け持つ仕事 | 選ぶ場面 | 導入後も確かめること |
|---|---|---|---|
| Agent-Reach | サービス別の取得ツールの導入や設定を案内し、使える経路を調べる | 動画、SNS、Webページなど複数の接続先を扱いたい | 各接続先の認証、取得条件、実際の動作 |
| Patchright Enhanced | Patchrightを使ったブラウザの起動や設定をまとめる | ブラウザを操作する収集処理を開発したい | 欲しい通信の特定、抽出コード、利用条件 |
| Scrapling | ページの取得や、ページ内の項目の抽出を支援する | 書名・価格など決まった項目を取り出したい | 抽出位置の正しさ、ページ分割、取得漏れ |
Agent-Reachは、GitHubアカウントのPanniantongが公開する、AIエージェント向けの道具の導入・診断ツールです。たとえばYouTubeには動画情報や字幕を取得するyt-dlp、一般のWebページには本文を読みやすい形に変換するJina Readerなど、接続先に応じた別のツールを使います。エージェントが、それぞれの呼び出し方を理解するための説明も用意されています。
便利なのは、接続先ごとに使う道具を一から探す手間を減らせることです。一方、2026年9月16日に公開コードを読んだ範囲では、XやRedditの経路にはログイン情報などの準備が残ります。診断で認証情報の存在を確認できても、実際の検索まで成功したとは限りません。Agent-Reach本体に利用料がなくても、接続先サービスの利用や、字幕のない動画を音声から文字に起こす処理などに費用がかかる場合があります。
Patchright Enhancedは、GitHubアカウントのwhaleyxbtが公開するブラウザ起動用のプログラムです。土台のPatchrightは、Microsoftのブラウザ操作ライブラリPlaywrightを改変したものです。作者は、サイト側が自動操作を見分ける手がかりを減らす変更を説明していますが、今回その効果は検証していません。公開されている使い方では、設定した接続経路でブラウザを起動し、指定ページを開きます。集めたいデータを指定すれば分析まで完成する製品ではなく、収集処理を作る開発者向けの部品として見ると位置づけが分かります。確認時点では、このリポジトリ独自のライセンス表示も見当たりませんでした。通信からデータを読むことが目的なら、次の節で試すPlaywrightの標準機能から検討できます。Patchright Enhancedを業務へ組み込む候補にする場合は、利用条件の確認も残ります。
Scraplingは、GitHubアカウントのD4Vinciが公開するPythonライブラリです。ページの読み取りと項目の抽出を扱い、AIから外部の道具を呼び出す共通の接続方式MCPにも対応しています。今回動かしたのは、保存済みのページを解析する機能です。ブラウザを動かす追加機能や、サイトのアクセス制限への対応は試していません。
画面の裏で届くデータを読む方法
ページの構造を記したHTMLを取得しても、商品一覧が入っていない場合があります。Webサイトによっては、最初に画面の枠だけを送り、ブラウザがJavaScriptで書かれたプログラムを実行してから、商品データを追加で読み込むためです。人には一つのページに見えていても、裏では複数回の通信が起きています。
この場合、ブラウザを動かし、表示に使われた通信の応答から商品名や価格を取り出す方法があります。プログラム同士がデータをやり取りする窓口をAPIと呼びます。外部開発者向けの公式APIが公開されていなくても、そのサイトの画面自身が使っている窓口を観測できることがあります。

追加の通信からも商品を取り出せるか、筆者はパソコン内だけで動く試験ページで確かめました。架空の商品2件を表示し、同じ2件を追加の通信でも返すページをPlaywrightで開くと、応答から商品名と価格を取得できました。
最初のHTMLにも同じ2件を含めたため、この実験で確かめたのは通信応答を読む機能です。外部サイトに接続した結果や、Patchright Enhanced本体を動かした結果ではありません。
通信を観測する機能はPlaywrightにも標準で備わっています。Patchright Enhancedだけの特別な機能ではありません。通常のブラウザ操作で足りる仕事なら、まずPlaywrightで実現できるかを見る方が、追加する部品を減らせます。
ただし、ブラウザが受け取ったデータを読めることと、その通信先を自由に繰り返し利用できることは別です。ログイン状態や一時的な認証情報が必要な場合があり、画面の変更で通信方法も変わります。公式APIがあるなら、必要な項目や利用上限が目的に合うかを先に確認し、ブラウザを使う必要がある範囲を絞るのがよいでしょう。
ページの変更で抽出結果が0件になる
書籍の抽出では、「商品カードを選び、その中の書名、価格、在庫を読む」という指定を使いました。ページのどの部分を選ぶかを表す指定を、CSSセレクターと呼びます。AIはページの構造を読み、こうした指定を含むプログラムを書く役を担えます。
同じ保存ページで、商品カードに付いた分類名だけを変更すると、元の指定で取れた20件は0件になりました。商品の内容は消していません。ページ内で商品を見つける目印が変わっただけで、処理はエラーで止まらず、0件という結果を返しました。実サイトでの故障頻度を測った実験ではありませんが、収集に失敗しても空の一覧が返る場合があると分かります。
Scraplingには、保存した要素の特徴を手がかりに、ページ変更後の要素を探す機能もあります。今回の通常の抽出でその復元機能は使っておらず、変更への追従性能は未検証です。継続的な収集に採用するなら、自分が読むページで目的の商品や価格を選べるかも試す必要があります。
0件になったときに「商品がなくなった」と報告してしまうと、収集の失敗が市場の変化に化けます。日々の価格監視などに使うなら、前回の件数、今回の件数、読み取れない項目を記録し、急な変化を見つけたら元ページを開き直す工程を入れます。AIに修正を任せる場合も、直した後に同じ商品を選べているかを照合します。
SNSの投稿分析には取得漏れと偏りが残る
「100アカウントの直近1か月を集め、伸びている話題を調べる」という依頼は、完成するレポートを想像しやすいものです。この依頼では、ページから項目を抜き出すことに加えて、指定した期間と対象をどこまで集められたかを確かめます。さらに、集めた投稿からどんな判断ができるかには、データの偏りも関わります。
| 分析で知りたいこと | 収集時に確かめる条件 |
|---|---|
| 直近1か月の投稿傾向 | 指定期間の末尾までたどれたか、取れなかったアカウントがないか |
| 人気のある話題 | 何を人気とするか、反応数をいつ取得したか、投稿後の経過時間が違わないか |
| 商品への不満 | 本文・返信・字幕のどれを読んだか、重複や広告をどう扱ったか |
たとえばYouTubeの動画字幕を集めても、視聴者が書いたコメントの分析にはなりません。Redditの検索結果から拾った投稿も、分析対象の商品の利用者全体の意見を代表するとは限りません。どこから何を集めたかが曖昧なまま、AIが流暢に要約すると、偏りが見えにくくなります。
今回、X・YouTube・Redditでの大量収集は実行していません。3つの道具を導入すれば、指定期間の全投稿を漏れなく取得できると確認したわけでもありません。SNS分析に広げるなら、最初は少数の対象で、実際に見える投稿と取得結果を照らす必要があります。取得できなかった範囲は、分析結果と一緒に示します。
最初は少数ページの比較表を任せる
筆者の提案は、公開されていて取得条件を確認できる少数のページから、同じ項目を集める仕事で始めることです。複数の料金ページや製品仕様を比べるなら、抜き出す項目と照合先が明確です。最初からSNS全体の評判を求めるより、結果が正しいかを人が確かめやすくなります。
エージェントへの依頼は、たとえば次のように具体化できます。
指定した5つの公開ページから、製品名、月額料金、通貨、料金の適用条件を表にしてください。各行に元ページのURLと取得日時を付けてください。見つからない項目は推測で埋めず、未取得としてください。ログインが必要になったりアクセスを拒否されたりしたら停止して報告し、最後に5ページすべてを確認できたかを示してください。必要な情報が続きのページに分かれている場合は、その旨も報告してください。
実行の手順は、まず1ページを読み、項目を抽出して元の表示と照合するところから組みます。HTMLから直接読めるか、ブラウザ操作が必要かも、その段階で見分けます。照合できたら依頼した範囲の残りへ進み、0件や項目の欠落があれば元ページと抽出の指定を見直します。アクセスを拒否されたページは、失敗の理由とともに報告する対象です。

収集したページに「この指示に従え」と書かれていても、それは調査対象の文章として扱います。データを読む仕事へ、アカウント設定の変更や外部送信の権限まで付ける必要はありません。新しい道具は専用の実行環境で試し、普段使うブラウザのログイン情報を最初から渡さないようにします。
今回のScraplingの試用も、2026年9月16日に、macOS上の専用Python環境で練習ページ1枚を保存して解析する範囲にとどめました。保存したHTMLと抽出結果を照合し、SNSの認証情報は使っていません。接続先への通信を担うScraplingの機能や、継続運転の安定性は未検証です。
比較表が一度正しく作れたら、次は同じページで再実行し、価格や条件の変化と、取得の失敗を区別できるかを確かめます。そこまでできてから定期実行へ進めば、毎回ページを見て回る仕事を、変更があった行と未取得の行を確認する仕事へ変えていけます。