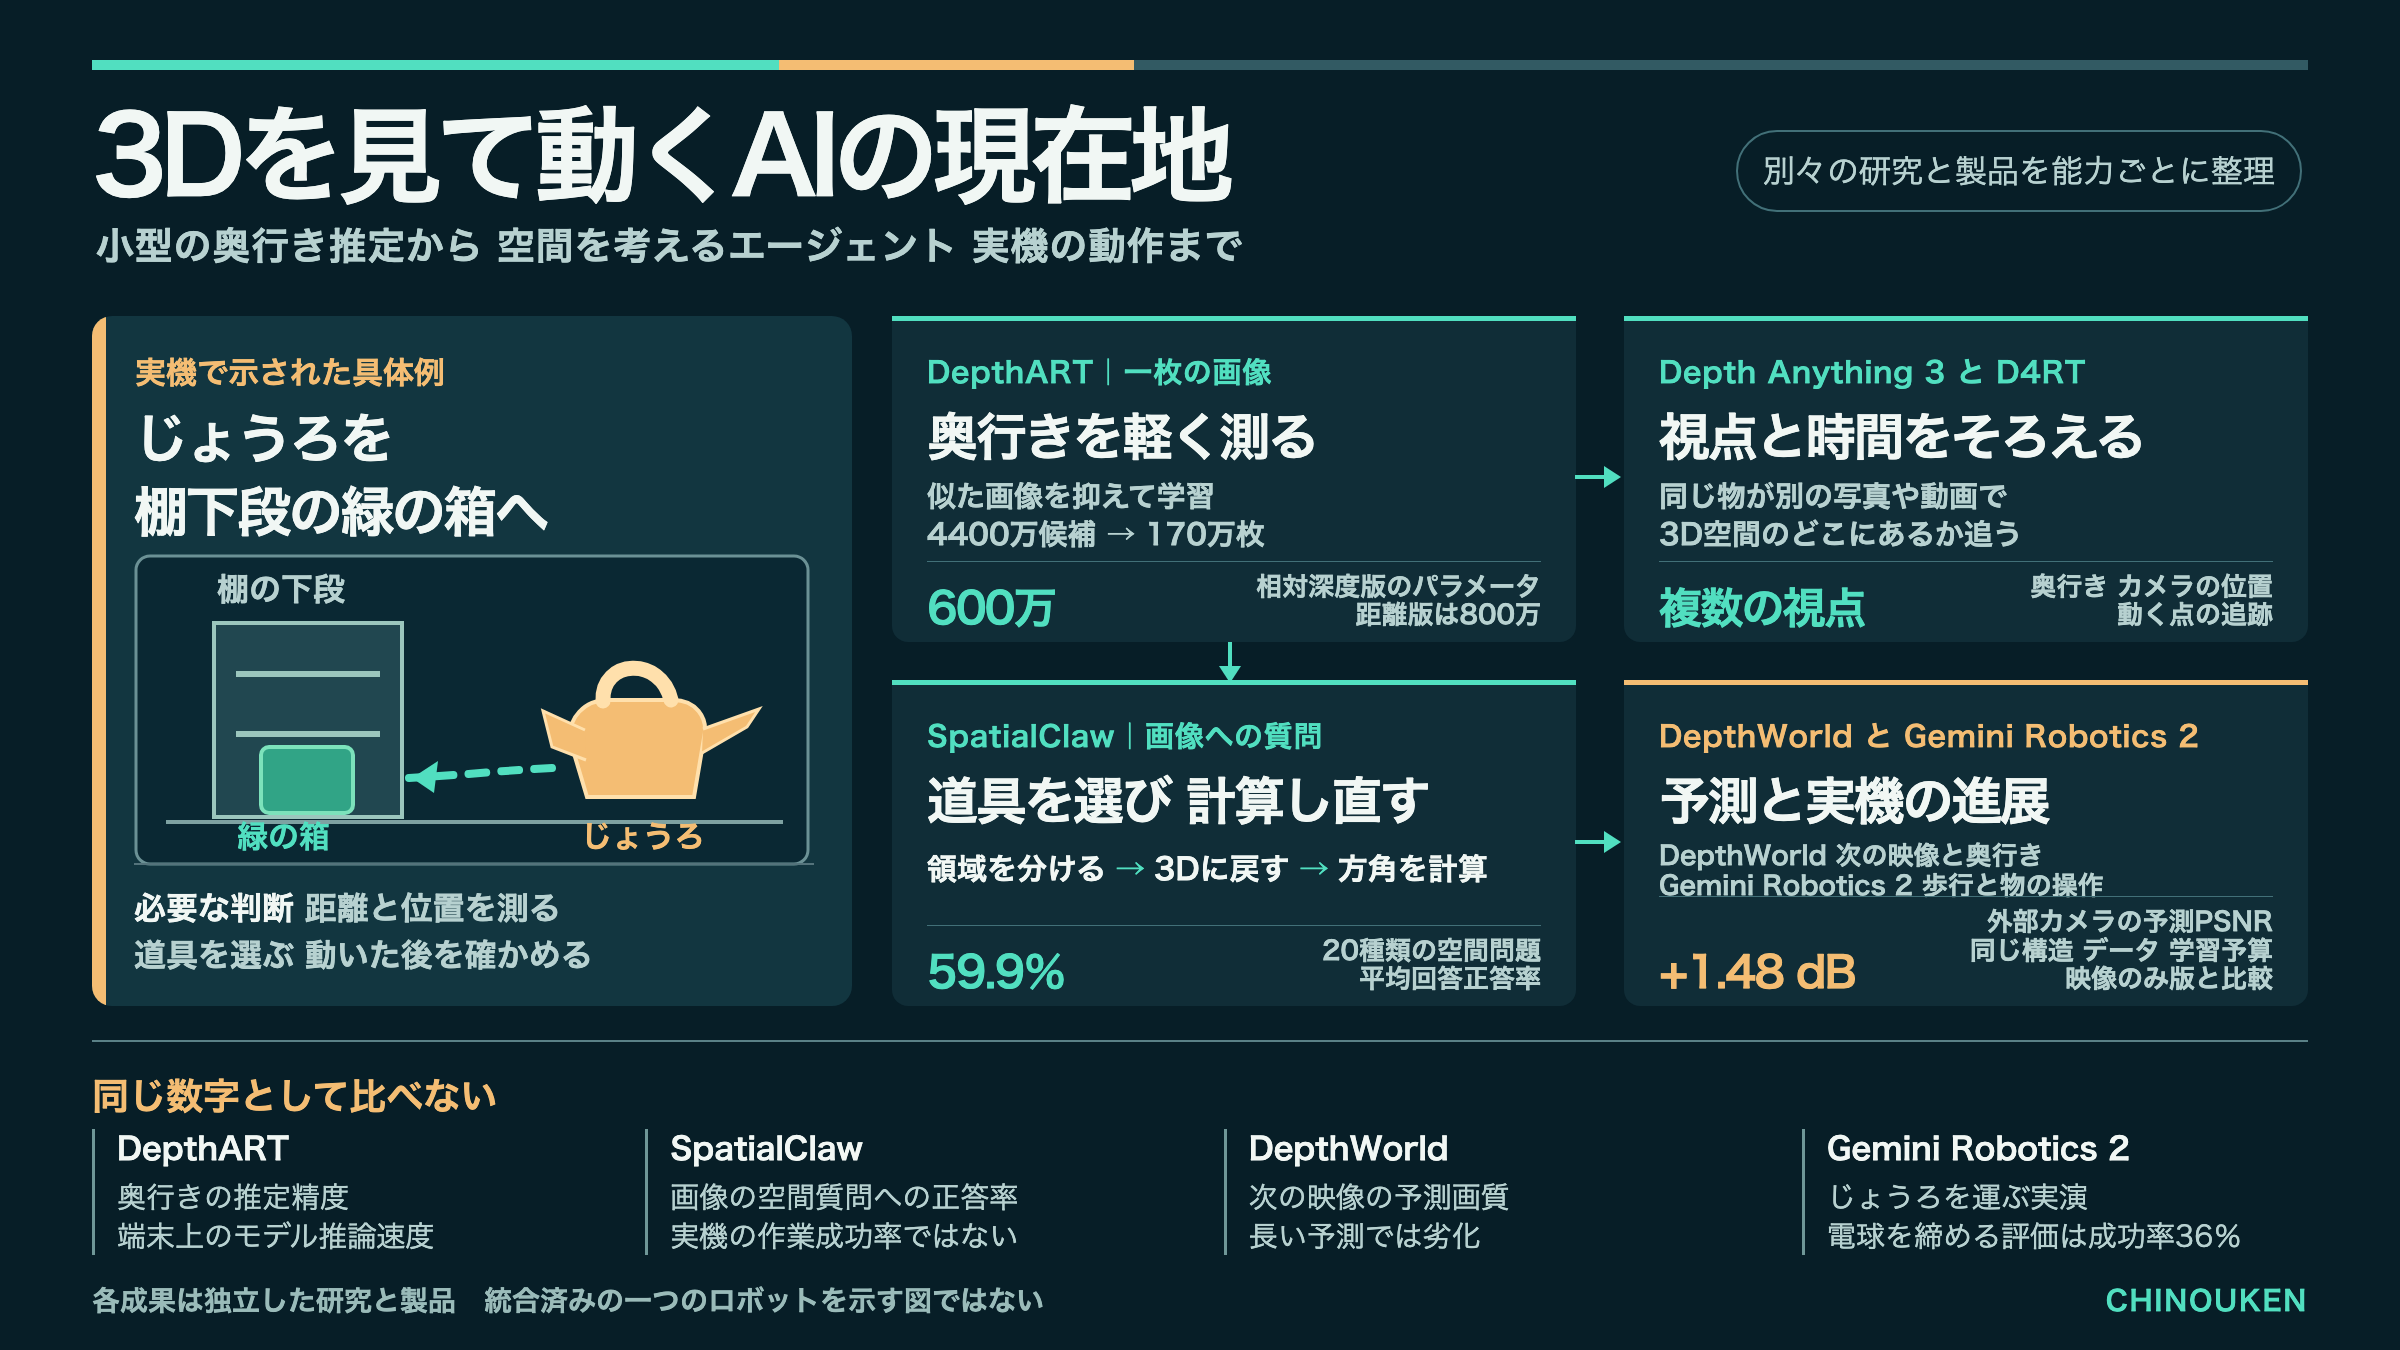
カメラの画像から物の手前・奥を推定するAIが、約600万パラメータで動くようになりました。一方、部屋の中で物を探し、つかみ、指定された場所へ置くロボットには、実際の距離に加えて物の位置関係、動き、行動後の確認が要ります。DepthARTを入口に、3Dを捉える研究とAIエージェントの技術が2026年にどこまでつながったか、論文の測定値と実機で示された動作を分けて読みます。
画像に奥行きが加わると何が変わるか
「じょうろを棚の下段にある緑の箱へ入れて」とロボットへ頼む場面を考えます。カメラ画像には、じょうろ、棚、箱が平面上の色と形として映ります。ロボットが歩いて手を伸ばすには、それぞれがどの方向にどれほど離れ、手前の物が奥の物を隠していないかを知る必要があります。腕を動かした後には、じょうろをつかめたか、箱がまだ同じ場所にあるかをもう一度確かめなければなりません。
一枚の画像から画素ごとの奥行きを推定する技術は、この仕事の入口です。近い部分と遠い部分の並びを表す「相対深度」があれば、物の前後や境界を読みやすくなります。ただし相対深度の値だけでは、棚まで何メートルあるかは決まりません。実際の距離を扱う「メートル単位の深度」には、カメラの焦点距離などの条件も関わります。さらに、画像の外にある物や、カメラ自身が動いた後の位置を知るには、複数の視点や時間を通した情報が要ります。1
2026年には、この一連の仕事が別々の研究で進んでいます。小さな端末で奥行きを推定するDepthART、視点や時間をまたいで3Dの形と動きをそろえるモデル、必要な視覚の道具を選んで空間問題を解くエージェント、実際に身体を動かすロボットです。いずれも「3Dを理解したAI」と呼ばれる一方で、示した能力と試験の条件は異なります。
DepthARTは小さな端末で奥行きを推定する
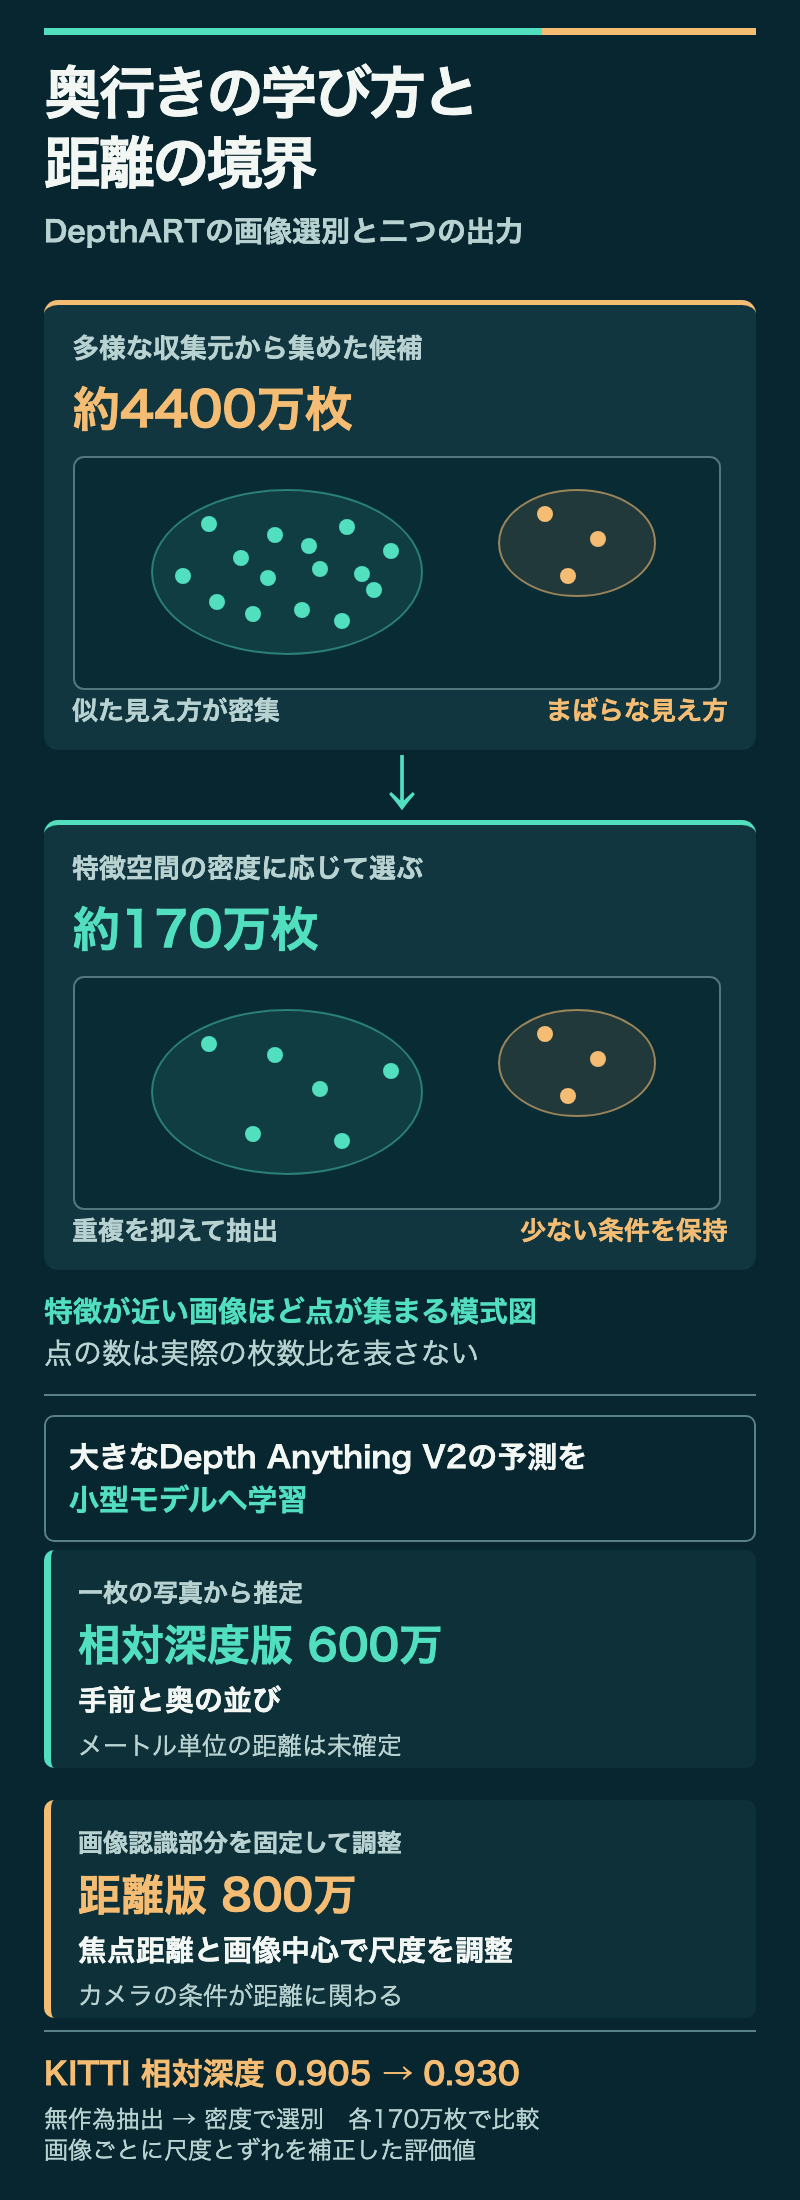
DepthARTは、写真一枚から奥行きを推定するAIを、端末で動かせる大きさへ縮めた研究です。カメラを積んだ機器では、映像を受け取るたびに距離を計算するため、モデルが大きいほど計算時間と電力が重くなります。研究チームが2026年7月に公表した最小の相対深度モデルは600万パラメータです。論文はACM Multimedia 2026への採択を記載しています。1
小型化の鍵は、モデルの構造だけでなく学ぶ画像の選び方にもあります。研究チームは約4400万枚の候補を画像全体の見え方で整理し、似た画像が密集した領域からの抽出を抑えました。最終的に約170万枚を学習へ使い、大きなDepth Anything V2の予測を小型モデルへ学ばせています。都市の道路や似た構図の室内ばかり覚えると、初めての場所へ移ったときに奥行きが崩れやすい、という問題への対応です。1
同じ170万枚、同じ学習条件で画像の選び方を変えた論文内比較では、未学習のKITTI画像に対する相対深度の指標が、無作為抽出の0.905から提案手法の0.930へ上がりました。これは予測結果を画像ごとに尺度とずれで合わせた評価です。ロボットが0.930の確率で正しく物をつかむ、あるいは距離をメートル単位で測れた、という数字ではありません。1
距離をメートル単位で出す版では、学習した画像認識部分を固定し、カメラの焦点距離や画像中心を使って距離の尺度を調整します。公式プロジェクトの表記は相対深度の最小版が600万、距離版の最小版が800万パラメータです。投稿で見かける「600万で距離まで推定」という読み方は、この二つの版を混ぜてしまいます。12
複数の視点と時間から3D空間をそろえる
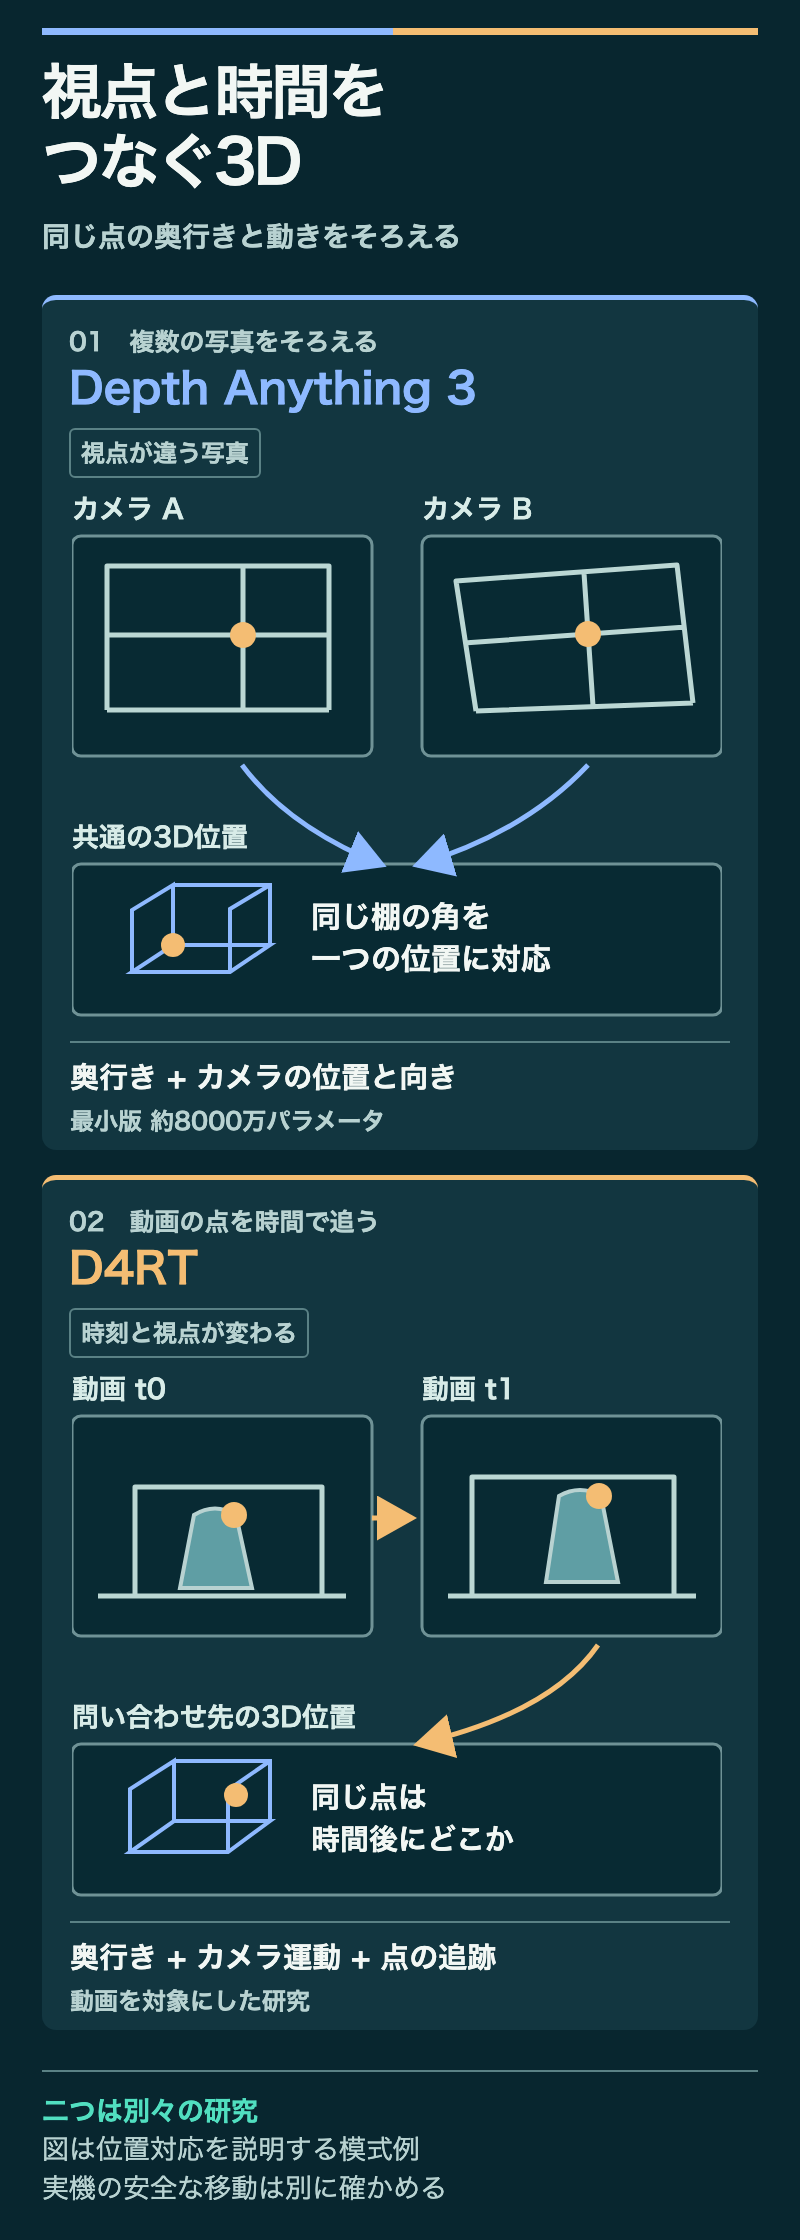
奥行き画像を一枚ずつ得ても、ロボットが移動すると同じ棚が画面の別の位置へ映ります。どの点が同じ物に属し、カメラがどこへ動いたかをそろえて初めて、部屋の形を継続して扱えます。この段階を狙うのが、Depth Anything 3やD4RTのような研究です。
2025年に公表されたDepth Anything 3は、一枚または複数枚の画像から奥行きとカメラの位置・向きを推定し、視点の間で整合する3D情報を作ります。公式の小型版でも約8000万パラメータで、DepthARTの600万とは出力する情報と想定する計算量が違います。両者の数字だけを並べて性能順位は付けられません。34
動画では、机に置いた物も人も、カメラと一緒に動いて見えます。Google DeepMindが2026年1月に紹介したD4RTは、動画中のある画素が別の時刻・視点では3D空間のどこにあるかを問い合わせる方式です。一つの仕組みから奥行き、カメラの動き、点の追跡を取り出します。研究チームは対象課題で処理速度と復元精度の改善を示していますが、この発表だけでロボットが周囲を安全に移動できると実証されたわけではありません。56
空間エージェントは測定結果を使って考える
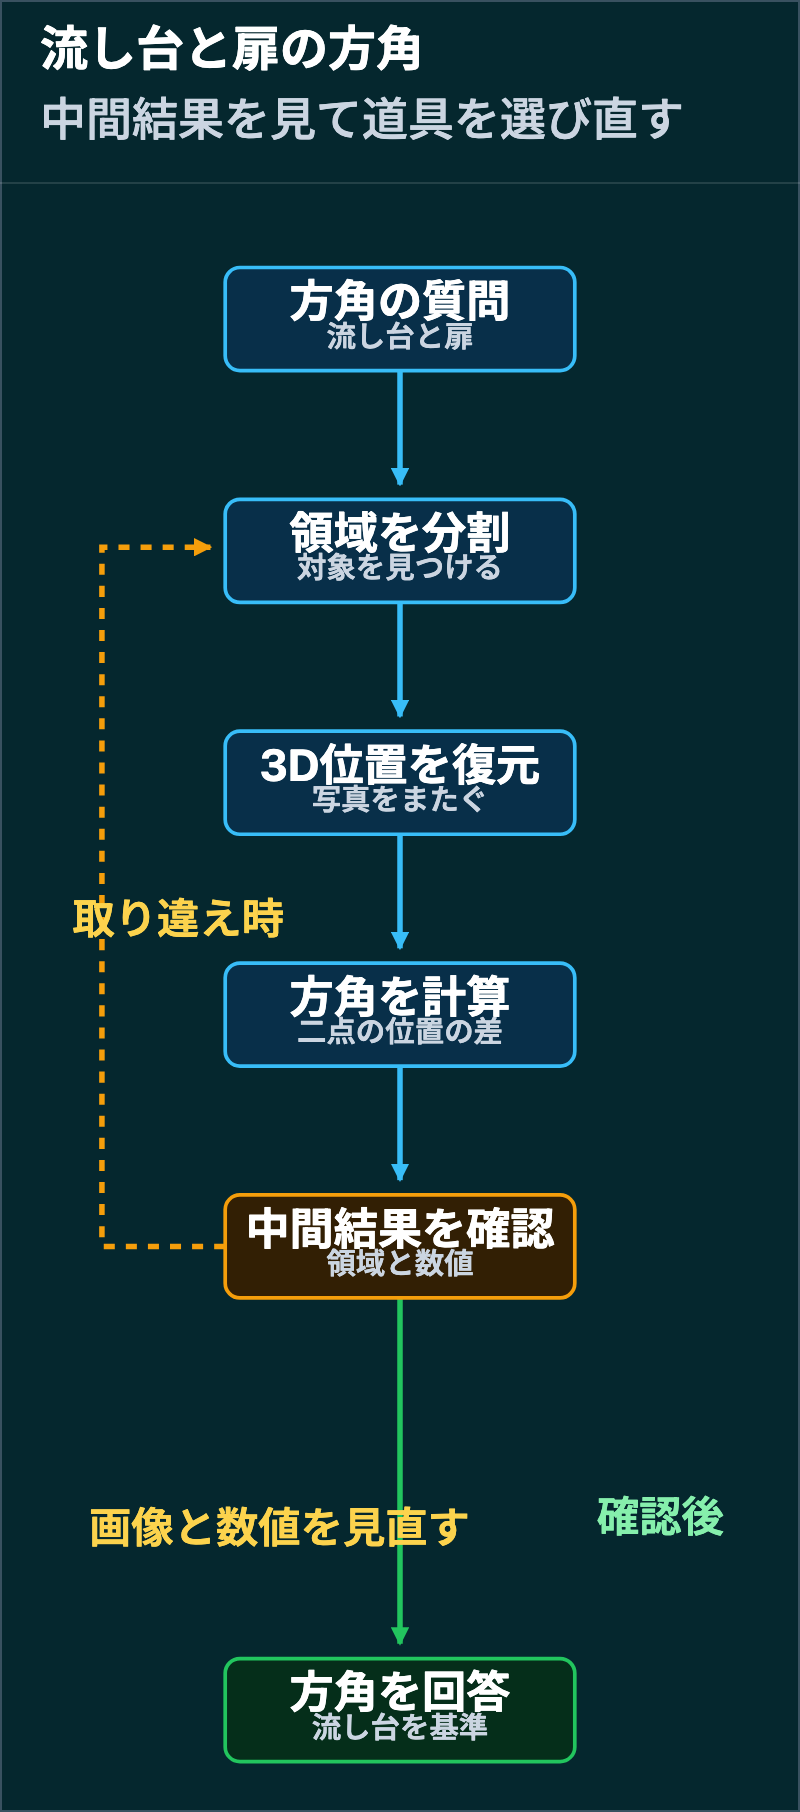
位置関係の質問へ答えるには、3Dの数値を出すだけでは足りません。たとえば「流し台を基準に、別の写真に写る扉はどちら側か」なら、流し台と扉の領域を見つけ、複数の写真から位置を復元し、基準の向きを決めて、二点の差を計算します。途中で物の取り違えに気づけば、領域の選び方からやり直す必要があります。
2026年6月のSpatialClawは、このような空間問題を解くエージェントの研究です。画像を読むAIが、領域分割や3D復元の道具を呼び、計算用のPython環境へ結果を保存します。一回の計算で終えず、表示された領域や数値を見て次の計算を選ぶため、最初の見立てが違えば手順を変えられます。研究チームの公開例には、流し台と扉を別の写真から見つけ、3D位置を求めて方角を計算する過程が収められています。78
論文では、画像と言葉を扱う基盤モデルにGemma 4-31Bを使い、20種類の空間問題で平均正答率59.9%と報告しています。同じ基盤モデルを使った比較対象より11.2ポイント高い結果ですが、残る約4割の誤答も見逃せません。測っているのは画像や動画への質問に正しく答えた割合です。ロボットが扉まで歩き、触れずに回り込み、物を運べた割合とは区別する必要があります。7
次の状態を予測してから動く研究
エージェントが「腕を伸ばす」と決めても、じょうろが倒れるか、棚の扉にぶつかるかは行動後まで分かりません。世界モデルは、現在の映像と操作から次に見える状態を予測し、行動を選ぶ手掛かりを作る研究です。見た目が自然な映像でも、別角度から見ると物の位置が食い違うなら、ロボットの判断材料としては使いにくくなります。
2026年10月6日に公表されたDepthWorldは、ロボット操作の動画にカメラ間の位置合わせとメートル単位の奥行きを加え、次の映像と奥行きを一緒に予測します。著者は、同じ構造・学習データ・学習予算でカラー映像だけを予測する版と比較しました。外部カメラから見た次のカラー映像は、PSNRという画質指標で1.48デシベル高い結果です。PSNRは予測画像と実際の画像の画素の差を測り、値が高いほど差が小さいことを示します。奥行きも一緒に学ぶと、この条件では映像の予測も改善しました。9
ただし評価の中心は、学習から取り分けた256のロボット操作軌跡で次の映像を予測することです。これらは学習時と同じ機体・研究室からのデータで、別の機体や研究室への広がりは測っていません。論文は、予測を長く繰り返すと画質が崩れる限界も記しています。世界モデルの出力でロボットが自律作業を何件完了したかは、この結果からは分かりません。9
実機では計画と身体の制御がつながり始めた
現実のロボットへ目的を渡すときは、部屋を見て作業順を決める役割と、腕や足を動かす役割が必要です。Google DeepMindが2026年7月に発表したGemini Robotics 2では、上位の推論モデルが依頼を解釈して進み具合を見守り、視覚・言語・行動モデルが画像と指示を身体の動作へ変えます。端末内で動かす版も別に用意しています。1011
公式実演には、ヒューマノイド型ロボットがじょうろを取り、歩いて棚の下段の緑の箱へ入れる場面があります。歩行と物の操作を一続きにした例として具体的です。一方、同じ発表の評価では、五本指の手で電球を締める課題の成功率は36%でした。実演された一件と、幅広い仕事を安定して任せられることの間にはまだ距離があります。高位の推論モデルは開発者が試せますが、行動モデルと端末内版の提供は早期アクセスの提携先向けです。1011
ここで紹介したDepthART、Depth Anything 3、D4RT、SpatialClaw、DepthWorldが、そのままGemini Robotics 2の内部で組み合わされているわけではありません。それぞれ別の研究・製品です。一緒に読むと、ロボットに必要な仕事が「見える物の距離」「視点をまたぐ位置」「目的に沿った道具の選択」「行動後の予測」「身体の制御と確認」に分かれていることが見えてきます。
進歩を判断するときに見る場所
研究成果を比べる前に、その発表が何を入力し、何を正解として測ったかを確かめると、能力の広がりを読み違えずに済みます。
| 研究・発表 | 示したこと | その結果だけでは分からないこと |
|---|---|---|
| DepthART | 一枚の画像から小型モデルで奥行きを推定 | 物を特定してロボットが作業を完了できるか |
| Depth Anything 3・D4RT | 視点や時間をまたぐ3Dの位置と動きの推定 | 実機が安全に行動を選び直せるか |
| SpatialClaw | 知覚の道具を組み合わせた空間質問への回答 | ロボットの運動が成功するか |
| DepthWorld | 奥行きを伴う行動後の映像予測 | 予測を使って長い作業を成功させられるか |
| Gemini Robotics 2 | 指示から歩行や物の操作へ進む実機例 | 幅広い環境と細かな作業での安定性 |
ここからは筆者の見立てです。DepthARTの意義は、3D認識のすべてを600万パラメータへ収めたことではなく、頻繁に更新する奥行きの推定を小さな機器で扱える道を広げた点にあります。別のモデルが物や視点をそろえ、エージェントが必要な計算を選び、行動の結果を見直す。この接続が進むほど、ロボットは初めての場所で役立つ仕事へ近づきます。
次に注目したいのは、奥行き画像やデモ映像の見栄えだけではありません。カメラを変え、物の配置を変え、人が近くを通る条件で、作業が最後まで終わる割合と失敗後の立て直し方です。小型化、3Dの整合性、推論、実機動作の成果を同じ試験へつなげたとき、空間エージェントの実力がよりはっきりします。
参照リンク11件
- Feng XueほかDepthART: Scaling Foundation Monocular Depth to Tiny Models
- DepthART研究チームDepthART公開リポジトリ
- Haotong LinほかDepth Anything 3: Recovering the Visual Space from Any Views
- ByteDance SeedDepth Anything 3公開リポジトリ
- Guillaume Le MoingほかEfficiently Reconstructing Dynamic Scenes One D4RT at a Time
- Google DeepMindD4RT: Teaching AI to see the world in four dimensions
- Seokju ChoほかSpatialClaw: Rethinking Action Interface for Agentic Spatial Reasoning
- SpatialClaw研究チームSpatialClaw公式プロジェクト
- Jai BardhanほかDepthWorld: 3D World Model for Robot Manipulation
- Google DeepMindGemini Robotics 2 brings whole body intelligence to robots
- Google DeepMindGemini Robotics On-Device 2 model card
2026年10月13日時点の公式資料を確認しています。仕様は更新される可能性があります。