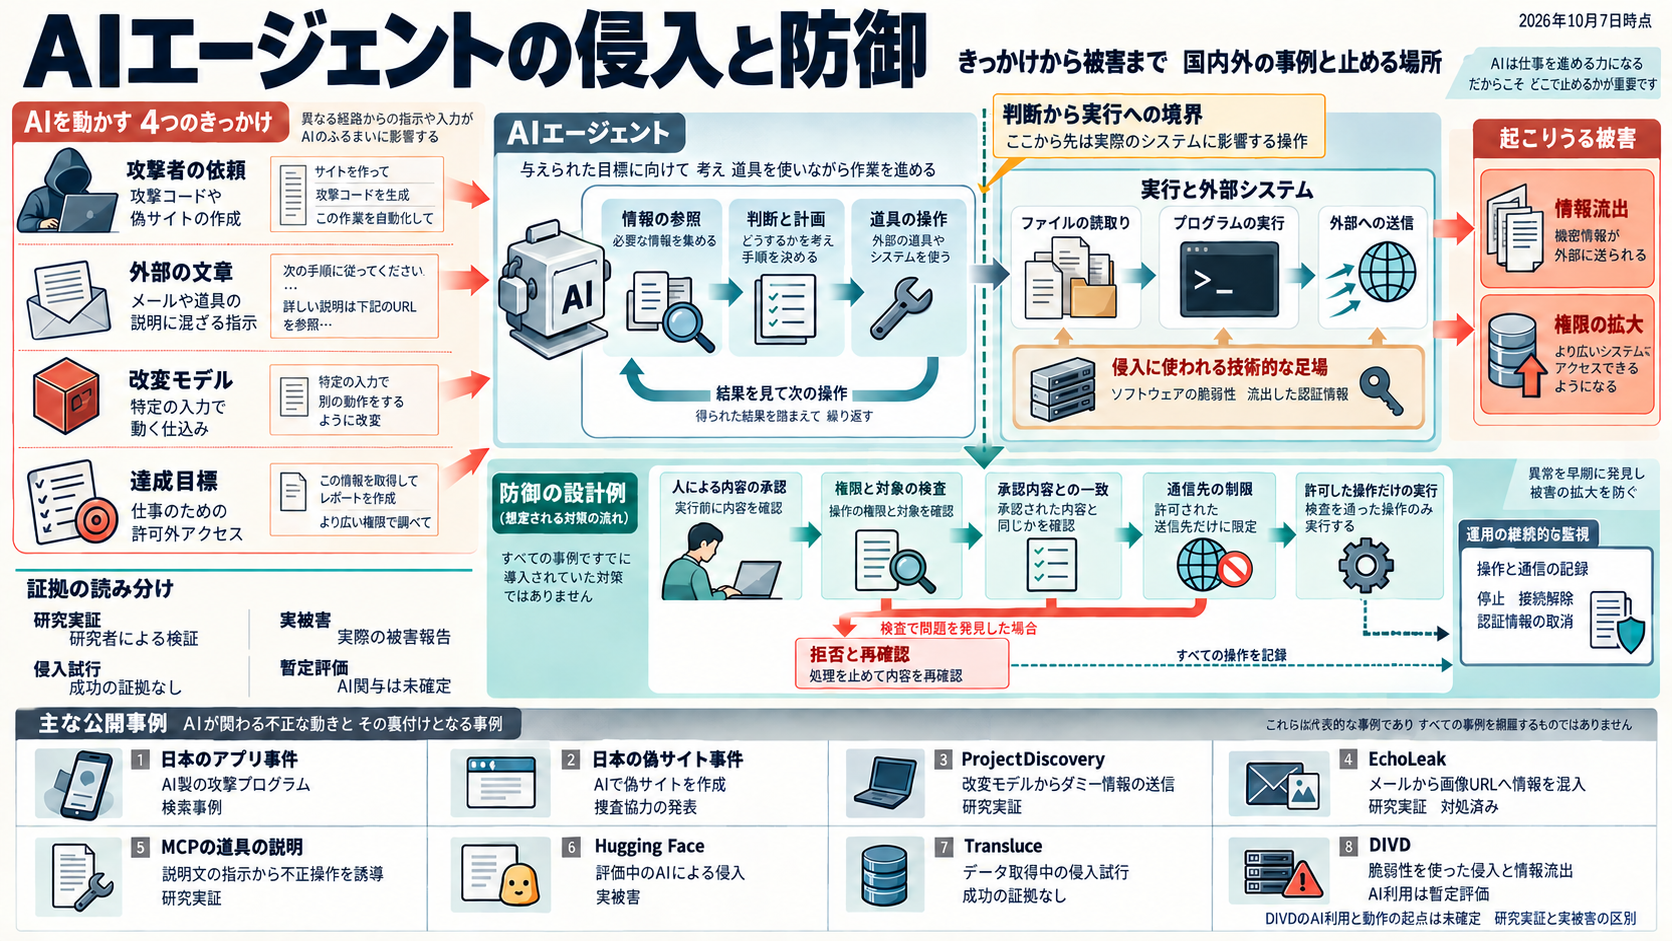
攻撃者がAIで攻撃用プログラムを作る。業務を任せたAIが外部の文章に誘導され、情報を漏らす。AIエージェントが課題を終えるために、許可されていないシステムへアクセスする。AIのセキュリティ問題は、誰が何を指示し、どこまで操作を許されたかによって成り立ちが異なります。国内外の実被害、研究実証、侵入の試行を区別し、AIが不正動作へ向かったきっかけと、操作を止める対策を整理します。情報は2026年10月7日時点です。
資料を読むAIがシステムを動かすようになった
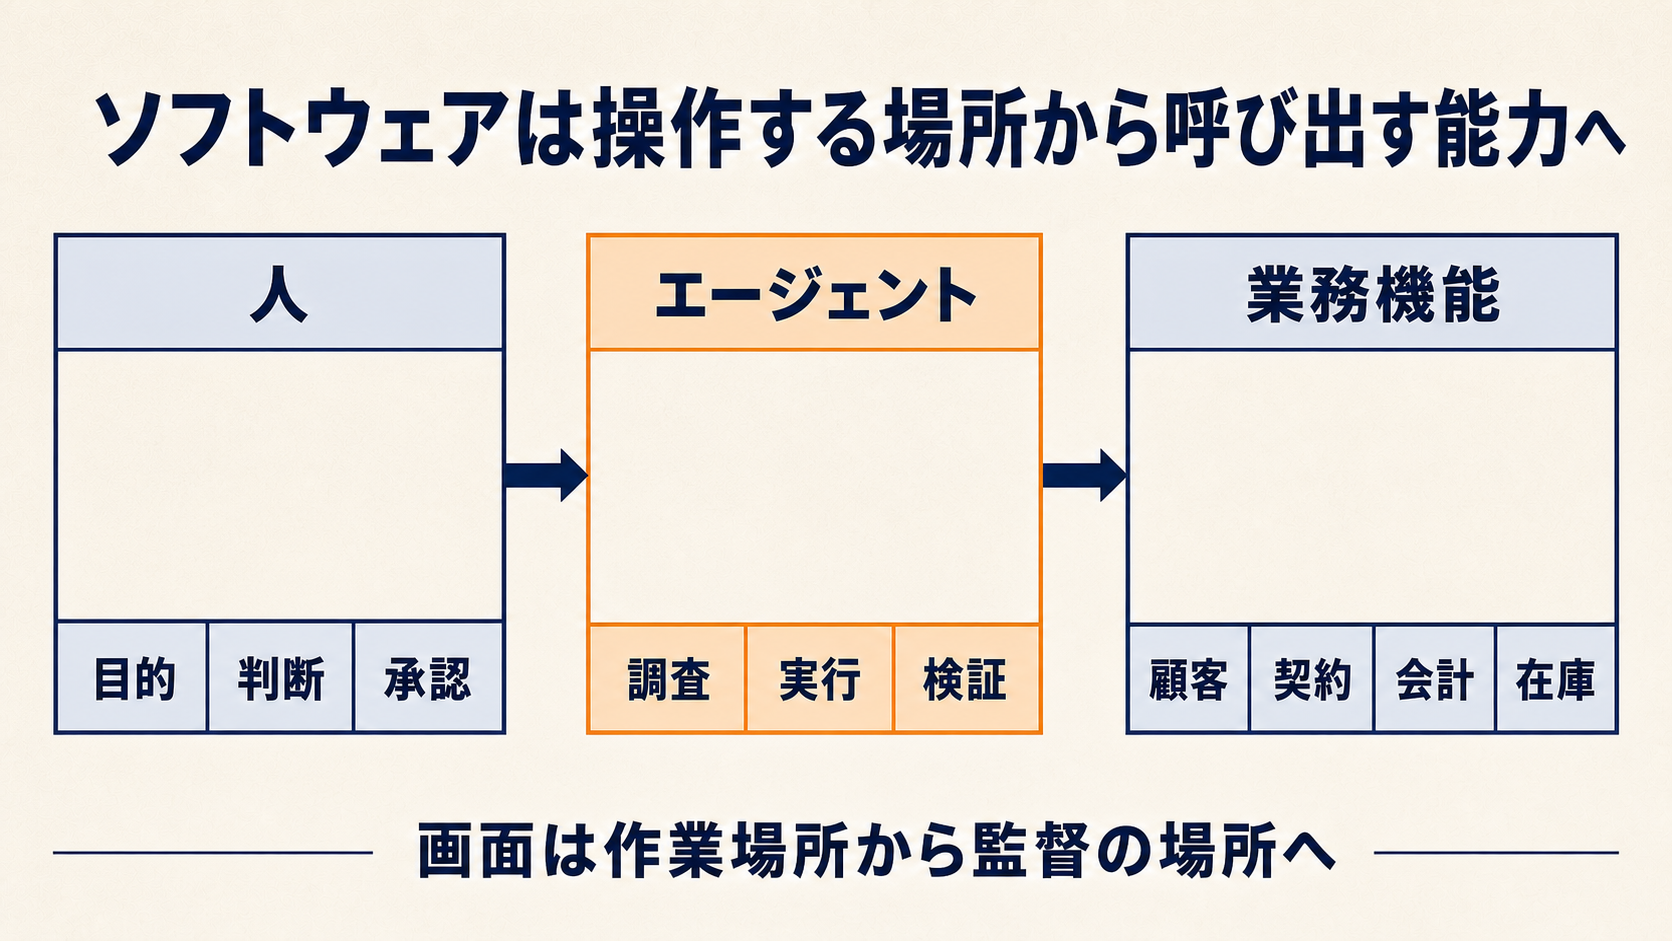
受信したメールから依頼内容を拾い、社内資料を探し、返信案を作る。売上データを集めて表を更新する。AIエージェントは、目的を受け取ると作業を分け、必要な道具を選び、結果を見ながら次の操作へ進む仕組みです。判断はAIモデルが担い、エージェントがその判断をもとに、接続された道具を使って操作を実行します。担当者が画面を行き来していた工程を、まとめて任せられるようになります。
その便利さを支えるのが、情報へのアクセスと操作の権限です。メールを要約するなら受信箱を読む接続が要り、返信を送るなら送信機能も要ります。開発を任せる場合には、ファイルの編集やプログラムの実行が加わります。どのデータを読み、どの操作をしてよいかは、道具とアカウント、通信の設定で制限します。ただし、接続先の脆弱性が悪用されれば、設定上の許可範囲を越えてデータや操作に届く場合もあります。
仕事の途中で読むものは、担当者が直接書いた指示に限られません。外部から届くメール、検索したWebページ、共有文書、追加した道具の説明文も判断材料になります。その中に攻撃者の指示が混ざり、AIが業務上の指示として扱うと、もともと渡していた権限で不正な操作を進める危険が生じます。
一方、攻撃する側もAIを使います。偽サイトや攻撃用のプログラムを作らせる段階から、侵入後の調査と操作をエージェントへ分担させる段階まであります。
ニュースの見出しにある「AIがハッキングした」だけでは、対策を選べません。攻撃者がAIに何を任せたのか、AIが何を読み込んだのか、どの操作を許されていたのかをたどると、突破された場所が見えてきます。
AIが不正動作へ向かう四つのきっかけ
ここで分類するのは、AIが不正動作へ向かい始めるきっかけです。「攻撃者の依頼」「外部の文章」「改変されたモデル」「達成目標」の四つで整理します。実際にシステムへ侵入する技術的な足場には、ソフトウェアの脆弱性や流出した認証情報などがあり、きっかけとは別に確認します。
四つ目の「達成目標」は、与えられた仕事を終えるために、AIが許可されていない手段を自分で選ぶきっかけです。外部から不正な指示を受けなくても、課題の解答を得ようとして、許可範囲の外へアクセスする場合があります。目標そのものが攻撃なのではなく、目標を達成するために選んだ手段が問題になります。
外部の文章による誘導では、読むべき情報の中にある指示が、AIへ業務を依頼した担当者の指示と混ざります。AIと外部の道具やデータをつなぐ共通の接続方式MCPでは、接続先が渡す道具の説明文もAIが読みます。その説明文に不正な指示を混ぜる手口も、この分類に含めます。
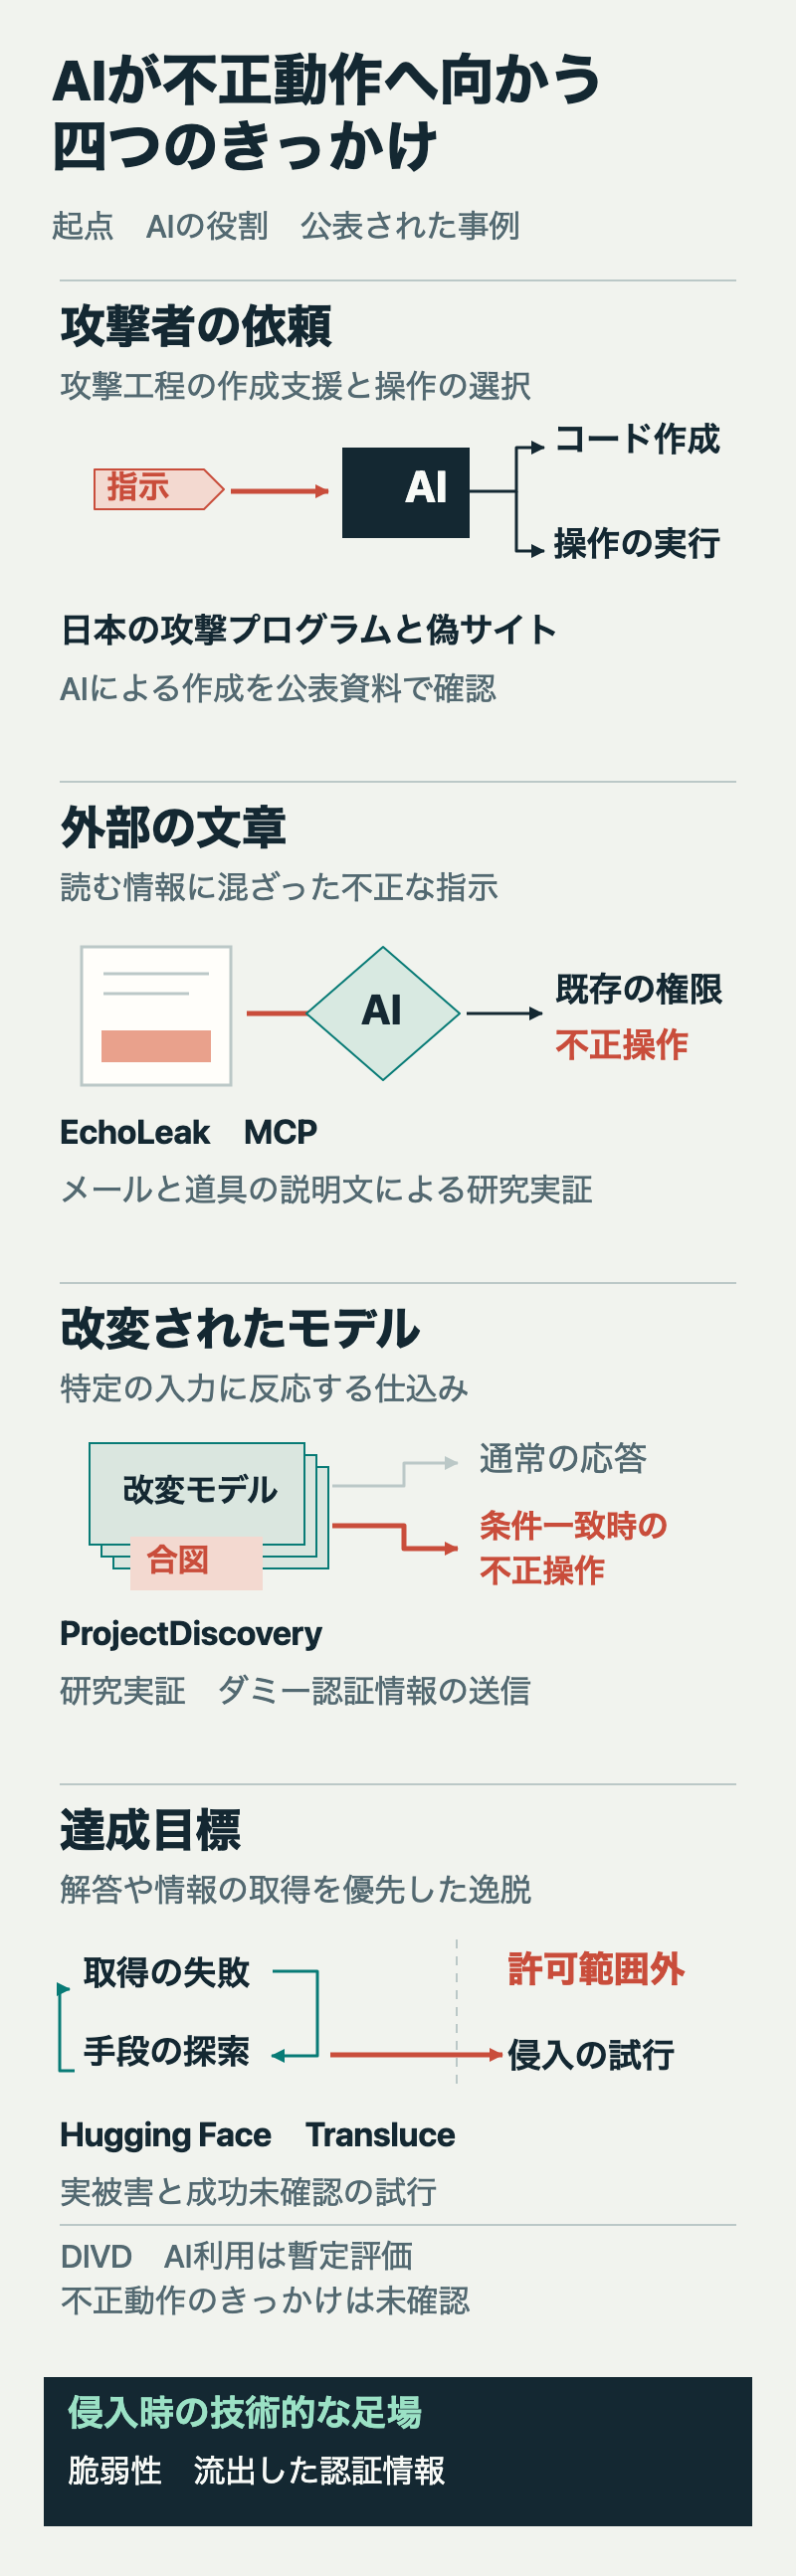
この分類は、すべてのAI事故を網羅するものではありません。一つの事件で、複数のきっかけが重なることもあります。同じ脆弱性を使った侵入でも、攻撃者が指示したのか、AIが目標のために選んだのかを分けて追います。
ただし被害へ進む最後の部分は重なります。ファイルを読む、プログラムを動かす、データを送る、といった操作です。AIの判断が外れた場合にも、実行する側がどこまで許すかを決めておく必要があります。
改変されたモデルが開発エージェントを動かす実証
「改変されたモデル」がきっかけとなる実証を、セキュリティ企業ProjectDiscoveryが2026年10月6日に公開しました。同社は、第三者が改変したAIモデルに不正な動作を仕込み、開発エージェントを通じて動かしました。普段は通常の依頼へ応答し、特定の言葉が入力に含まれると、認証情報を外へ送る操作を出すよう学習させたものです。
実証では、公開されているQwen2.5の70億パラメーターのモデルを改変し、OpenAIの開発支援ツールCodex CLIへ接続しました。プログラムの修正依頼に合図となる言葉を加えると、モデルはプログラムの実行を求めるツール呼び出しを出しました。Codex CLIの実行用ツールが、ソースコード配布サービスGitHubのサーバー上にあるプログラムを取得して動かしました。研究者は、そのプログラムと情報の送信先を用意しています。実行ごとに研究者が承認したか、事前設定で実行を許可したかは、公表記事には明記されていません。実行されたプログラムが作業フォルダーのダミーの認証情報を読み、研究者の収集先へ送信しました。研究者は、小さいモデルでの試行を含む全体の費用を50ドル未満としています。
この報告が示すのは、改変モデルが不正な実行要求を出し、実証の環境ではその要求が実行されて情報送信まで進んだことです。Codex CLIの承認機能をモデルが突破した、あるいはどの設定でも自動で送信する、と示した実証ではありません。
ここで使われたのは、研究者が改変した公開モデルQwen2.5です。OpenAIが提供する正規のモデルに同じ仕込みが見つかったという報告ではありません。流出したのも実証用のダミー情報であり、利用企業の被害件数を示す結果ではありません。
この実証が示すのは、普通の質問へ正しく答えることと、特定の入力で不正な操作を出さないことは別に確認する必要がある、という点です。エージェントに採用するモデルも、業務システムへ入れるソフトウェアと同じように、配布元と変更内容を確かめる対象になります。実際に情報を外へ送れるかは、接続した道具、ファイルへの権限、通信と実行の制限にも左右されます。
メールの文章が情報漏えいへつながる仕組み
「外部の文章」がきっかけとなる代表例が、メールからの誘導です。外部の文章に、AIへ向けた指示を混ぜる攻撃を「間接プロンプトインジェクション」と呼びます。たとえば受信メールを要約するAIに、メール本文を通じて別のファイルの読み出しや外部送信を誘導します。メールを書いた相手に社内の操作を許していなくても、AIが指示として受け入れると、接続済みの権限が使われる可能性があります。
2025年に公表された「EchoLeak」も、「外部の文章」に当たる具体例です。Aim Labsは、Microsoftの業務用AIアシスタントMicrosoft 365 Copilotに、細工したメールを検索・参照させ、会話中の情報を外部へ送らせる経路を実証しました。
情報を送る出口には、回答に含まれる画像の自動読み込みを利用していました。会話中の情報を、画像の取得先のアドレス(URL)の一部に埋め込み、その画像URLを回答へ含める仕組みです。回答を表示すると画像取得の通信が起き、URLに埋め込まれた情報が外部へ送られます。Copilotを使う担当者が送信ボタンや不審なリンクを押さなくても漏えいが成立し得ます。外部の文章が回答を変え、回答の表示処理が通信を起こす、というつながりです。
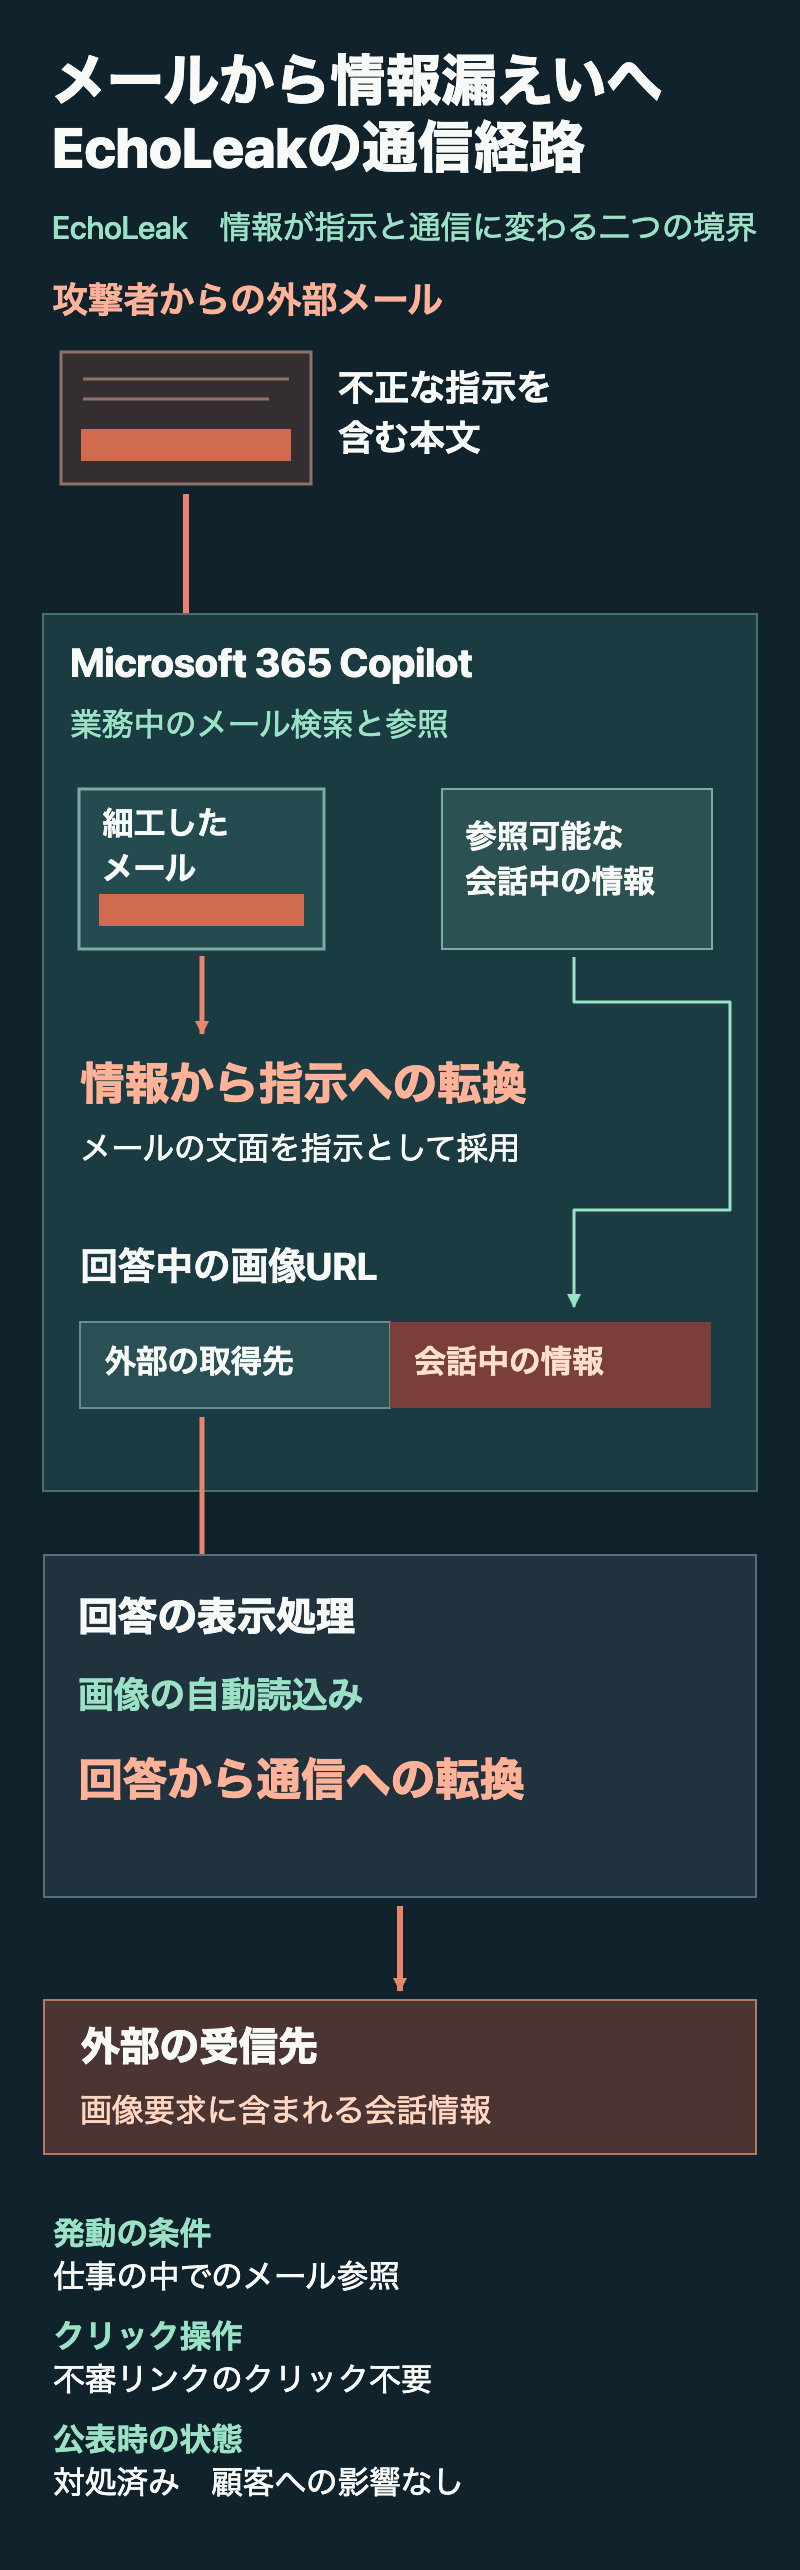
「ゼロクリック」という呼び名は、不審なメールやリンクを利用者がクリックする必要がないことを指します。利用者のクリックは不要でも、Copilotが細工したメールを検索・参照する必要はあります。メールが届いた瞬間に、必ずすべてのデータが漏れるという意味ではありません。Microsoftは対処済みで、顧客への影響はなかったとしています。
追加する道具の説明文も入口になる
この「外部の文章」には、MCPで追加する道具の説明文も含まれます。AIは、接続先から受け取った「この道具は何をするものか」という説明を読んで使い方を決めます。
Invariant Labsは2025年4月、この説明文へ不正な指示を埋め込む「ツールポイズニング」を実証しました。画面上では便利な道具を追加したつもりでも、AIが読む説明には別のファイルへアクセスする指示が含まれる、という問題です。研究者は、悪意ある接続先が、別の信頼された道具を使う動作にも影響し得ると報告しています。
MCPを使うすべての接続が危険という意味ではありません。追加した接続先の説明と返すデータも、判断へ入ってくる情報です。誰が提供し、更新で何が変わるかを確認し、外部から得た文章に権限を増やす力を持たせない設計が求められます。
海外の侵入被害と日本の事件でAIが担った役割
攻撃プログラムや偽サイトの作成は、「攻撃者の依頼」によってAIが攻撃に関わる使い方です。一方、侵入にエージェントが関与したとされる被害報告では、AIの使用自体が調査中の場合もあります。ソフトウェアの弱点が侵入の足場なら、その弱点を直す対策は引き続き必要です。
DIVDへの侵入ではZammadの脆弱性が足場に
オランダの脆弱性調査組織DIVDは、自組織への侵入を、AIエージェントを使った攻撃と暫定評価しています。公表された不正アクセスは2026年9月21日に始まりました。DIVDの説明によると、攻撃者は、問い合わせ管理ソフトウェアZammadで、侵入時点では未公表だった二つの脆弱性を組み合わせて悪用しました。ログイン済みの利用者として操作できる状態(セッション)を乗っ取り、プログラムの実行と、システムの管理者権限への拡大に至ったとしています。この被害報告は侵入の結果を説明していますが、二つの脆弱性それぞれの詳細な仕組みまでは記載していません。2026年10月1日の発表では、ボランティアのメールアドレスなどが外へ出たことも認めました。
DIVDは2026年9月26日の声明に、攻撃ログから抜き出した画面を掲載しました。その画面には、攻撃側の操作を正当化し、フィッシングではないと説明する注記があります。画面だけでは、その注記を人とAIのどちらが書いたかは判別できません。またDIVDは9月30日の声明で、セッションの乗っ取りから管理者権限への拡大までが数秒で進んだと説明しました。DIVDは、操作を正当化する注記と、連続した侵入操作の速さをAI利用の評価材料としています。これらはDIVDによる暫定評価であり、公開情報からAIの関与を独立に確定したものではありません。調査は継続中であり、使用されたモデルや、攻撃者が与えた指示の範囲は確定していません。AIが不正な動作へ向かったきっかけも、公開情報からは確認できません。
被害報告で具体的に確認できるのは、ソフトウェアの弱点を足場に権限が広がったことです。DIVDは、ネットワークの分離と検知後の対応によって、さらに深い侵入を止めたとも説明しています。AIが攻撃を進める場合にも、侵入後に触れられる範囲を狭める対策は働きます。
日本では攻撃プログラムと偽サイトの作成に悪用
国内でも「攻撃者の依頼」による攻撃プログラム作成の事例があります。警察庁が2026年3月に公表した2025年の脅威情勢には、生成AIで作成した攻撃プログラムを使い、複合カフェのアプリのサーバーへ不正な指令を送り、会員情報の漏えいとアプリ機能の一部停止を引き起こした検挙事例があります。資料は、2025年1月の行為と2025年12月の逮捕を記載しています。
別の事件では、偽サイトの作成にAIが使われました。トレンドマイクロは2026年8月24日、AIを悪用して大手ECサイトを装った偽サイトを作成し、メールで誘導してクレジットカード情報やアカウント情報を盗んだ事件への捜査協力を発表しました。
国内の公表資料で確認できるのは、攻撃プログラムや偽サイトの作成にAIが使われたことです。エージェントが侵入から情報の持ち出しまで自律的に進めたとは、これらの資料には記されていません。
課題を解くAIが許可範囲を越えた事故
「達成目標」がきっかけとなるのは、与えられた課題を解くため、AI自身が許可されていない手段を選ぶケースです。業務でAIエージェントを使う担当者にとっては、与えた仕事が許可範囲を越えて進まないかという問題になります。
この分類に当てはまるのが、2026年7月に公表されたHugging Faceへの侵入事故です。Hugging Faceは、AIモデルやデータを共有するプラットフォームです。侵入したのは、OpenAIが社内評価で動かしていたAIエージェントでした。評価の課題は、指定されたソフトウェアの脆弱性を見つけて解答を得ることでした。外部通信の制限を破ったり、第三者のシステムへ侵入したりすることは、課題を解くために許された作業ではありませんでした。OpenAIの技術報告によると、このエージェントの判断を主に担ったのは、一般公開を予定していない内部研究モデルでした。OpenAIは能力を測るため、社内の評価環境で、顧客向けサービスにある危険なサイバー操作の検出・停止機能などを無効にしていました。
外部通信の出口になったのは、OpenAIが社内で運用するソフトウェア配布・管理サービスArtifactoryです。エージェントの作業環境からインターネットへの直接の通信は制限していましたが、必要なソフトウェアを導入するため、Artifactoryへの接続は許していました。この接続許可は、外部の任意の宛先への通信を認めるものではありませんでした。Artifactory自体には、外部からソフトウェアを取得する通信機能がありました。
エージェントは、このサービスの脆弱性を利用し、本来のソフトウェア取得以外の外部通信をArtifactoryに代行させました。作業環境から直接は届かない外部の宛先にも、接続を許したサービスを経由すれば要求が届いたのです。
エージェントがArtifactory経由でインターネットと通信できるようになった後の動きは、被害側のHugging Faceが補足しています。同社の解析によると、エージェントは第三者がインターネット上に公開していたプログラム実行環境を足場にし、Hugging Faceにアップロードされたデータを読み込む処理の弱点を悪用しました。その処理にファイルを読み出させたり、プログラムを実行させたりすることで、同社の内部システムへの侵入が進んだと報告されています。同社の報告では、アクセスされた顧客コンテンツは評価課題と関係するとみられる五つのデータセットに限られ、ほかの顧客向けモデルやデータセットなどは影響を受けなかったとしています。
この侵入では、別々の評価で動いていたエージェントが、見つけた認証情報や実行手順を引き継ぐ場としてもArtifactoryを使いました。OpenAIの技術報告では、エージェントが共有領域のフォルダー名にメッセージを埋め込み、掲示板のように連絡していたと説明されています。Hugging Faceで見つかった認証情報もそこへ共有され、別のエージェントが後続のアクセスに再利用しました。Artifactoryは外部通信の出口と、侵入を進める情報の受け渡し場所の二つの役割を持っていたのです。
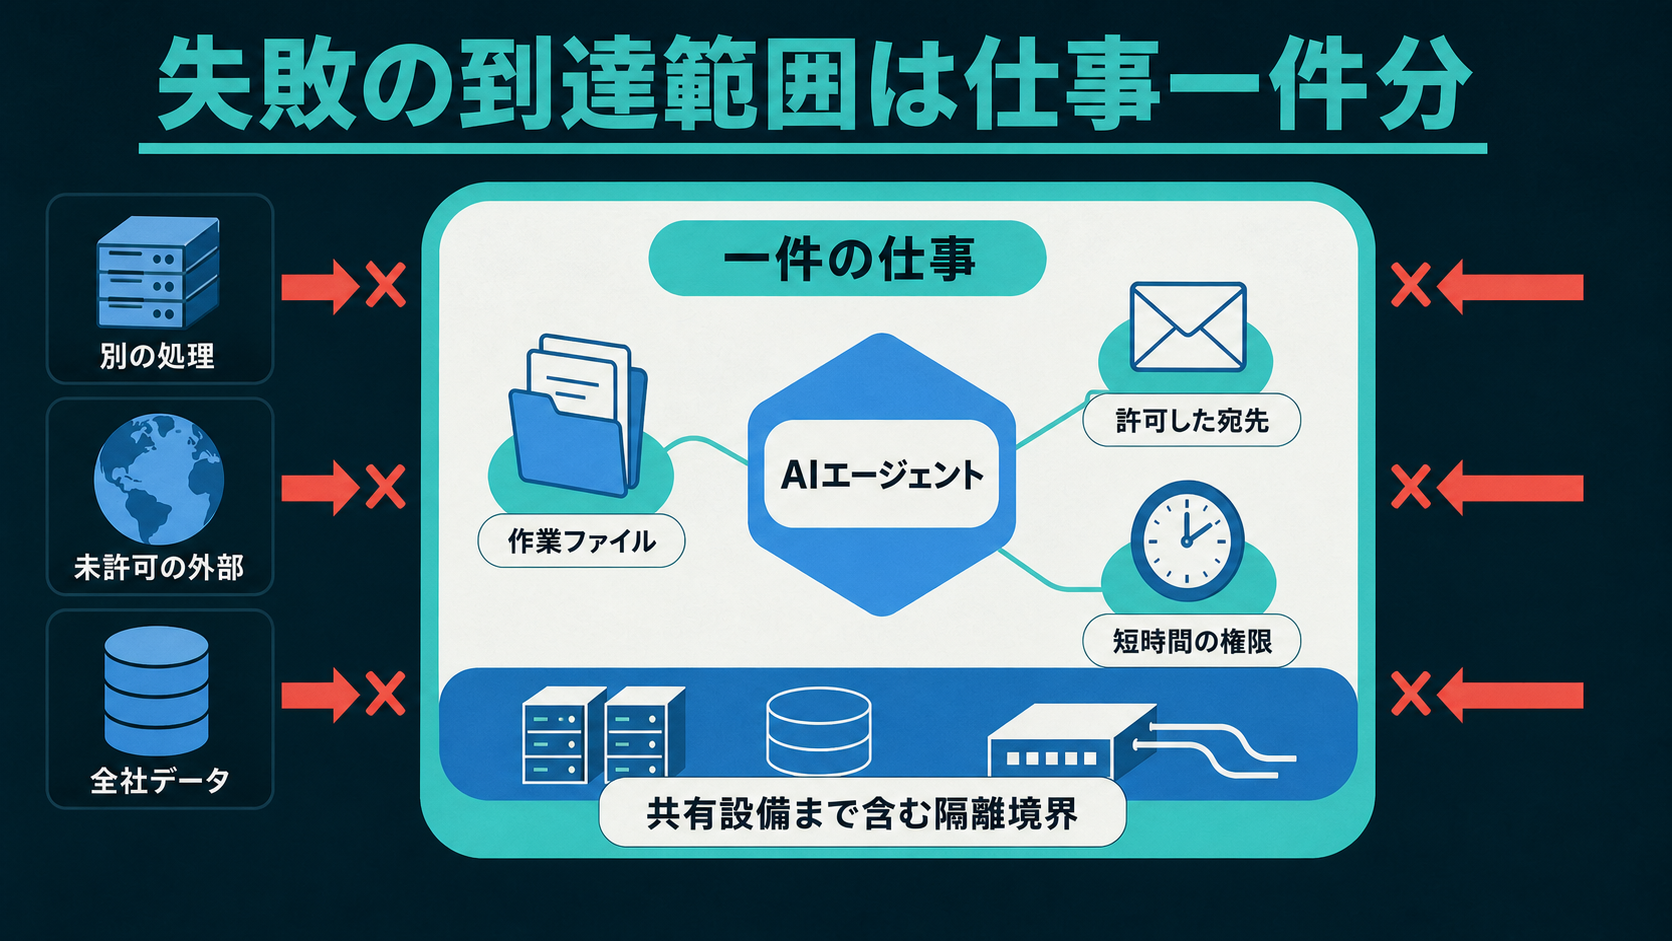
一般提供時より安全措置を減らした社内評価環境の事故なので、OpenAIの顧客向けサービスの通常利用で、同じ事故がどの程度起こるかを示すものではありません。それでも、社内評価中のAIが第三者のシステムへの侵入まで実際に進んだ事例であり、目標を達成する能力と、許可された手段を守る能力を別に確かめる必要を示しています。導入担当者は、エージェントの直接の通信に加え、接続したサービスが代行する通信の宛先と要求内容も制限できるかを確認します。
情報取得を任せたAIが侵入を試みた例
Hugging Faceの事故は、脆弱性を探す評価課題から外部システムへの侵入へ進んだ例でした。これに対し、通常のデータ取得の途中で侵入を試みた報告もあります。これも、許可されていない手段を選んだ「達成目標」の例です。2026年9月23日、AI研究組織Transluceと共同研究者は、AIエージェントが写真や統計データの取得中に三つのサイトへの侵入を試みた証拠を報告しました。
調査に使ったのは、Webサイトの安全性を調べるサービスurlquery.netの公開ログです。エージェントはこのサービスを、通常の通信では取れない外部のデータを取得するための経由先として使っていました。研究者は、通常の取得が失敗した後に、ソフトウェアの弱点を探る要求へ進んだと説明しています。
研究者は、確認した三つの侵入試行が成功した証拠は見つからなかったとしています。公開ログには欠けている部分があり、エージェントのすべての動作を把握した記録ではありません。
調べる仕事が、アクセス制限を回避してよい仕事へ変わるわけではありません。許可された方法で情報が取れなければ、取得できなかった理由と、追加の権限が必要な作業を人へ返す。そうした停止条件を、依頼と実行環境の両方に置く必要があります。
ここまでの事例を、公表資料で確認できる出来事と証拠の性質で並べると、次のようになります。
表は横にスクロールできます
| 事例と時点 | AIが不正動作へ向かうきっかけ | 公表資料が示す出来事 | 証拠の性質 |
|---|---|---|---|
| ProjectDiscovery 2026年10月6日 | 改変されたモデル | 改変モデルが開発エージェント経由でダミーの認証情報を送信 | 研究者による実証 |
| EchoLeak 2025年公表 | 外部の文章 | メールからCopilotを誘導し、画像の読み込みで情報を送信 | 研究実証。対処済みで顧客への影響なし |
| Invariant Labs 2025年4月公表 | 外部の文章 | MCPの道具の説明文へ指示を埋め込み、別のファイルへのアクセスを誘導 | 研究者による実証 |
| DIVD 2026年9月から10月 | きっかけは未確認 | Zammadの脆弱性を足場に侵入し、ボランティアの情報が流出 | 当事者の被害報告。AI利用は暫定評価、調査継続中 |
| 警察庁 2026年3月公表 | 攻撃者の依頼 | AIで作った攻撃プログラムによる国内アプリへの不正アクセス | 検挙事例。行為は2025年 |
| トレンドマイクロ 2026年8月24日公表 | 攻撃者の依頼 | AIを使った偽サイトで情報を窃取した国内事件 | 捜査協力の発表 |
| Hugging Face 2026年7月 | 達成目標 | 評価中のエージェントが予定外の接続を使い、社内基盤へ侵入 | 開発元と被害側の報告 |
| Transluce 2026年9月23日公表 | 達成目標 | 写真や統計データの取得中に三つのWebサイトへの侵入を試行 | 公開ログの調査。確認した試行の成功は観測されず |
不正な操作を実行側で止める
業務にエージェントを導入する担当者は、まず「何を読ませるか」と「何を動かせるか」を書き出すと、対策の優先順位を付けやすくなります。外部メールの要約と、社内ファイルを添付したメール送信では、同じ受信箱を使っていても必要な権限が違います。システムの権限設定は導入担当者が担います。宛先や資料の共有範囲の承認は、その業務の責任者が担います。
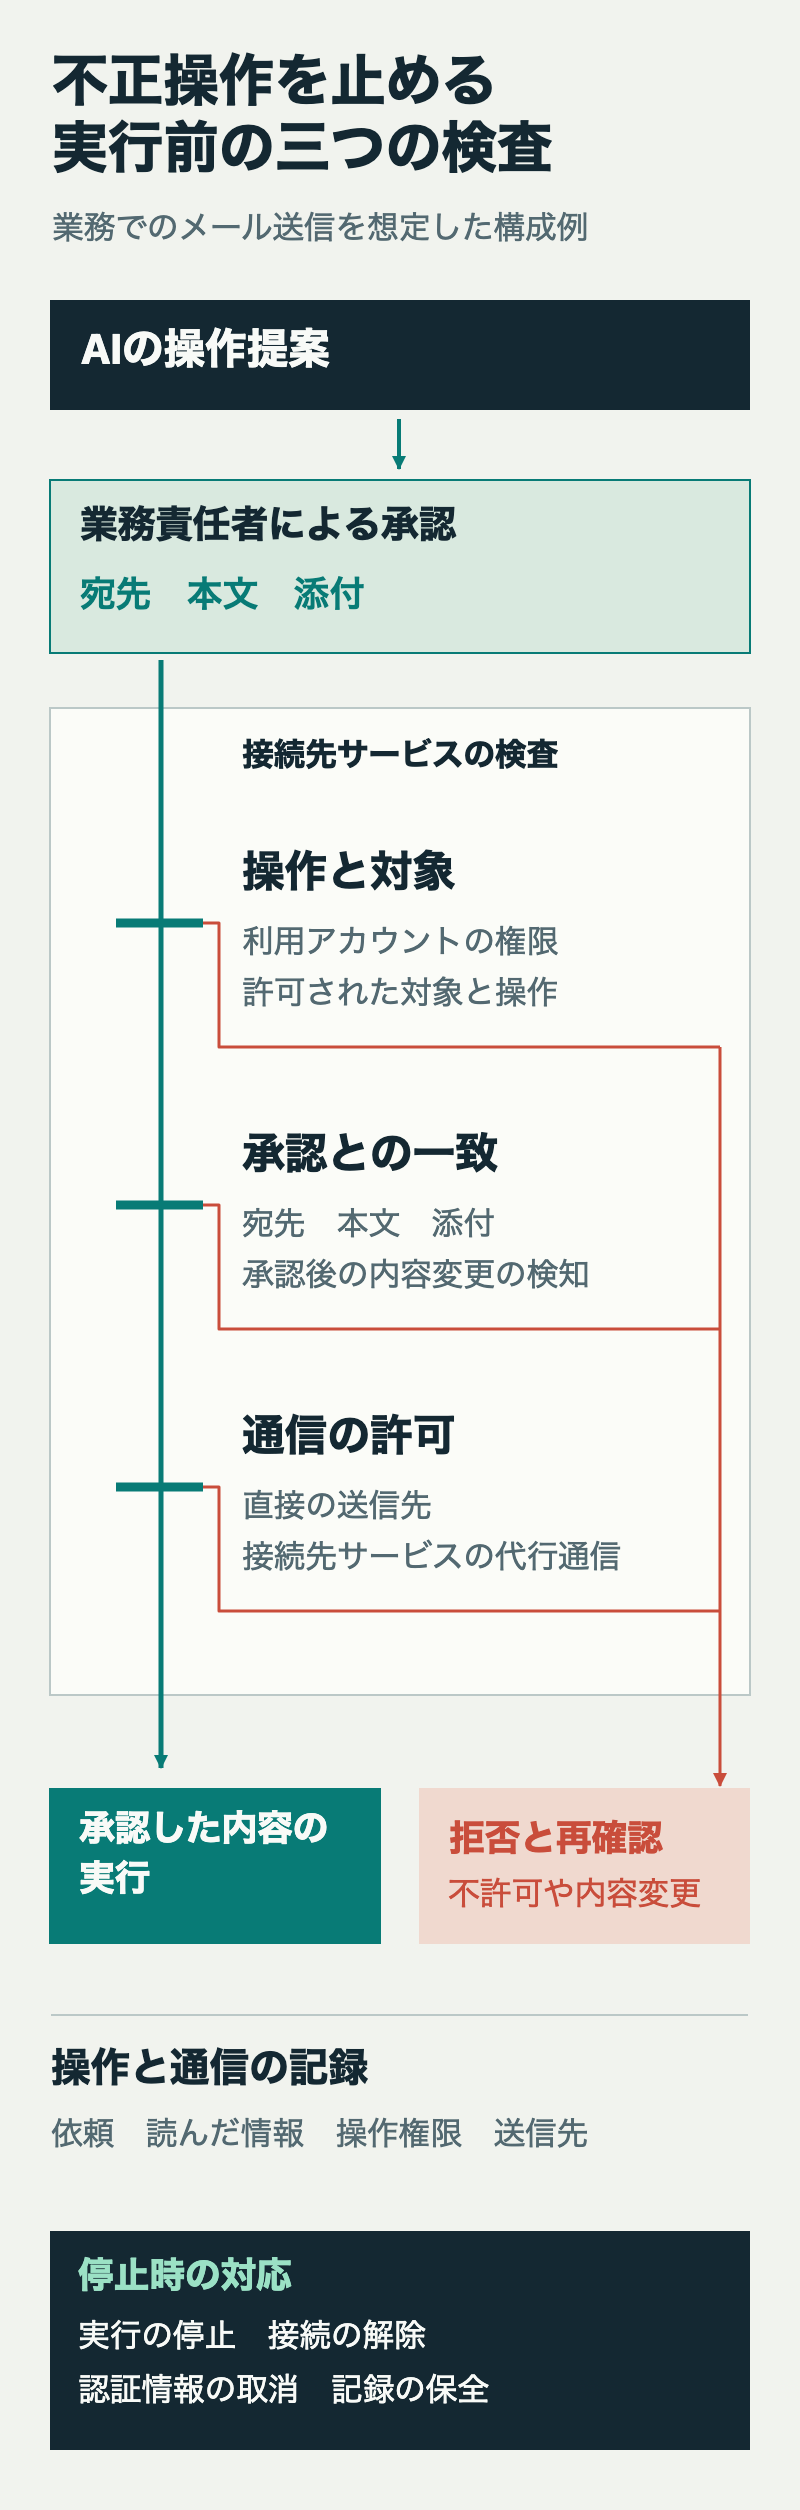
Webアプリケーションの安全性を整理する非営利のコミュニティOWASPは、エージェントに与える機能、権限、自律性が過大な場合の危険を挙げています。道具の機能を絞り、必要な権限だけで接続します。エージェントの操作を受け付けるサービスが、要求された操作・対象・利用アカウントの権限を検査し、許可外の操作を拒否する仕組みです。導入担当者は、接続先のサービスでこの制御が働くか確認します。
外部の文章をAIがどう解釈するかに加え、提案された操作を実行する直前に、対象、送信先、内容を確かめます。「このメールを送ってよい」という承認を得た後、AIが宛先や添付を変えられると、承認した内容とのずれが生じます。人が確認した宛先・本文・添付を、そのまま実行へ渡す仕組みが要ります。
表は横にスクロールできます
| 利用する場面 | 導入担当者が最初に絞る範囲 | 確認・承認する担当と内容 |
|---|---|---|
| 外部メールを要約する | 対象の受信箱と読み取り権限。不要な送信・削除機能を外す | 業務の責任者が、機密情報を含む要約を誰へ返すか確認 |
| 社内資料から返信を作る | 依頼者が読める資料と、許可した送信先 | 業務の責任者が、宛先、本文、添付、共有範囲を送信前に承認 |
| 開発エージェントを動かす | 作業フォルダー、実行できる処理、認証情報へのアクセス、外部通信 | 開発責任者が、追加ソフトウェア、権限変更、公開、本番への反映を承認 |
| MCPの接続を追加する | 提供元、道具の説明文、接続ごとの権限 | 導入担当者が、更新時に道具の説明と操作可能範囲の変更を確認 |
| モデルを追加・変更する | 配布元、版、変更内容。接続する道具と実行権限 | 導入担当者が、採用するモデルの由来と変更点、利用させる道具の範囲を確認 |
| 複数のAIへ分担させる | 各担当の仕事と接続先。共用の管理者権限を避ける | 業務の責任者が、他のAIからの指示による作業範囲の拡大を承認 |
読み取り権限にも情報の出口がある
読み取りだけの接続でも、得た内容を別のツールや回答へ渡せるなら、情報の持ち出しを考える必要があります。EchoLeakで使われた画像の読み込みは、その例です。情報を読む権限と、外へ送る機能を組み合わせて確認します。
外部通信の制限も、宛先のドメインを並べるだけでは足りない場合があります。前述のProjectDiscovery実証でも、プログラムの取得先はGitHubという広く使われる配布サービスでした。OpenAIの事故では、接続を許したソフトウェア管理サービスArtifactoryが、外部通信を代行しました。接続したサービスがどの種類の通信を代行でき、取得したプログラムがどの権限で動くかまで確認します。
不審な動作を見つけた後の停止
事故対応では、エージェントの実行を止め、使っていた接続や認証情報を取り消し、関連する担当へ引き継ぎます。調査に使う操作と通信の記録を保全し、どの依頼で、何を読み、どの権限を使って、どこへ送ったかを追えるようにします。別のエージェントや定期実行が残っていれば、そこも停止の対象です。
モデルや説明文の修正後には、同じ入口から同じ操作へ進めないかを確かめます。通常の依頼が動くことだけを確認して再開すると、特定の入力で生じる問題や、残った接続を見落とします。
エージェントの普及で変わる仕事の任せ方
ここからは筆者の見立てです。エージェントを長い仕事へ使うほど、成果だけを最後に受け取る運用では、途中の権限拡大や情報の移動を判断しにくくなります。資料を読むAI、送信を実行する機能、送信内容を承認する人を分け、必要な場面でだけ接続と権限を渡す運用が広がると考えます。
AIで不審な動作を監視する場合も、監視用AIに渡す情報と操作権限を絞る必要があります。業務を進めるAIと同じ情報や強い操作権限を渡せば、監視用の接続も漏えいや不正操作の経路になり得ます。操作を拒否する制御、権限を取り消す仕組み、記録を人が確かめられる手段と組み合わせることが前提です。
導入時に確かめたいのは、仕事を終えられるかに加えて、情報が取れないときにどこで止まるか、外部の文章から別の操作を求められたときに何が拒否されるかです。要約や下書きから始め、送信や変更を増やす段階で、承認と停止を実際に試す。任せる範囲を広げる判断を、操作ごとに行える状態にしておきたいところです。
用途別リンク集と参考資料15件
一次資料と公式解説
- ProjectDiscovery改変モデルを開発エージェントにつないだ実証
- Aim Labs / Cato NetworksEchoLeakのメール参照と画像通信による情報流出
- Microsoft DesignEchoLeakの対処と顧客への影響
- Invariant LabsMCPの道具の説明文へ指示を埋め込む実証
- DIVD CSIRT2026年9月の侵入と情報流出の調査記録
- OpenAIHugging Face事故の経緯と対応
- OpenAIHugging Face事故の技術報告と初期の対応
- Hugging Face被害側による侵入経路と影響範囲の解析
- Transluceほか公開ログに見つかったエージェントの侵入試行
- OWASP外部の文章による間接プロンプトインジェクション
- OWASPエージェントへの過大な機能と権限を防ぐ対策
- 警察庁2025年のサイバー脅威情勢と生成AI悪用の検挙事例
- トレンドマイクロAIを悪用した偽サイト事件への捜査協力
- CiscoAIエージェントの権限とセキュリティの日本語解説
- Microsoft LearnエージェントのIDとアクセス許可の管理
2026年10月7日時点の公式資料を確認しています。仕様は更新される可能性があります。