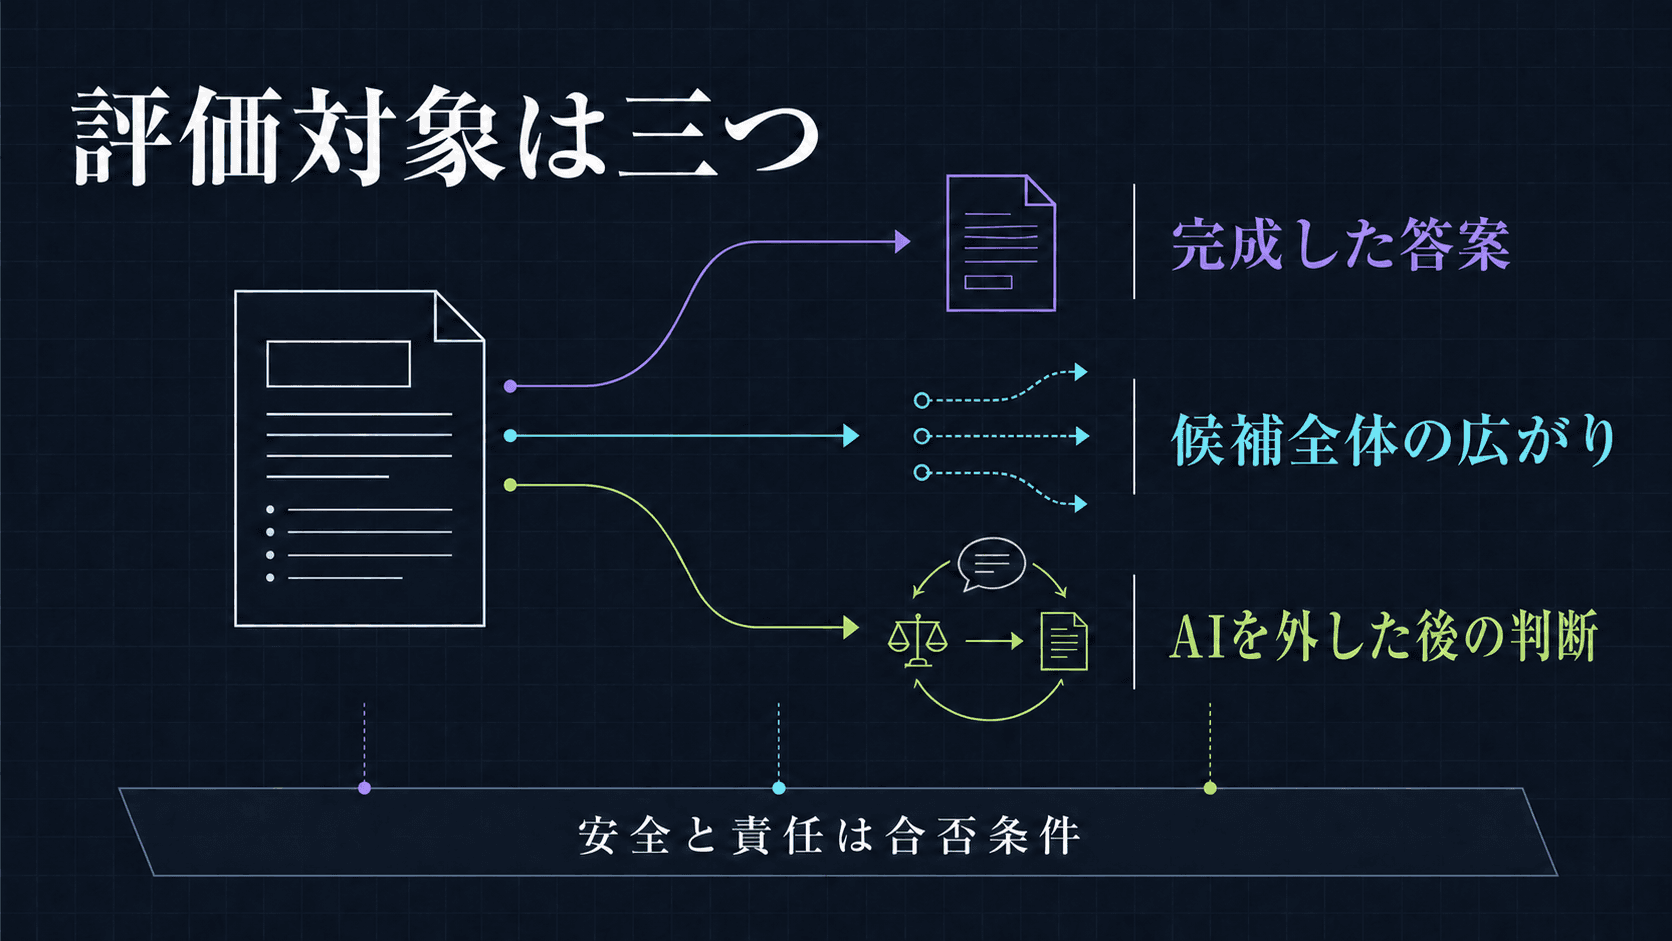
ChatGPTを使った答案は、完成度、案の多様さ、本人がAIなしで考え直せる力を分けて評価します。1,053人の学生実験では、ChatGPTは答案の評価を上げた一方、施策の仕組みや失敗条件を書く訓練の効果は同じ点数へ表れませんでした。
ChatGPTを使える学生と考え方を教わった学生を比べた
ChatGPTを使うと、学生の答案は高く採点されるのか。点が上がったとき、なぜ施策が効くのか、どんな結果なら失敗と判断するのかまで説明できるようになるのか。ヨーロッパの大学で行われた実験は、ChatGPTを使える条件と、考え方を教わる条件を分けて比べました。1
結果は二つに分かれます。ChatGPTは答案の点を上げた一方、考え方の訓練で増えたのは、施策が効く仕組みや失敗条件を書ける学生です。その変化は答案の平均点に反映されませんでした。この記事で考えるのは、AIを使う前と同じ採点表で、こうした違いを測れるのかという問題です。1
実験に参加したのは、入学したばかりの学生1,053人です。課題は、大学の公式グッズを14万4,000人以上の卒業生にもっと知ってもらい、買ってもらう方法を考えること。制限時間は45分、答案は180語まででした。1
学生一人ずつではなく、13クラスを単位として四つの条件へ割り当てました。何も足さない条件が249人、考え方の訓練だけが256人、ChatGPTだけが197人、両方を使う条件が351人です。ChatGPTを使う条件には、大学向けのChatGPTが用意されました。1
訓練は、架空の都市政策を題材にした12問の二択ゲームです。学生は、施策から結果までの筋道、施策が効く理由、考え直す条件、ほかにあり得る原因を順に学びました。各回答のあとには解説が表示されました。1
課題を始める前に、訓練を受けた学生へ表示されたのは「ゲームで学んだスキルを思い出してください」という一文だけです。グッズ販売に使えそうな案や、ChatGPTへ入れる指示は教えていません。1
論文は、結果を見る前に分析方法を登録しています。ただし著者にはOpenAIの所属者と、同社から報酬を受ける研究者が含まれ、一般向けの紹介記事もOpenAIが公開しました。別の研究チームによる追試ではありません。12
ChatGPTは答案の点を上げ訓練は考え方を変えた
学生の答案は、卒業生にグッズを「知ってもらえるか」と「実際に使ってもらえるか」の二点で採点されました。20人の修士学生が、誰がどの条件だったかを知らないまま、一つの答案を3人ずつ読み、各項目を1点から5点で評価しました。1
高い点を取るには、卒業生向けの販売施策を数多く、具体的に書く必要があります。論文の採点例では、LinkedInの卒業生グループ、同窓会、卒業25周年・50周年の限定商品、紹介制度を組み合わせた案が「知ってもらう」の5点です。「オンラインで買えるようにする」だけなら1点です。1
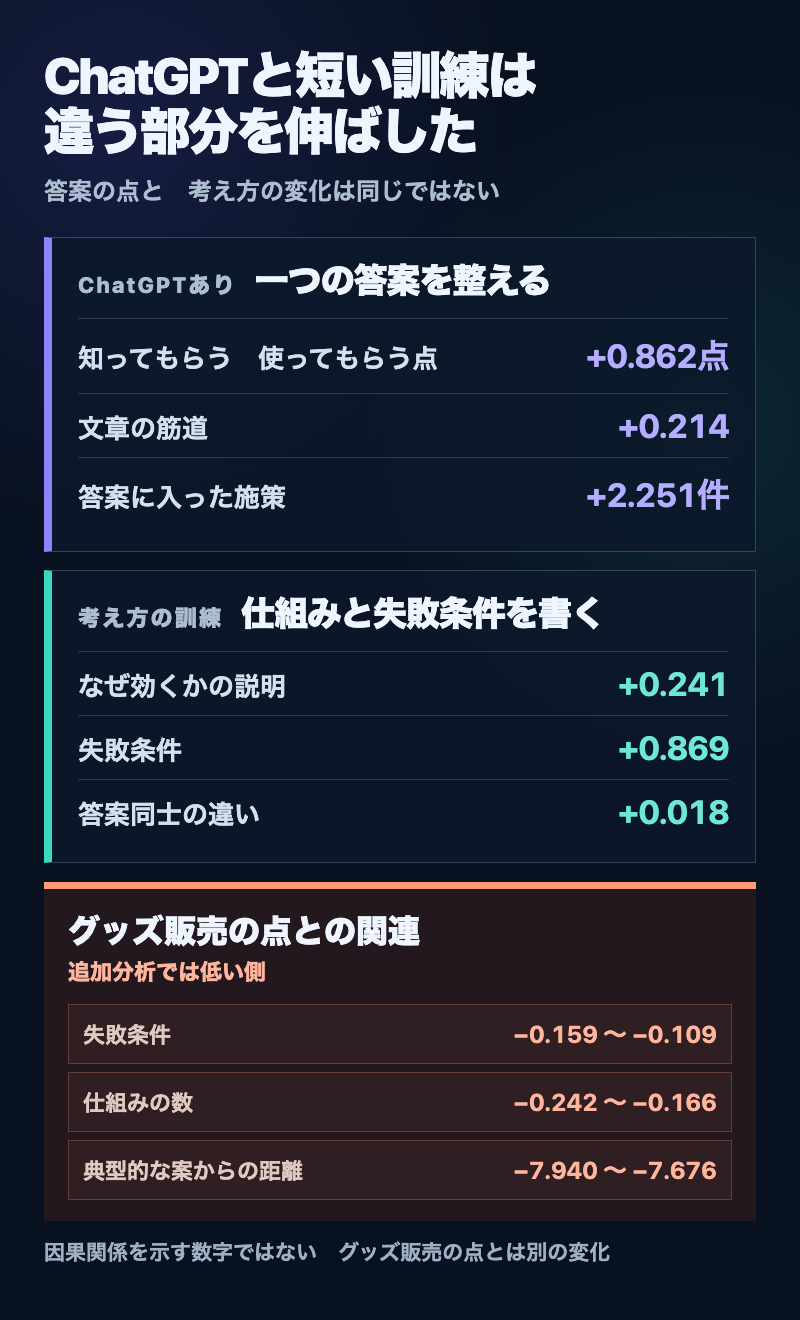
ChatGPTを使えた学生は、この採点で平均約0.86点高くなりました。5点満点の評価では大きな差です。文章の筋道も通り、一つの答案に盛り込む施策の数は平均約2.3件増えました。1
一方、考え方の訓練は別の部分を変えました。施策が効く仕組みを書く学生が増え、失敗条件を明記する学生も、ほかの学生とは違う案を出す学生も多くなっています。1
たとえば論文の採点例では、「高級商品で売上が増える」だけでは、成否を判断できません。「6か月で購入が30%増える。ただし、所得の低い卒業直後の層には効かない」と書けば、期限、観察する数字、失敗条件が分かります。訓練は、こうした書き方を増やしました。1
失敗条件まで書いた答案ほど点は伸びなかった
考え方の訓練を受けた学生は、仕組みや失敗条件を詳しく書けるようになりました。それでも、「知ってもらえるか」「使ってもらえるか」の平均点は上がりませんでした。1
研究者は、各答案に「筋道」「施策が効く仕組み」「失敗条件」「ほかの答案との違い」という別の点も付けています。その点と、グッズを知ってもらい使ってもらうための点を比べると、失敗条件を明記した答案ほど低い側に寄りました。仕組みを多く書いた答案や、典型的な回答から離れた答案も同じ傾向です。1
この関連だけでは、訓練が点数を下げたとも、採点者が独自な案を意図的に嫌ったとも証明できません。1
問題は、答案で良くなった部分と、グッズ販売の採点表が数えた部分がずれていたことです。販売経路、購入しやすくする工夫、割引、継続購入の仕組みを多く書くほど高く評価されます。施策の失敗条件や、クラス全体に似ていない案が残ったかは採点されません。1
一つの答案を完成品として評価するなら、この採点表には筋が通っています。しかし、学生が自分の案を疑えるようになったか、クラス全体に異なる仮説が残ったかを知りたいなら、同じ点数では測れません。
一人の文章が良くなっても全員の案は似ていく
グッズ販売の実験が採点したのは、一人ずつの答案です。AIを使った人の作品が良くなったとき、作品全体の違いがどうなるかまでは分かりません。この点を調べたのが、293人に短編小説を書いてもらい、600人が作品を評価した実験です。3
GPT-4が作った書き出しを五つ見た人の作品は、人だけで書いた作品より新しさが8.1%、面白さや役立ちやすさが9.0%高く評価されました。その一方で、AIを使った書き手の作品は互いに似ています。3
約450人の専門職が文章作成に取り組んだ別の実験でも、ChatGPTを使うと作業時間は約40%短くなり、品質は約18%上がりました。もともと低い評価だった人ほど大きく改善し、出来栄えの差が縮まっています。4
全員の仕事が速く、読みやすくなるのは明確な利点です。ただし、多数の企画書から違う発想を選びたい場面では、読みやすさだけを点数にすると候補の差が見えにくくなります。全員に奇抜さを求める必要はありません。候補全体に、違う顧客、違う売り方、違う失敗条件が残っているかを確かめる必要があります。
AIを外した課題で本人に残った力が見える
完成した答案と候補全体を分けても、学習や採用の評価にはまだ足りません。AIを外した次の課題で、本人が考え直せるかを確かめる必要があります。
トルコの高校で約1,000人が数学を学んだ実験では、練習問題で自由に質問できるGPTを使うと、成績が48%上がりました。答えではなく手掛かりを少しずつ出すGPTでは、練習問題の成績が127%向上しています。5
ところがAIを使えない試験では、自由に質問できるGPTを使った生徒が、最初からAIを使わなかった生徒より17%低い点でした。手掛かりを出すGPTはこの悪化を防ぎましたが、AIなしの試験で明確な上積みまでは示していません。5
本人に残った力を調べるために、長い対話履歴を提出させる必要はありません。条件を一つ変えた問題を出し、「どの前提が崩れたか」「最初に捨てる案はどれか」「新しい数字を見て何を変えるか」を5分で説明してもらえば、答案とは別の能力を観察できます。
AIへ任せる順番で結果は変わる
数学実験では、AIを答え役にするか、手掛かり役にするかで結果が分かれました。アイデアづくりでも、AIを使えば必ず案が似るわけではありません。
マーケティング文を書く実験でも、AIに最初の案を書かせる使い方と、人が出した案へAIが助言する使い方で結果が分かれます。助言役のAIは経験の浅い人を助けました。一方、AIに代筆させると、専門家が最初の案へ引っ張られ、成績が下がる場合も報告されています。8
二つの実験が示すのは、AIを使うかどうかだけでなく、どの段階から任せるかを分けて見る必要があるということです。最初の答えまでAIへ任せるのか、人が考えた後で助言を求めるのかによって、本人に残る判断の量が変わります。
AIは案を狭めることも広げることもある
一人の使い方だけでなく、大勢が同時にAIを使ったときの変化を調べた実験もあります。40か国以上、800人以上が参加した実験では、AIの案を多く見ても、一人ひとりの創造性は上がりませんでした。しかし参加者全員の案を比べると、互いの違いは大きくなり、珍しい案の割合も増えました。6
研究参加者を集めた実験だけでなく、実際の企業でもAIが案の作り方を変えるかを調べた研究があります。日用品メーカーP&Gの社員791人による実験では、AIを使った一人が、AIを使わない二人組と同じ水準の案を出しています。研究開発と営業の社員がAIを使うと、専門分野による案の差も縮まります。ただし最後にどの案を選ぶかでは、人の判断がなお役立ちました。7
別の共同執筆研究では、指示に忠実に答えるよう調整したAIを使うと、書き手同士の文章がより似ました。9 使うモデルの調整方法も、案の広がりを左右します。
AIへ最初から完成案を一つ求めると、よくある答えへ寄りやすくなります。人が先に仮説を出す、互いに離れた案を複数求める、反対意見だけを出させる、最後の選択は人が行う。使う順番を変えれば、AIは答案を整える道具にも、候補を広げる道具にもなります。
採点表を三枚に分ける
一人の答案、候補全体、AIを外した後の本人は、同じ方法では比べられません。AIを使える授業や社内公募では、見る対象ごとに採点用紙を分けます。
| 採点する対象 | 確かめること | 残す証拠 |
|---|---|---|
| 完成した答案 | 今すぐ使えるか | 正確さ、分かりやすさ、具体性、実行しやすさ |
| 候補全体 | 似ていない案が残ったか | 違う顧客、違う仕組み、捨てた案と理由 |
| 本人の判断 | AIなしでも考え直せるか | 失敗条件、新しい証拠を見た修正、短い口頭説明 |
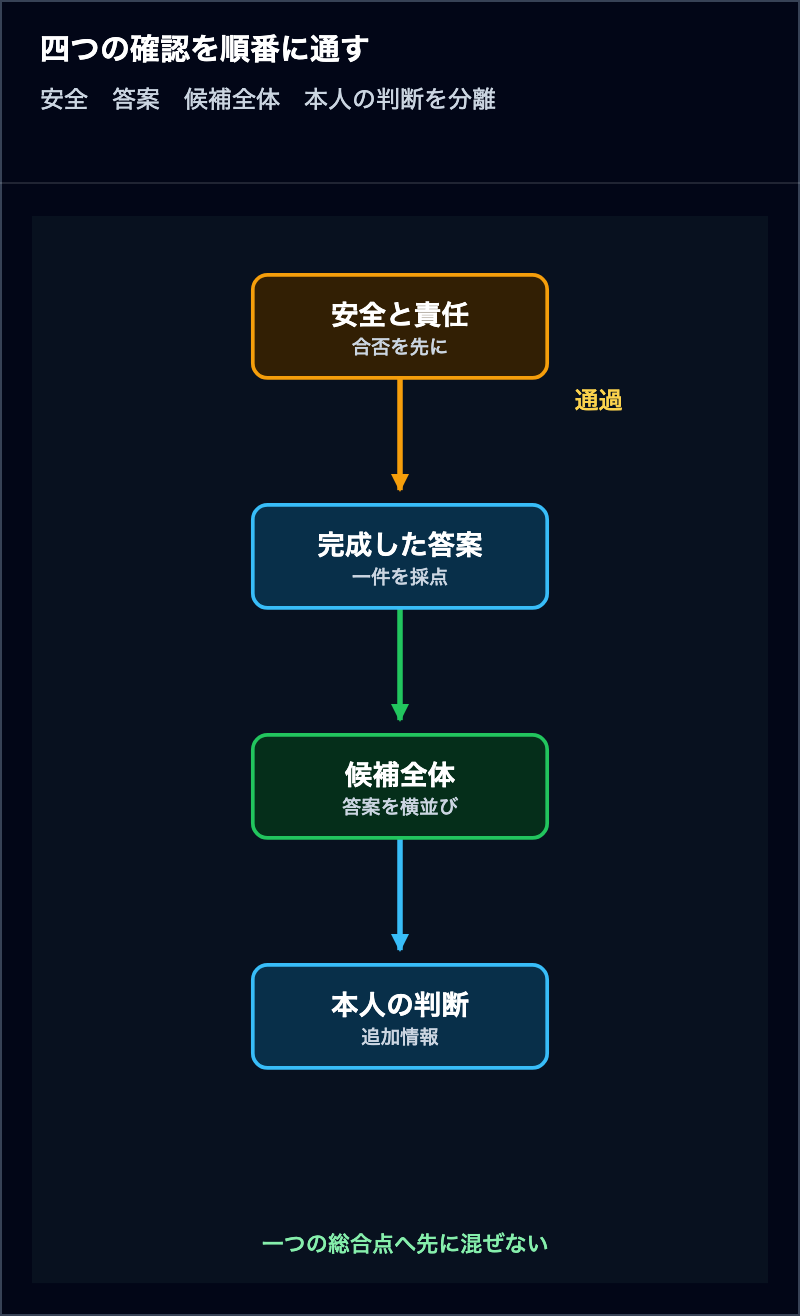
たとえば20件の社内公募なら、まず一件ずつ実行しやすさを採点します。次は20件を横に並べ、同じ顧客や売り方へ偏っていないかの確認です。最後に上位候補者全員へ同じ新情報を渡し、提案をどう直すかを短く説明してもらいます。
授業や研修では三枚目を重くし、採用や新規事業の公募では二枚目と三枚目も使います。正解を自動で照合できる計算や形式変換なら、一枚目だけで十分です。
文部科学省も、生成AIの出力をそのまま使ったレポートでは、本人の成果を評価できない場合があると説明しています。対策として挙げているのは、短い口頭確認や、学習中の作業を確かめる方法です。1011 国立情報学研究所も、従来と同じレポートだけで成績を決める難しさを指摘しています。12
知能圏編集部でも、小さな試行を行っています。800字の新規事業案を「分かりやすさ、具体性、実行しやすさ」で採点する架空の社内公募を作り、LunaとClaude Opusという二つのAIモデルへ、新しい採点表を一度ずつ作らせました。
両モデルが求めたのは、翌日に始める行動、別案、失敗条件、新しい情報を見た修正、安全上の足切りです。一方、失敗条件を「答案の質」と見るか「本人の判断」と見るかは一致しませんでした。
二つのモデルによる一回ずつの回答は、採点方法の正しさを証明しません。むしろ、AIに採点表を作らせても、何を測ったことにするかは人が決めなければならない、と分かります。
安全は点数にせず最初に合否を決める
三枚の採点用紙より先に、点数にしてはいけない確認があります。法令違反、個人情報の漏えい、返金できない広告出稿、責任者の不在です。一つでも重大な問題があれば、その案は高得点でも止めます。
安全を平均点に入れると、危険な案でも、文章のうまさや新しさの加点で合格できます。安全と責任は加点項目ではなく、採点を始める前の合否条件です。
したがって実務では、三枚の採点表を使う前に、安全と責任の合否だけを独立して確認します。
AIが広まるほど、整った文章は珍しくなくなります。代わりに価値が上がるのは、似ていない候補を残すこと、少ない費用と時間で失敗条件を確かめること、新しい証拠を見て自分の考えを変えることです。
何を点数にし、何を全体で比べ、何を次の課題で確かめるのか。採点表の作り方が、AIを使ったあとに人と組織へ残る力を決めます。
参照リンク12件
- Hemanth AsirvathamほかTraining novices to think, or giving them LLMs? Evidence from an RCT
- OpenAIWhat students gain from ChatGPT and critical thinking training
- Science AdvancesGenerative AI enhances individual creativity but reduces the collective diversity of novel content
- ScienceExperimental Evidence on the Productivity Effects of Generative Artificial Intelligence
- Proceedings of the National Academy of SciencesGenerative AI Can Harm Learning
- Creativity & CognitionHow AI Ideas Affect the Creativity, Diversity, and Evolution of Human Ideas
- Organization ScienceThe Cybernetic Teammate: A Field Experiment on Generative AI and Teamwork
- Management ScienceLarge Language Model in Creative Work: The Role of Collaboration Modality and User Expertise
- ICLRDoes Writing with Language Models Reduce Content Diversity?
- 文部科学省大学・高専における生成AIの教学面の取扱いについて
- 文部科学省初等中等教育段階における生成AIの利活用に関するガイドライン Ver.2.0
- 国立情報学研究所生成系AIが大学での成績評価に及ぼす影響
2026年8月28日時点の公式資料を確認しています。仕様は更新される可能性があります。