AIに仕事を任せるとき、別のAIを足す価値はどこにあるのでしょうか。GPT-6 AstraやClaude Fable 5.1の登場で、一つのモデルに任せられる範囲も、仕事を終えるまでの費用も変わっています。コード、記事、動画制作を例に、作成・レビュー・修正を誰が担うと効果があり、どこで余計な往復が増えるのかを図と表で整理します。2026年9月12日時点の公式情報と研究から考える、モデルの進化に合わせた分業の選び方です。
AIを増やす前に役割の違いを押さえる
AIが書いた記事を別のAIに読ませると、「説明が飛んでいる」という指摘が返ってきます。その指摘を受けて、誰が文章を直すのでしょうか。最初に書いたAI、レビューしたAI、さらに別のAI、人間の編集者。それぞれで必要な情報と修正の範囲が変わります。
複数のAIへ仕事を配り、進める順序や結果を管理する仕組みをオーケストレーションと呼びます。役割を考える出発点は、次の五つです。作成役が成果物を作り、レビュー役が問題候補を挙げ、採否を判断する担当が根拠を確かめます。その後、修正役が変更し、変更後の成果物を再検証します。一つのAIや人間が複数の役割を兼ねても構いません。

例えば、文章の読みにくさを見つける能力と、取材の意図を保って書き直す能力は同じではありません。レビューの指摘をそのまま修正命令として扱うと、誤指摘まで成果物へ取り込むおそれがあります。「問題があるか」と「どう直すか」を分けることで、軽量モデルを使える場所も見えてきます。
ここでいう高性能・軽量は、その仕事に対する能力と費用の相対的な呼び方です。高性能モデルは複雑な判断の候補、軽量モデルは低い費用や短い応答時間を期待する候補とします。製品全体の順位だけで、すべての担当を決めるものではありません。
AstraとFable 5.1で分業の前提が変わる
OpenAIのGPT-6 AstraとAnthropicのClaude Fable 5.1は、文章の応答に加え、道具を使って複数段階の仕事を進める最新世代のモデルです。コードやファイルを扱うCodex、Claude CodeといったAIエージェントでは、モデルの周囲に、道具の呼び出し、会話の保持、権限、再試行を管理するハーネスがあります。同じモデルでも、この実行の仕組みによって仕事の進み方が変わります。
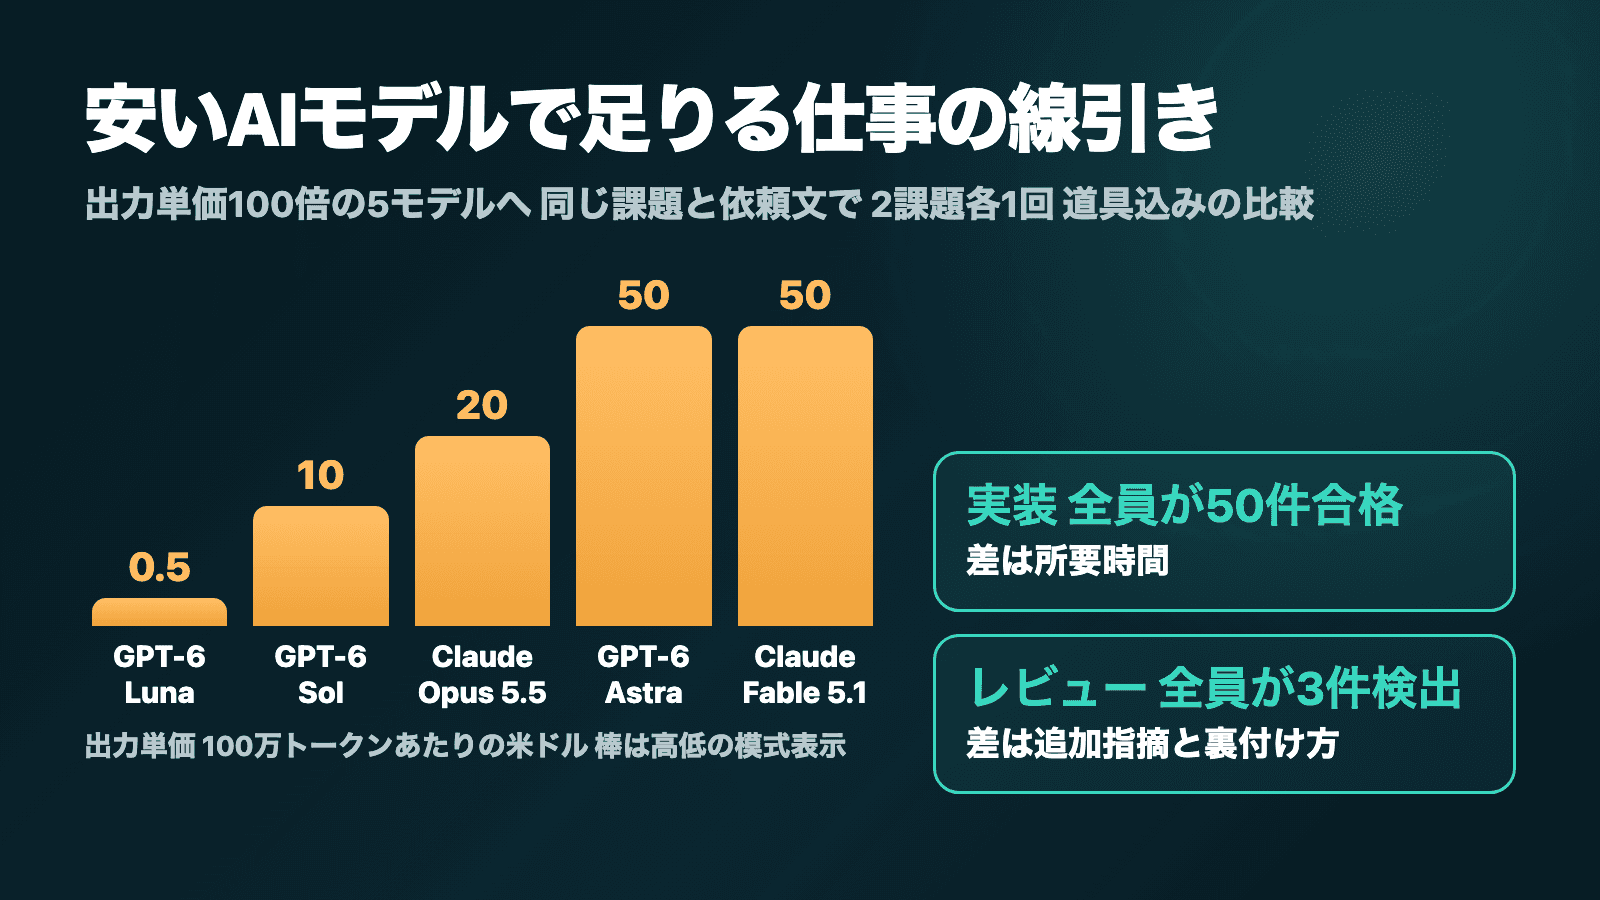
Astraの公式資料は、一部の評価で従来モデルより出力トークンを大きく減らし、トークン単価が高くても仕事あたりの推定API費用が下がったと説明しています。Fable 5.1も、公式評価では低・中程度の推論設定でFable 5と同等以上の結果を低い費用で得たと報告されています。高性能モデルを使う方が、一件を安く終えられる可能性があります。
トークンは、AIが文章やコードを処理する単位です。料金には入力と出力の量、モデルごとの単価、既に処理した入力を再利用するキャッシュなどが関わります。安い単価のモデルでも、読み直しと修正が増えれば合計は高くなります。
表は横にスクロールできます
| 最新モデルで変わった点 | 分担を選ぶ際の意味 |
|---|---|
| Astraは一部の評価で出力トークンが減少 | 軽量モデルを組み合わせる前に、高性能モデル単独の総費用を測り直す |
| Astraは会話途中で推論量を変更可能 | 同じモデルのまま、難しい段階だけ深く考えさせる選択肢 |
| Fable 5.1はキャッシュ読み取り料金を引き下げ | 長い資料を引き継ぐ継続作業と、別モデルへの引き継ぎを比較 |
| Fable 5.1も会話途中の推論量変更に対応 | 全工程を最大の推論量で走らせる必要があるか見直す |
会話途中の推論量変更はAPI側の機能です。Astraではキャッシュを保つ設定更新、Fable 5.1ではベータ機能として案内されています。利用するアプリや連携ツールで同じ制御ができるかは別途確認が必要です。
進化しても、既存の指示がそのまま最適とは限りません。Fable 5.1の公式資料には、Fable 5がまとめて呼んでいた道具を、一回ずつ呼ぶ場合があると記されています。独立した読み取りをまとめる指示で調整できるものの、モデルの更新だけで往復が必ず減るわけではありません。
五つの組み合わせを強みと弱みで選ぶ
サブエージェントは、主担当から仕事を任され、別の会話領域で動くエージェントです。同じモデルを使うことも、軽量モデルを指定することもあります。長い調査ログを子の側へ置き、親には必要な結果だけを返せるのが利点です。ただし、親の会話が短くなっても、子が消費したトークンは増えています。
次の表は、研究と実行の仕組みから考えた選択の目安です。特定モデルの組み合わせを実測した順位表ではありません。
表は横にスクロールできます
| 構成 | 強みと得られるもの | 弱みと効果が薄い場面 |
|---|---|---|
| 高性能モデルが作成と自己検証 | 引き継ぎが少なく、全体の意図を保ちやすい | 自分と同じ前提での見落とし。独立した確認が必要な仕事 |
| 高性能モデルが統括し、軽量モデルが分担 | 範囲の決まった調査・抽出を安く並列化できる可能性 | 子の仕事を親が全部やり直す場合。密接につながる作業の細切れ |
| 高性能モデルが作成、軽量モデルがレビュー、作成役が修正 | 読みにくさや規則違反の候補を低い費用で集められる可能性 | 難しい仕様の正しさを軽量モデルの合否だけで決める場合 |
| 軽量モデルが作成、高性能モデルがレビューと修正 | 定型部分の作成費用を抑え、難しい箇所へ能力を集中 | 修正がほぼ全面改稿になり、高性能モデルが最初から作るより高くなる場合 |
| 異なる系統の高性能モデルが独立レビュー | 異なる発想や探索経路から、見落としを補える可能性 | 共通の誤った資料を信じる場合。同じ調査の重複と指摘の統合費用 |
親を常に最高性能モデルにする必要もありません。分担と合格条件が固定されているなら、通常のプログラムが順番を制御し、必要な処理だけAIへ渡せます。一方、「調べた結果から次の仕事を決める」「矛盾する指摘を解く」まで親へ任せるなら、その判断に合う能力が要ります。
2026年4月の推論課題の研究では、合計の推論トークン予算を揃えると、単独エージェントが複数エージェントと同等以上の結果を出しました。対象は当時のQwen、DeepSeek、Gemini系モデルと複数段階の推論課題です。現在の全業務へ一般化はできませんが、AIを増やした条件にだけ多くの計算を与えない比較が必要だと分かります。
レビューが得意なモデルと修正が得意なモデルは違う
「この文章では前提が足りない」と気づけても、全体を書き直せるとは限りません。逆に、優れた文章を書けるモデルでも、依頼者が気にする読みづらさを自力では見逃す場合があります。レビューと修正を別の仕事として扱えば、高性能モデルの下に軽量モデルを置くだけではない組み合わせができます。
2026年5月公開の「Weak Critics Make Strong Learners」は、弱いモデルが批評し、強いモデルが元の回答を修正する構成を調べました。Phi-4系、Qwen3系を使った推論・指示追従の試験では改善が見られています。ただし、誤った批評は結果を悪くし得ます。新しいAstraとFableの性能や費用の比較ではなく、「批評役が最終解答まで作れる必要はない」という研究上の手がかりです。
誰に修正を任せるか
表は横にスクロールできます
| 修正する担当 | 向く修正 | 利点 | 注意する弱点 |
|---|---|---|---|
| 最初に作ったモデル | 構成や設計意図を保つ変更 | 調査の経緯を引き継げる | 自分の前提を疑いにくい。反証となる資料も渡す |
| 別の高性能モデル | 行き詰まった設計、全体の組み直し | 別の解法へ切り替えられる | 引き継ぎの費用と、元の要件を落とす危険 |
| 軽量モデル | 確認済みの表記修正、局所的な差し替え | 変更範囲を絞れば低い費用を狙える | 指摘の真偽まで一緒に任せると範囲が広がる |
| 人間 | 取材意図、演出の選択、事業上の仕様 | AIへ渡していない事情を含めて決められる | 作業時間が必要。修正後の確認を省かない |
記事なら、軽量モデルへ「この説明で意味が分からなくなる最初の箇所」を挙げてもらい、主担当が根拠を確認して書き直す方法があります。引用元の日付の誤りを修正するときは、軽量モデルにも渡せますが、その日付が変わると記事の結論まで変わるなら、主担当が影響を確認します。
コードでも同じです。レビュー役が失敗する入力と該当箇所を示し、実装役が再現してから修正します。レビュアー自身に修正まで任せれば往復は減りますが、誤指摘をそのまま実装する可能性もあります。変更後を別のテストや確認役で確かめる工程まで含めて選びます。
旧世代のGPT-5.5とOpus 4.7を使った2026年7月の交差レビュー研究でも、レビュー役が最終コードを書き換える条件で、正答率が下がる組み合わせがありました。これは最新モデルの順位を決める材料ではありません。指摘が妥当かと、修正後によくなったかを別々に測る理由になります。
軽量モデルには結果を確かめられる仕事を渡す
軽量モデルの使いどころは、「簡単そうか」だけでは判断しにくいものです。短い依頼でも、「この長い記事に事実誤認がないか」の確認には広い調査が必要になります。一方、「この公式ページから提供開始日と対象プランを抜き出す」なら、原文へ戻って確かめられます。

表は横にスクロールできます
| 分野 | 軽量モデルへ切り分ける例 | 高性能モデルや人に残す判断 | 確認に使うもの |
|---|---|---|---|
| コード | 関数の参照箇所、失敗ログの分類 | 原因の特定、設計変更の影響 | ファイル位置、再現入力、テスト |
| 記事 | 主張ごとの出典候補、用語の揺れ | 資料間の矛盾、記事全体の結論 | 一次資料の該当箇所、前後の文脈 |
| 動画 | 素材候補、字幕の不一致箇所 | 物語のつながり、演出、変更範囲 | 素材ID、時刻、映像、音声 |
「見つからなかった」という報告には、調べた範囲も必要です。不具合や誤記を一つ示すことに比べ、どこにもないと確認する仕事は広くなります。短い要約へ圧縮するときも、原文の場所と未確認の範囲は残します。
軽量モデルから高性能モデルへ切り替える条件は、依頼時に決めます。例えば、根拠を取得できない、複数の解釈が残る、同じ処理を繰り返して進まない場合です。モデル自身の「自信があります」という返答だけで判断せず、必要な証拠が揃ったかを見ます。
小型エージェントの活用を調べたSALEの研究では、短い実行案を出させ、案と費用から担当を選ぶ方法で、大型モデルへの依存と費用を減らしています。誰に任せるかを仕事ごとに選ぶ方式です。全作業を小型モデルへ替える方法とは条件が違います。
記事と動画ではレビュー対象そのものを変える
コードには実行結果、記事には資料と論旨、動画には映像と音声があります。どの分野でも同じ「総合レビュー」という指示にすると、確認したものと完成品との間に抜けが生じます。
記事は事実確認と読みやすさを分ける
事実確認の担当には、主張と一次資料を渡します。「9月から全員が使える」という記述なら、発表日、提供開始日、対象プランが一致するかを確認します。読みやすさの担当には、記事本文に加え、「AIに詳しくない営業担当者」など原稿を届けたい人とその予備知識を伝えます。執筆途中の説明は引き継がせない方法があります。書き手の説明がなくても意味が通るかを確かめるためです。
同じ段落を見ていても、二つの確認役の合格条件は異なります。事実が正しくても読みにくい文章はあり、読みやすくても根拠のない文章はあります。編集担当が両方の指摘を見て、事実の修正が見出しや結論まで及ぶかを判断します。文体の好みで意見が割れた場合は、読者と媒体の方針へ戻ります。
動画は台本の確認だけでは終わらない
動画の台本が正しくても、書き出した映像で字幕が切れたり、音声と表示の時刻がずれたりすることがあります。レビュー担当には、最終的に視聴者が見る映像と聞く音声へアクセスする手段が必要です。

例えば「00:18の字幕が画面外にはみ出す」という指摘なら、該当するフレームと字幕位置を示し、編集担当がその部分を直せます。「前半の説明が長く、何を伝える動画か分からない」という指摘は、台本と編集全体を見直す仕事です。前者を局所修正へ、後者を構成の判断へ分ければ、動画全体を毎回作り直す負担を減らせます。
字幕文字列、長さ、ファイルの有無など、規則で判定できる確認はスクリプトへ任せられます。視覚モデルで確認した静止画だけでは、カットの間や音声との同期までは保証できません。画像、動画、音声のどの入力を扱えるかはモデルと接続方法ごとに確認し、見ていない・聞いていない部分を合格扱いにしない運用が必要です。
2026年6月のVideoAgent研究でも、場面の計画、素材検索、尺の調整などを専門の処理へ分け、組み合わせる構成が提案されています。動画制作の分業は、同じ質問を複数のAIへ投げるだけではありません。全体の物語を保ちながら、映像と音声に固有の道具を適切な順に使う仕事です。
高性能モデル同士を組み合わせる価値はどこに残るか
作成役が賢くなれば、別モデルのレビューは不要になるのでしょうか。既知の小さな不具合を探すだけなら、自己検証の改善によって追加レビューの効果が薄くなる可能性があります。一方で、答えや進み方がまだ分からない仕事では、別の発想を並行して探す価値が残ります。
最新世代を組み合わせた例として、2026年9月9日付の数学のプレプリントがあります。著者らは、GPT-5.6、GPT-6、Claude Opus 5、Fable 5.1を、CodexとClaude Codeを中心とする環境で使い、長年の数学の予想に対する反例を得たと報告しました。
この研究では、モデルの系列ごとに作成役とレビュー役を固定していません。調査の進展に合わせて役割を変え、一部の探索担当には問題だけを、レビュー担当には過去の判定を含めず候補の議論を渡しています。人間は研究対象の意義を判断し、AI側は探索、反論、修正を調整しました。確かめた結果と失敗した試行をファイルへ残し、修正後には計算による確認を繰り返しています。
これは著者らによる研究過程の報告です。複数モデルが単独モデルより何割安いかを測った対照試験ではなく、数学的主張そのものについても本稿が独立に検証したものではありません。それでも、最新モデルの併用例として、製品名で役割を固定せず、探索の独立性と根拠の共有を両立させている点は参考になります。
独立性にも種類があります。同じモデルを別の会話で動かせば、作成時の説明に引っ張られる影響を減らせます。別系統のモデルなら発想の違いを期待できますが、同じ誤った資料を渡せば同じ結論に至る可能性があります。テスト、原典、実物の確認という別の根拠まで揃って初めて、意見の一致を超えて確かめられます。
ハーネスをつなぐなら引き継ぎと停止点を決める
CodexとClaude Codeを連携させると、呼び出す先のモデルに加え、そのエージェントが持つファイル探索、編集、実行確認の仕組みを利用できます。OpenAI公式の「codex-plugin-cc」では、Claude CodeからCodexへバックグラウンドレビューを依頼し、状況と結果を取得する操作が案内されています。
/codex:review --background
/codex:status
/codex:result
利用するモデルや認証、設定はCodex側のものです。Claude Codeの会話から呼んだからといって、Claude側で選んだモデルがCodexにも使われるわけではありません。現在のプラグインはCodexのapp serverを利用します。古い連携例にあるcodex mcp-serverは2026年9月5日に削除されており、手順の版を揃える必要があります。
一つの製品内でも、CodexとClaude Codeはサブエージェントごとのモデル指定に対応しています。Claude Codeの探索用エージェントExploreは、現在は常に軽量のHaikuを使う仕様ではありません。親モデルの継承や接続先による上限があるため、委任しただけで安くなったつもりにならず、実行時のモデル名を確認します。
引き継ぎでは、会話履歴を丸ごと渡す代わりに、対象の版、要件、成果物の場所、確認してほしい範囲、返してほしい根拠を渡せます。コードなら対象の差分、記事なら原稿の版、動画なら書き出したファイルを固定します。レビュー中に対象を更新する場合は作業場所を分け、指摘がどの版に対するものか分かる状態にします。
レビューの依頼は、例えば次のように書けます。
対象の成果物と要件を読み、問題候補を確認してください。
成果物は変更しないでください。

各指摘には、対象箇所、問題となる条件、根拠、確認方法を付けます。
コードなら再現入力、記事なら原典、動画なら時刻を示してください。
根拠が不足している指摘は、未検証と明記してください。
問題がなければその旨と、確認していない範囲を返してください。

初回の判断では、他のレビュー担当の結論を参照しないでください。
採否を判断する担当は、指摘を採用、却下、未確認に分けます。修正後は採用した問題が解消したかと、影響先を確認します。同じ問題で往復を繰り返す場合は、新しい証拠が増えているかを見て、増えていなければ人への引き継ぎや担当変更を選びます。
予算や回数にも停止点が必要です。例えば初回レビューと修正後の確認までを基本とし、重大な問題が残れば未完了として人へ返します。公式プラグインも、レビューと修正のループで両製品の利用枠を大きく消費する可能性を説明しています。
モデルが進化したら分担をどう組み替えるか
モデルの進化が分業へ与える影響は、一方向とは限りません。これまで補助役が必要だった仕事を単独で終えられるようになり、同時に、複数の担当で取り組める仕事の範囲も広がるからです。ここからは、前述の公式機能と研究を踏まえた見通しです。

表は横にスクロールできます
| 進化によって起きる変化 | 減らせる可能性がある分担 | 残す・増やす候補 |
|---|---|---|
| 単独での作成と自己検証が改善 | 毎回の全面レビュー、細かな指示の往復 | 重要な変更の独立確認 |
| 軽量モデルの能力が向上 | 高性能モデルによる定型作業 | 根拠付きの抽出、局所修正 |
| 長い文脈を保つ能力が向上 | 文脈の容量だけを理由にした細分化 | 並列に調べられる独立テーマ |
| 推論量やキャッシュの制御が改善 | 費用のためだけのモデル切り替え | 同じモデル内での段階的な推論量調整 |
| 扱える仕事がより難しくなる | 古い問題だけを基準にした役割固定 | 別の仮説、反例探索、実物による検証 |
残った誤りの性質にも注意が要ります。簡単な誤りが減ると、追加レビューで探す対象は複雑な仕様や曖昧な表現へ寄る可能性があります。その場合、指摘数の減少はレビューの失敗とは限らず、一件を確かめる費用は増えるかもしれません。反対に、単独の検証で十分な仕事へ重いレビューを続ければ、品質差が小さいまま費用だけが残ります。
人間の役割も、最後に承認するだけとは限りません。記事の論点を選び直す、動画の間を自分で編集する、コードの仕様を変更するなど、目的そのものを修正することがあります。その判断をAIへ戻す際は、変えた要件と残した要件を伝え、影響する部分を再検証します。モデルが賢くなっても、依頼者が決めていない目的まで自動的に確定するわけではありません。
トークン効率は採用できた成果物あたりで測る
「親のトークンが減った」「軽量モデルを使った」だけでは、全体の効率は判断できません。比較するのは、親子全員の実行、指摘の確認、修正、再検証、人の手直しまでを含む費用です。並列化で待ち時間が短くなり、総トークン数は増えることもあります。
表は横にスクロールできます
| 記録する指標 | 分かること |
|---|---|
| 親子全員の入力・出力・キャッシュと費用 | 委任や引き継ぎを含めて安くなったか |
| 開始から採用までの時間 | 並列化で待ち時間が減ったか |
| 実際に解消できた問題 | レビューが成果物を改善したか |
| 誤指摘と修正で生じた問題 | 確認役や修正役が手戻りを増やしていないか |
| 人の確認・修正時間と未解決事項 | AIの利用量の外へ負担を移していないか |
レビューの費用対効果は、指摘の件数よりも、追加で解消できた問題と増えた手戻りで見ます。軽量モデルの指摘を高性能モデルが毎回一から調べ直しているなら、報告に根拠が足りないか、分担が細かすぎる可能性があります。変更がほとんど全面的になるなら、作成段階から高性能モデルを使う構成とも比べます。
使用量の記録では、新しい入力、キャッシュの読み書き、出力を分けます。別モデルや別製品に渡したとき、元のキャッシュが共有されるとは限りません。Claude Codeの/usageなどで確認できる使用量と、サブスクリプションの実際の請求や利用上限も区別します。二つの契約に分散して長く作業できることは、全体のトークン効率とは別の利点です。
測り始めるなら、過去に問題と修正内容が分かっている仕事を使います。高性能モデル単独を基準に、同じモデルの独立レビュー、異なるモデルのレビュー、軽量モデルへの分担を比較します。道具、要件、対象の版を揃え、修正役も記録します。モデル更新時には、単独実行の推論量を下げた条件も加えます。
失敗した試行の費用を除外せず、同じ品質基準を満たした成果物一件あたりで比べます。モデル名、推論設定、ハーネスの版を残しておけば、AstraやFableの次の更新でも、どの分担を残し、どこをまとめるかを判断できます。
参照リンク14件
- OpenAIUsing GPT-6 Astra
- AnthropicIntroducing Claude Fable 5.1 and Claude Mythos 5.1
- AnthropicWhat's new in Claude Fable 5.1
- OpenAISubagents
- Tran・KielaSingle-Agent LLMs Outperform Multi-Agent Systems on Multi-Hop Reasoning Under Equal Thinking Token Budgets
- JinほかWeak Critics Make Strong Learners
- XiangほかCross-Model LLM Code Review
- AlazrakiほかScaling Small Agents Through Strategy Auctions
- VideoAgent研究チームVideoAgent: All-in-One Framework for Video Understanding and Editing
- Lai・Lim・RenPierce–Birkhoff conjecture is false
- OpenAIcodex-plugin-cc
- OpenAIChatGPT & Codex changelog
- AnthropicCreate custom subagents
- AnthropicManage costs effectively
2026年9月12日時点の公式資料を確認しています。仕様は更新される可能性があります。