2026年9月22日、OpenAIはGPT-6 SolとGPT-6 Lunaを、AnthropicはClaude Opus 5.5を同じ日に出しました。AIにプログラムを書かせる道具であるCodexやClaude Codeでは、どのモデルを選ぶかで待ち時間と費用が変わります。APIの出力単価は最安のLunaと最上位のGPT-6 AstraやClaude Fable 5.1で100倍離れていますが、Xでは「実装はLunaで足りる」「レビューはGPT系が強い」という体感が語られるだけで、課題と依頼文をそろえて比べた記録は見当たりません。そこで、同じ日に出たLuna、Sol、Opus 5.5に、各社の最上位であるGPT-6 AstraとClaude Fable 5.1を加えた5モデルへ、仕様を文章で決めた実装課題と、不具合を3件埋め込んだレビュー課題を同じ依頼文で渡しました。GPT系はCodex、Claude系はClaude Codeから動かすので、モデル単体ではなく各社の道具を含めた比較です。実装は、モデルには見せない正解判定用のテスト50件で採点しました。レビューは、埋め込んだ3件を見つけたかに加え、モデルが追加で挙げた不具合候補を筆者がコードを動かして本当に起きるか確かめました。単価の差が結果の差になった工程と、ならなかった工程を分け、安いモデルに任せられる仕事の線引きを示します。
同じ日に出た二社の新モデルと100倍の単価差
CodexはOpenAIの、Claude CodeはAnthropicの、コードを書くAIエージェントです。開発者が「この仕様で関数を作って」「この変更に不具合がないか見て」と文章で頼むと、AIがファイルを読み、コードを書き、テストを走らせて結果を返します。どちらの道具も裏で動くAIモデルを利用者が選べるので、モデルを変えると、返ってくるコードの質だけでなく、待ち時間、定額プランで消費する利用枠、APIで払う金額が変わります。
2026年9月22日に選択肢が一度に増えました。OpenAIはGPT-6 SolとGPT-6 Lunaを出し、価格を前世代のGPT-5.6 Sol、GPT-5.6 Lunaの半額以下にしました。公式の説明では、Solは複雑なコーディングとエージェント型の仕事向け、Lunaは要約、抽出、限定的なコーディングなど回数の多い仕事向けの最も効率のよいモデルです。同じ日にAnthropicはClaude Opus 5.5を出し、「ほとんどの作業で上位のClaude Fable 5.1と同水準、Opus 5より運用コストが40%低い」と説明しました。Claude Codeでは、Opus 5.5が既定のモデルになっています。
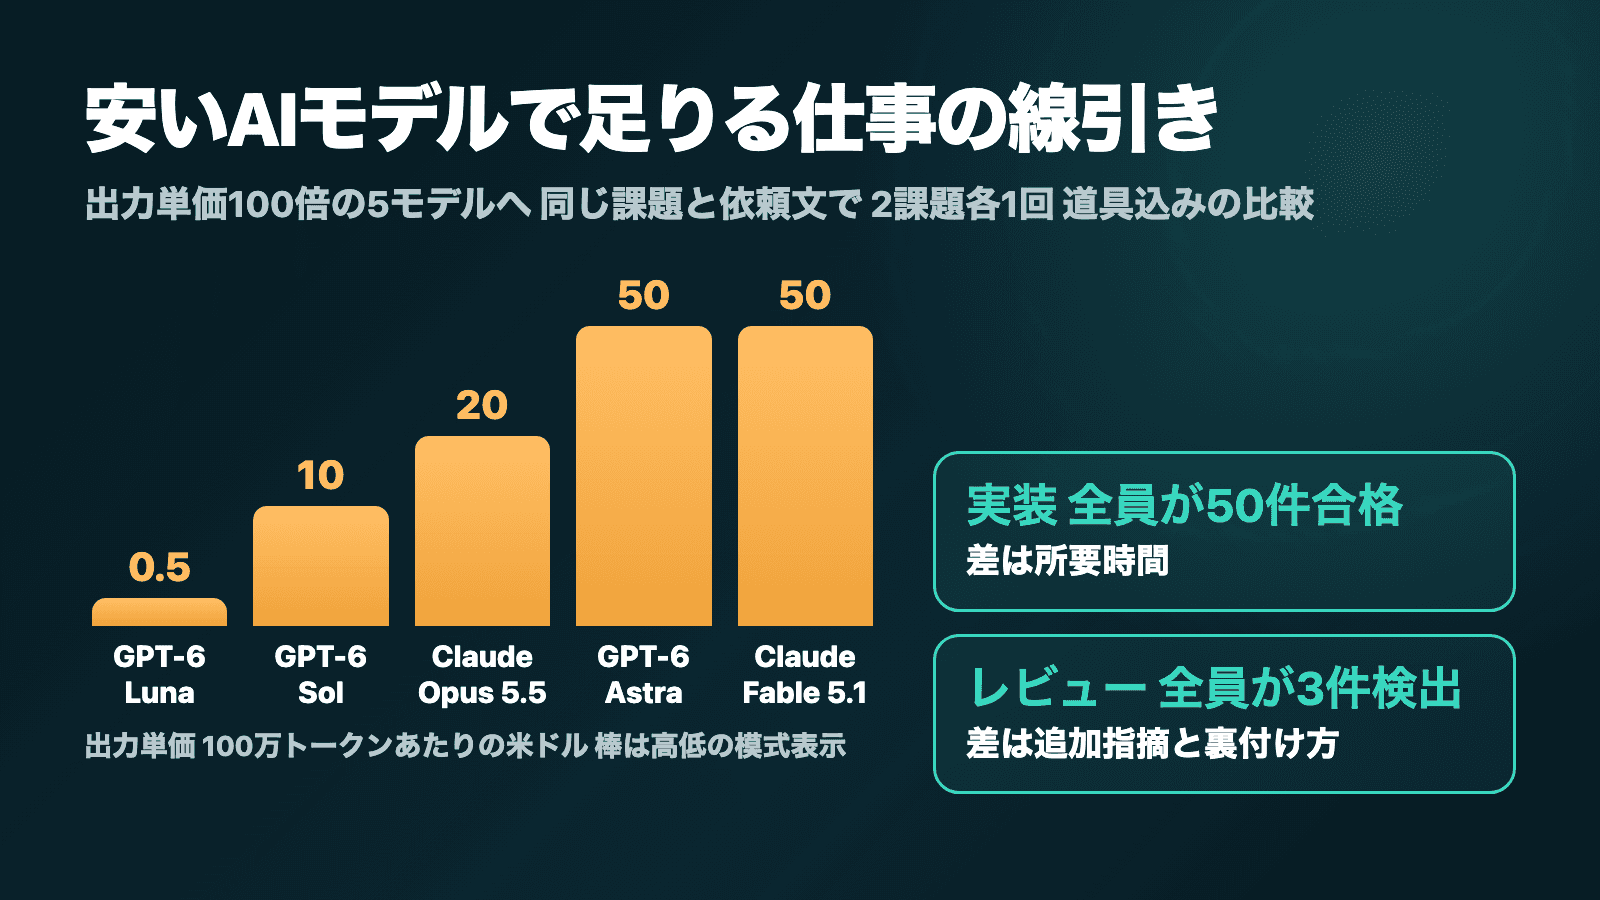
この記事で比べるのは、同じ日に出たLuna、Sol、Opus 5.5の3モデルに、各社の最上位であるGPT-6 AstraとClaude Fable 5.1を加えた5モデルです。最上位を入れるのは、安いモデルで足りるかを判断するには、同じ会社の最上位という物差しが要るからです。APIの単価を並べると、階段の幅がよく分かります。100万トークンあたりの出力単価は、Lunaが0.5ドル、Solが10ドル、Opus 5.5が20ドル、GPT-6 AstraとFable 5.1が50ドルです。最安と最上位で100倍です。トークンはAIが文章やコードを読み書きする単位で、日本語なら1文字が1〜2トークン、英語のコードなら数文字で1トークンほどになります。
| モデル | 提供元 | 公式の位置づけ | 入力単価 | 出力単価 |
|---|---|---|---|---|
| GPT-6 Luna | OpenAI | 回数の多い仕事向けの最も効率のよいモデル | 0.1ドル | 0.5ドル |
| GPT-6 Sol | OpenAI | 複雑なコーディングとエージェント型の仕事向け | 2ドル | 10ドル |
| Claude Opus 5.5 | Anthropic | ほとんどの作業でFable 5.1と同水準、Claude Codeの既定 | 4ドル | 20ドル |
| GPT-6 Astra | OpenAI | 最も高性能な最上位モデル | 10ドル | 50ドル |
| Claude Fable 5.1 | Anthropic | 最も要求の厳しい推論と長期のエージェント作業向け | 10ドル | 50ドル |
単価は2026年9月24日に各社の公式ページで確認した、100万トークンあたりの米ドルです。定額プランで使う場合は、この単価ではなく利用枠の消費量が変わります。キャッシュ利用時の割引や、27万2千トークンを超える長い入力への割増は省いています。
この階段を前にして、開発者が決めたいのは「どの仕事をどの段に任せるか」です。全部を最上位に任せれば費用が最も高くなり、全部を最安に任せれば失敗を見つけて直す手間が誰かに残ります。Xでは発売翌日から、実際に使った人の体感が流れ始めました。AIに働かせる技術を発信するまかねこさんは、2026年9月23日の投稿で「Lunaは最安ながら中位モデルに劣らず、余計なことをしないぶん優れている点すらある」「Opus 5.5は文章がうまいが、実装やコードレビューではGPT系に明らかに劣る」「レビューではAstraがSolより明らかに優れるケースが散見された」と書き、実装はCodexでSolとLuna、要所でAstra、それ以外はOpus 5.5という分担を提案しています。
体感は貴重ですが、条件が人によって違います。同じ課題を同じ文面で、単価の違う5つのモデルへ渡したら、どこで差が出るのか。この記事はそれを確かめます。
単価表とベンチマークだけでは決められない理由
単価表は費用の目安を教えてくれますが、結果の差は教えてくれません。各社が公表するベンチマークは結果の目安になりますが、今回の5モデルを一つの表で見比べられる公式資料はまだ出ていない状況です。AnthropicのOpus 5.5のシステムカードには、コマンド操作の課題を解くTerminal-Bench 4.0で、Opus 5.5が66.4%、Fable 5.1が55.8%、GPT-6 Astraが57.9%(OpenAIの公表値の引用)と並んでいますが、GPT-6 SolとLunaは載っていません。OpenAIがSolとLunaについて公表した値は、Opus 5.5と同じ条件で並べられないので、この記事の比較には使いません。
ベンチマークの数値は、測る側が用意した課題、思考の深さの設定、試行回数で変わります。Anthropicの数値も最大の思考設定で5回の平均です。開発者が日常で使う設定と同じとは限りません。まかねこさんも「各種ベンチマークではOpus 5.5のコーディング性能が他モデルを圧倒しているような数値が出ていたが、初期検証ではそこまでの性能は見られなかった」と書いています。
もう一つ、体感の比較には条件のばらつきがあります。使った課題の大きさ、指示の書き方、道具の設定、時間帯の混み具合が人ごとに違い、同じ人でも課題ごとに違います。「Lunaで足りた」と「Opusが劣った」が同じ課題で観測されたのかは、投稿からは分かりません。
そこで条件をそろえます。そろえるのは課題、日本語の依頼文、作業場所の初期状態、実行の時間帯の四つです。作業場所は、実装課題では何も置かない空の場所、レビュー課題では対象コード1ファイルだけを置いた場所から始めます。モデルを動かす道具はOpenAIのCodex CLIとAnthropicのClaude Codeで、それぞれ通常の設定のまま使うので、道具と設定の違いは残ります。この記事で言う「同じ条件」は、この四つをそろえたという意味です。評価は課題ごとに分けます。実装は隠しテストで採点し、レビューは埋め込んだ3件の検出と、追加の指摘を筆者が実行して再現できるかで評価します。小さな課題なので、実プロジェクトの差をそのまま表す実験ではありません。その代わり、単価の階段のどの段から結果が変わるのかを、一つの条件ではっきり見られます。
二つの課題をそれぞれ5モデルへ同じ依頼文で渡す
課題は二種類にしました。仕事の性質が違うからです。
一つ目は実装です。時間の表記を秒へ変換する関数と、秒を表記へ戻す関数の2つを作らせます。"1h30m"は5400秒、"1h 5m 3s"は3903秒に変換し、逆に3661秒は"1h1m1s"に戻すという具合です。仕様は日本語で16項目書き、単位の順序、重複の禁止、空白の扱い、不正な入力で投げる例外の型まで決めました。この課題では、合否を人が読んで決める必要がありません。筆者が仕様から先に隠しテスト50件を書き、正しい答えとして別に用意した実装(参照実装)で50件すべて通ることを確かめてから、モデルには見せずに採点に使いました。期待値は筆者が仕様から手で計算し、参照実装の結果と一致することで確かめています。50件は仕様の主要な条件を覆いますが、仕様のすべての組み合わせを保証するものではありません。依頼文では、実装と一緒にモデル自身のテストも書くよう指示しています。そのテストはモデルが自分の実装を確かめるためのもので、合否の判定には使いません。判定は筆者の隠しテスト50件だけで行います。
二つ目はレビューです。オンラインショップの会計計算をする約60行のプログラムに、筆者が不具合を3つ埋め込み、「不具合だけを行番号付きで報告してください。リファクタリングや命名の指摘は書かないでください」と頼みました。埋め込んだのは次の3つです。
- クーポンの期限日を"2026-09-30"のような日付だけの文字列で読むため、世界標準時の0時、つまり日本時間の朝9時で期限切れになる。仕様は「その日の終わりまで有効」。
- まとめ買い割引が、渡された商品一覧の単価を直接書き換える。同じ引数で2回呼ぶと割引が二重にかかる。仕様は「呼び出し側の一覧を変更しない」「同じ引数なら同じ結果」。
- 送料無料の判定を、クーポン適用前の金額で行う。仕様は「クーポン適用後の金額が5,000円以上なら無料」。
こちらは、合否を隠しテストで決めず、仕様に書いてある約束をコードが破っている箇所を読み取り、必要ならモデル自身が実行して再現する仕事です。埋め込んだ3件は冒頭に書いた仕様への明らかな違反で、それ以外に何を指摘するかはモデルに任せています。追加の指摘には、仕様に書かれていない条件や、仕様の解釈が分かれるものが含まれます。

5モデルの起動経路は二つです。GPT-6 Luna、Sol、AstraはCodex CLI、Opus 5.5とFable 5.1はClaude Codeから起動しました。どちらも非対話モードで、依頼文を渡した後は人が追加の指示を出さず、モデルが自分でファイルを作り、テストを実行して終わります。思考の深さは、モデルが答える前に考える量の設定で、Codexでは中間、Claude Codeでは既定のままにしました。各課題を各モデルに1回ずつ、合計10回の実行を2026年9月24日の同じ時間帯に行いました。
今回の小さな実装課題では単価に関係なく全員が50件合格
結果は、5モデルとも隠しテスト50件に全問合格でした。合格は、このテストが覆う範囲での判定です。作ったファイルも、指示どおり実装とテストの2本だけで、余分な設定ファイルや説明書を足したモデルはありませんでした。
| モデル | 所要時間 | 隠しテスト | 自作テストの行数 |
|---|---|---|---|
| GPT-6 Luna | 52秒 | 50件合格 | 40行 |
| GPT-6 Sol | 78秒 | 50件合格 | 57行 |
| GPT-6 Astra | 88秒 | 50件合格 | 68行 |
| Claude Opus 5.5 | 220秒 | 50件合格 | 184行 |
| Claude Fable 5.1 | 67秒 | 50件合格 | 142行 |
差が出たのは、所要時間、モデルが自分で書いたテストの行数、道具が表示した使用量です。所要時間はモデル単体の速さではなく、Codex CLIやClaude Codeがファイルを作りテストを走らせる処理も含めた、今回の構成での値です。最安のLunaが52秒で今回の構成では最短で、Codexが表示した使用トークンもGPT系3モデルの中で最少の15,551でした。Opus 5.5は220秒かかり、7回の往復で思考トークンを19,126使い、自作テストを184行書きました。Fable 5.1は同じClaude Codeでも3回の往復で67秒でした。Claude Codeが表示した費用は、Opus 5.5が0.88ドル、Fable 5.1が0.83ドルで、単価が2.5倍違うのに費用はほぼ同じです。Opus 5.5の往復と思考トークンが多かったためと考えられますが、道具ごとに使用量の定義が違うので断定はできません。ただし、5モデルの実費は同じ軸では比べられません。Codexが表示する使用量は入力と出力の合計で、Claude Codeが表示する出力トークンや費用とは定義が違うからです。この記事で単価の階段と並べるのは、所要時間と合格数だけです。安いモデルへ任せれば費用が下がるとは、今回の数字だけからは言えません。

この課題で観測できたことは二つです。仕様が文章とテストで決まっている小さな実装では、単価が100倍違うモデルの間で合格数に差が出ませんでした。指示どおりの2ファイルという点は5モデル共通でした。Luna固有に観測できたのは、最短の時間と、GPT系3モデルの中で最少の使用トークンです。Lunaは実装を52秒で終え、今回の構成では5モデルで最短でした。今回測った数値はXで語られていた「余計なことをしない」という印象と整合しますが、余計な行動そのものを測ったわけではなく、使用量の定義も提供元で違います。
レビュー課題は全モデルが3件を検出し差は追加指摘と裏付け方
レビュー課題も、埋め込んだ3件は5モデルすべてが見つけました。差が出たのは、埋め込んでいない箇所をどこまで指摘したかと、指摘の裏付け方です。
検出したと数える基準は、埋め込んだ不具合について何がどう誤るかを特定して報告したことです。行番号のずれは検出の判定に含めず、別に記します。報告された指摘は三つに分けて数えます。埋め込んだ3件は仕様違反です。埋め込んでいない指摘のうち、筆者が実行して再現でき、実際の店なら誤った金額や誤った受け付けになるものを「再現できた追加の問題」、仕様の読み方で結論が変わるものを「解釈次第」とします。仕様に書かれていない事柄への指摘も、再現できれば前者に数えます。
| モデル | 所要時間 | 埋め込んだ3件の検出 | 追加の指摘の数 | 追加指摘のうち再現できた数 | 埋め込んだ3件の報告の形式 |
|---|---|---|---|---|---|
| GPT-6 Luna | 28秒 | 3件 | 0件 | 該当なし | 再現する入力例を文章で示す |
| GPT-6 Sol | 36秒 | 3件 | 1件 | 0件(同じ商品が複数行に分かれると割引されない、は解釈次第) | 入力例と金額を示す |
| GPT-6 Astra | 70秒 | 3件 | 0件 | 該当なし | 各指摘に期待値と実際の値を示す |
| Claude Opus 5.5 | 100秒 | 3件 | 3件 | 2件(期限日が不正だと無期限に通る、割引率で計算した後の金額の端数が浮動小数点でぶれる。残る同じ商品が複数行は解釈次第) | コードを別の場所へ複製して実行し、結果の数値を示す |
| Claude Fable 5.1 | 52秒 | 3件 | 0件 | 該当なし | 実行して再現し、消費税の四捨五入も0〜2,000万円で総当たりして問題なしと報告 |
追加の指摘は、筆者が実行して確かめました。Opus 5.5が挙げた、割引率で計算した後の金額の端数処理は、仕様では未定義ですが再現できた追加の問題です。45円の30%引きは計算機の内部で31.4999…になり31円へ切り捨てられ、15円の30%引きは10.5で11円へ切り上がります。同じ「.5」で丸め方向が揃いません。仕様に割引率で計算した後の端数処理は書いていないので、埋め込んだ不具合ではありませんが、実際の店なら1円のずれとして問い合わせが来る種類の問題です。期限日が不正な文字列のときに期限確認を素通りする点も実際に再現し、期限を確かめられないクーポンが通ってしまうので、こちらも仕様では未定義ですが、再現できた追加の問題と数えます。一方、SolとOpus 5.5が挙げた「同じ商品が複数行に分かれた場合」は、仕様の「同一商品を10個以上」をどう読むかで変わる指摘で、不具合と断定はできません。
Lunaは3件を最短の28秒で見つけましたが、行番号に、コードの行ではなく冒頭の仕様コメントの行を挙げた箇所がありました。読む人が該当箇所を探し直す手間が少し残ります。Astraは追加指摘こそありませんが、3件それぞれに「期待値4,950円、実際は4,400円」のように数字を添え、そのまま修正の受け入れ条件に使える形でした。
この課題で分かったのは、レビューの成果を「見つけた数」だけで測れないことです。3件はどのモデルも見つけました。今回はOpus 5.5が仕様に書かれていない範囲まで踏み込み、再現できた追加の問題を2件見つけましたが、解釈次第の指摘も同時に増えました。単価が同じ最上位のAstraとFable 5.1は3件だけを報告しています。出力単価50ドルのAstraとFable 5.1が追加指摘0件、20ドルのOpus 5.5が3件、10ドルのSolが1件なので、単価が高いモデルほど追加指摘が増えるという関係は見えませんでした。増えた指摘を不具合かどうか裁くのは、レビューを依頼した開発担当者の仕事として残ります。
Xの体感と実測が一致した点と食い違った点
まかねこさんの投稿に戻り、今回の実験結果と投稿の内容を比べると、同じ方向を指す主張と、今回の数字とは合わない主張に分かれます。まかねこさんが試した課題と今回の課題は同じではないので、比べられるのは結論の方向だけです。
「Lunaは余計なことをせず、中位モデルに劣らない」は、同じ方向を指しています。実装では最短の時間で同じ合格数、レビューでも3件を最短で見つけました。「Solは性能はよいが少し遅い」は、この規模では観測できませんでした。今回の構成ではSolの実装78秒はAstraの88秒より短く、Lunaとの差は26秒です。「レビューはAstraがSolより明らかに優れる」も、3件の検出では差がつかず、違いは指摘の書き方に出ただけです。60行のコードでは、上位モデルの差が現れる余地が小さかったと考えるのが自然です。
「Opus 5.5は実装やレビューでGPT系に明らかに劣る」は、この実験では確認できませんでした。実装は同じ50件合格、レビューは最も多く指摘し、再現できた追加の問題を2件見つけました。ただし時間は最長で、実装に220秒、レビューに100秒かかっています。「劣る」という体感の中身が、成果物の質ではなく待ち時間や指摘の多さだった可能性はあります。まかねこさん自身も「しばらく使ってみて印象が変わったらまた投稿する」と留保しています。
2026年9月23日には、まかねこさん以外にも実際に使った感想や比較を投稿した人がいます。次に挙げる投稿の範囲でも、体感どうしで一致している点と割れている点があります。共通しているのは、Opus 5.5がOpus 5から明確によくなりFable 5.1と同等かそれ以上の場面があること、そしてGPT-6 Solは賢さの向上が小さく価値は価格の半減にあることです。Anthropicの社員であるBoris Chernyさんは、CからRustへの移植という一つの長い作業の所要時間と費用で、Opus 5.5が9.5時間、Fable 5.1が12時間、費用は51%少なかったと投稿しています。開発元の発言として読む必要はありますが、まかねこさんの「Fable 5.1と同等かそれ以上」と向きは同じです。Solについては、実務の10課題を動画で比べたNate Herkさんが「GPT-6 Solは5.6 Solより目立ってよくなってはいない」と前置きし、Hanyさんも体感として「名前が変わっただけに感じる。価格が半分になったのが主な変化」と書いています。対象も指標も投稿ごとに違うので、言えるのは向きが同じという点までです。今回の実験は前世代との比較を含まないので、Opus 5からの改善幅と、Solが5.6 Solからどれだけ変わったかは確かめていません。
割れているのはLunaです。金のニワトリさんは、道具を呼びながら作業を進める型の自作TypeScript課題で、GPT-6 Lunaが前世代の5.6 Lunaより大幅に劣化したと報告しています。一方でRailsの作者であるDHHさんは、Railsアプリの課題を完了できた割合と費用で測る自身の評価で、Luna(思考最大の設定)が費用11ドルで完了率18%だったと報告し、費用対効果に見どころがあると評価しています。Sol側の数値は投稿の本文にないので、Solとの差は公開文だけでは判定できません。今回の実験ではGPT系の思考を中間に設定しており、DHHさんの設定とも異なります。
ここからは複数の投稿を並べて見える仮説で、今回の実験で確かめた結論ではありません。まかねこさんの「実装の最良の選択肢」と並べると、Lunaは単発の小さな実装や大量の軽い処理では強く、道具を何度も呼びながら長く動くエージェント的な仕事では弱い、という分かれ方に見えます。今回の実装課題は前者の端にあるので、Lunaの全問合格はこの仮説と矛盾しませんが、仮説を裏付けた結果でもありません。
文章については、EveryのDan Shipperさんが、Opus 5.5の読みやすさを自社の指標で測った中の最高としつつ、要点を冒頭に置く点ではSolとAstraが上だと書いています。「文章はOpus」という体感も、何を文章のよさと呼ぶかで変わります。
X上の感想は、どれも発売から数日の初日評価です。この記事の実験も、1課題につき1回ずつ、60行のコードという小さな規模です。両方に共通するのは、実プロジェクトで数百ファイルを扱ったときの差を語れないことです。それでも、単価の階段と結果の階段が同じ形にならないことは、条件をそろえた小さな実験でもはっきり見えました。
検証を誰が持つかで任せるモデルを決める
ここからは筆者の見立てです。今回の2課題を各1回、Codex CLIとClaude Codeを含む構成で試した結果に基づくもので、モデル単体の性能の比較ではありません。今回の結果を「その仕事の合否を誰が決めるか」という軸で読み直すと、任せ先を決めやすくなります。
合否をテストで決められる仕事は、最安のモデルから試してよい仕事です。仕様を文章で書き、受け入れ条件をテストにし、成果物を受け入れる前にそのテストを自動で実行して失敗したものを通さない仕組みがあれば、モデルが間違えても受け入れの前で止まります。今回の隠しテストによる事後の採点は、その仕組みを実験用に簡略化したものです。今回の実装課題はこの型で、Lunaで十分でした。APIの出力単価は最上位の100分の1で、待ち時間も最短でした。実際の費用は使ったトークン数で決まるので、単価の差がそのまま100倍の差になるとは限りません。テストを先に書く手間は増えますが、その手間は上位モデルに任せても必要なものです。
合否を人が読んで決める仕事では、選ぶ基準が変わります。仕様に書かれていない問題を探すレビュー、設計の選択肢を挙げる仕事、曖昧な依頼を解釈する仕事がこれにあたります。今回のレビュー課題は、約60行のコードに筆者が埋め込んだ既知の不具合3件を見つけられるかと、追加の指摘を実行で再現できるかを、1回だけ測ったものです。一般のコードレビューや設計レビュー、未知の不具合を見つける力までは測っていません。その条件では、Opus 5.5だけが追加の指摘を3件出し、そのうち2件は実行で再現できた追加の問題でした。AstraとFable 5.1は追加指摘を出していません。追加指摘を多く出すモデルを選ぶなら、増えた指摘を裁く時間を最初から見込む必要があります。指摘が多いことと、直すべき問題が多いことは別です。
文章を書く仕事は今回試していません。まかねこさんはOpus 5.5について「文章を書かせるとやっぱりうまい」と書き、Dan Shipperさんは要点の置き方ではSolとAstraが上だと書いています。合否を決めるのは、文章の採用を決める依頼者や編集者で、何を読みやすいと呼ぶかは人によって違います。文章でも分け方は同じです。文体や構成の基準を人が決め、その基準に照らして確認する作業だけを文書化して安いモデルに任せる形なら、合否を決めるのは基準を書いた人のままです。基準を作る段階の仕事にどのモデルが向くかは、今回の実験からは選べません。人が基準に照らして判断する仕事として扱うのが、現時点で言える範囲です。

この分け方には条件があります。テストで止められるのは、テストに書いた範囲だけです。仕様を書ける人と、テストを先に書く時間が必要です。仕様を書けない段階の探索的な仕事は、安いモデルに任せると失敗を検出できません。最初は上位のモデルで仕様と受け入れ条件を固め、繰り返す段階になったら安いモデルへ下ろす、という順番が現実的です。
まかねこさんの「実装はSolとLuna、要所でAstra、それ以外はOpus 5.5」という分担は、今回の結果とも矛盾しません。付け加えるなら、その分担が効くのは、実装の合否をテストが持ち、要所の合否を人が持つ準備ができているときです。モデルを選ぶ前に、その仕事の合否を誰が決めるのかを決めておくと、単価の階段を安心して下りられます。
試した環境と実験の限界
実験日は2026年9月24日です。macOSのApple Silicon環境で、Node.js v25.8.1、Codex CLI 0.156.0、Claude Code 2.1.281を使いました。GPT系の3モデルはCodex CLIの非対話モードで思考の深さを中間に固定し、Claude系の2モデルはClaude Codeの非対話モードで既定の設定のままです。5モデルは各課題の依頼文を受け取り、実装課題は空の作業場所、レビュー課題は対象コード1ファイルだけを置いた作業場所で動きました。
課題は1種類につき1回ずつです。同じモデルでも実行ごとに結果は揺れるので、1回の合否や秒数を確定した性能として読まないでください。実装課題の所要時間には、モデルが自分でテストを書いて実行する時間が含まれます。Codexが表示する使用トークンは入力と出力の合計で、Claude Codeが表示する出力トークンや費用とは同じ軸で比べられません。
外部へ送ったのは、筆者が書いた仕様、レビュー対象の約60行、依頼文だけです。社内のコードで同じ実験をする場合は、送信先のモデル提供元のデータ取り扱い条件を確認してください。
参照リンク18件
- OpenAI Developer CommunityAnnouncing GPT-6 Sol and GPT-6 Luna in the API, Codex, and ChatGPT(2026年9月22日)
- OpenAIChatGPT Learn: Models(SolとLunaの位置づけ)
- OpenAIAPI Pricing(GPT-6 Luna、Sol、Astra、GPT-5.6の価格)
- OpenAIChatGPT & Codex changelog(Codex CLI v0.156.0でのSol/Luna提供)
- AnthropicClaude Opus 5.5(2026年9月22日発表)
- AnthropicClaude Opus 5.5 overview(価格、コンテキスト、既定のeffort)
- AnthropicClaude Opus 5.5 System Card(表8.1.Aのベンチマーク)
- AnthropicClaude Fable 5.1 overview(価格)
- AnthropicClaude Code: Model configuration(既定モデルがOpus 5.5)
- ITmedia NEWSOpenAI、「GPT-6 Sol」と「GPT-6 Luna」公開 API料金は前世代の半額に
- ITmedia NEWSAnthropic、「Claude Opus 5.5」公開
- X(まかねこ @makaneko_AI)GPT-6 Sol/Luna, Claude Opus 5.5の感想(2026年9月23日の投稿)
- X(Hany @hany99dev)GPT-6 Solの感想(2026年9月23日の投稿)
- X(Boris Cherny @bcherny、Anthropic)HAProxyのCからRustへの移植でOpus 5.5とFable 5.1を比較(2026年9月23日)
- X(Nate Herk @nateherk)Opus 5.5とGPT-6 Solを10ユースケースで比較(2026年9月23日)
- X(金のニワトリ @gosrum)自作のTypeScript向けエージェント課題でOpus 5.5、GPT-6 Sol、GPT-6 Lunaを比較(2026年9月23日)
- X(DHH @dhh)Rails向けエージェント評価でのGPT-6 Luna(2026年9月23日)
- X(Dan Shipper @danshipper、Every)GPT-6 SolとOpus 5.5の文章と長時間ビルドの比較(2026年9月23日)
2026年9月24日時点の公式資料を確認しています。仕様は更新される可能性があります。