AIにプログラムを書いてもらった後、実際の仕事で使う前には、意図した動作になっているかを確かめる必要があります。変更されたコードを読み、問題を探す作業がコードレビューです。AlibabaのOpenCodeReviewには、確認するファイルや点検項目を取り出す機能があります。今回はその準備機能を使い、筆者が材料を手動でCodexへ渡してレビューを依頼し、返された指摘をコードの実行で確かめました。コードレビューを頼むときに何を渡せばよいのか、返ってきた「指摘なし」をどう受け止めればよいのか。基本の役割から説明し、Codexと組み合わせた実験で確かめます。
AIが書いたコードを使う前の確認
たとえば、表に入った数値の平均を計算する小さなプログラムを、AIに作ってもらう場面を考えてください。いくつか数字を入れて期待した答えが返れば、ひとまず動いたことは分かります。しかし、数値が一つもない表を渡したらどうなるか、入力の範囲が変わっても同じように使えるかは、それだけでは分かりません。仕事で使うには、普段の入力で動くことと、想定する条件を満たしていることの両方を確かめたいところです。
コードレビューは、プログラムを実際に動かすテストと並んで、その確認に使う作業です。書いたコードや変更点を読み、処理の抜け、条件の取り違え、別の機能への影響を探します。「数値がない場合は0を返してほしい」と決めているなら、その約束どおりに書かれているかも確認します。コードを読めることに加え、何を正しい動作とするかを知っている必要があります。
この読み取りをAIに手伝わせるときも、依頼する側には準備が残ります。どのファイルを確認するのか、以前のコードから何を変えたのか、どの条件を重点的に調べるのかを渡さなければなりません。変更したコードだけを見せても、説明文に書いた仕様や別のファイルとの関係が伝わっていなければ、確かめたい問題を見落とす余地があります。
今回使うのは、OpenCodeReviewのうちレビューの材料を取り出す部分です。変更されたファイルを選び、プログラミング言語に応じた点検項目を用意できます。Codexへの受け渡しとレビューの依頼は、筆者が手動で行います。AIへ毎回どこを見るべきか一から説明している人には、変更ファイルの選択と言語ごとの点検項目の提示をまとめられる点が使いどころになります。
ただし、準備が整ったことと、コードに問題がないことは別に確かめる必要があります。そこで筆者は、OpenCodeReviewが何をレビュー対象に選ぶのかを確認したうえで、その材料をCodexへ渡しました。CodexはOpenAIのコーディング用AIです。今回は端末で操作するCodex CLIから、オンラインのAIモデルへ材料を送りました。まず不具合のある小さなコードをレビューさせ、指摘された問題を直してから、そのコードをもう一度レビューさせます。AIの「指摘なし」が、実際に問題のない状態を意味するとは限りません。そこで、返された指摘と「指摘なし」の両方を、コードが仕様どおりに動くか実行して確かめました。
レビューの材料を用意してCodexへ渡す
今回の役割分担は、OpenCodeReviewが対象ファイルと点検項目を用意し、Codexがコードを仕様に照らして不具合を判断する、というものです。OpenCodeReviewでは、この使い方を「委譲モード」と呼んでいます。OpenCodeReviewへAIの接続先や認証用のAPIキーを新しく設定せず、利用中のCodexと組み合わせられます。
端末から点検項目を取り出すコマンドを実行すると、ファイルに合う点検項目が返ります。Python向けには、空の入力、ゼロ除算、呼び出し間で共有されるリストなどが具体的に挙がっていました。同じ観点を毎回手書きで依頼する手間を減らせます。ただし、点検項目は「空の入力を確認する」という一般的な観点です。「空なら0を返す」のか「エラーにする」のかという、そのプログラムで期待する動作は、使う人が仕様として別に伝えます。
筆者は、点検項目と、変更前後のコードの違いを示す「差分」をCodexへ渡し、ファイル名、行、問題が起きる入力、期待した結果を返すよう依頼しました。点検項目の抽出だけではバグの報告は出ません。コードを読み、仕様に照らして欠陥かどうかを判断したのはCodexです。
標準のレビュー機能では、OpenCodeReviewに接続先のAIを設定し、OpenCodeReviewからそのAIへレビューを依頼します。今回は標準のレビュー機能を実行していません。実行したのは、委譲モードの対象一覧と点検項目を取り出すコマンドです。取り出した材料は筆者が手動でCodexへ渡しました。これから示す結果は、委譲モードで準備した材料をCodexへ渡した場合のものです。OpenCodeReview単体の検出率や、標準レビューの精度を測った結果としては扱えません。
6ファイルの変更から対象になったのは2本
どの種類の変更が対象になるかを確かめるため、実験用のプロジェクトには、プログラミング言語Pythonで書いたコードのほかに、説明文、依存パッケージの情報、削除したファイルなどを含めました。変更は合計6ファイルありましたが、既定の設定で対象になったのは、削除されずに残っているPythonの2本だけでした。
レビューを頼む前に使ったのが、対象を一覧にするocr delegate previewです。ocrはOpenCodeReviewを端末から操作するコマンド名です。
| 変更したもの | 既定の選択結果 | 表示された理由 |
|---|---|---|
| 平均計算とメモ追加のPythonファイル | 2本とも対象 | 対応するコードとして選択 |
| READMEの説明文 | 対象外 | 対応外の拡張子 |
| 今回だけの独自拡張子のファイル | 対象外 | 対応外の拡張子 |
package-lock.json | 対象外 | 既定の除外パターン |
| 削除したPythonファイル | 対象外 | 削除済み |
対象一覧が返った時点で分かるのは、どのファイルをレビューへ回すかです。コードの正しさは、その後でAIが判断します。
除外の扱いは、使い始める前に見る価値があります。説明文に書いた仕様とコードの食い違いを調べたいのに、コードだけを渡していたら、期待した確認になりません。今回は仕様を別途依頼文へ入れました。READMEとpackage-lock.jsonを明示的に含める設定も試すと、その2本が追加され、対象は4本へ増えました。独自拡張子のファイルと削除済みのPythonファイルは対象外のままでした。ただし、追加した2本をCodexへ渡して正しくレビューできるかは、この試験では確かめていません。
平均計算とメモ追加をレビューして確かめる
対象選択からレビュー、動作確認までの役割は次のとおりです。この流れに沿って、実際に不具合を見つけられるかを確かめます。
対象に選ばれたPythonの2本は、数値の平均を出すmean_score.pyと、メモをリストへ追加するnotes.pyです。まず空のリストで平均を求めるとエラーになるコードと、別々に追加したはずのメモが混ざるコードを用意しました。OpenCodeReviewから取り出したPython用の点検項目、変更前後の差分、期待する動作を、Codexへ渡すと、空リストでのゼロ除算と、別々の呼び出しでメモが共有される問題を指摘しました。期待する動作は、空リストなら0を返し、保存先を省略したメモ追加では呼び出しごとに別のリストを使うことです。
空なら0を返し、メモの保存先も呼び出しごとに作るよう直すと、修正版を初めてレビューしたときは、指摘ゼロになりました。ところが、依頼文も渡すコードも変えずに再度レビューすると、平均計算にもう一つ問題が見つかります。各レビューは会話履歴を引き継がない別セッションで実行しました。モデルは指定せず、再実行時はgpt-6-astraと確認できましたが、初回の記録にはモデル名が残っていません。同じモデルだったと断定できないため、回答の違いをAIの揺らぎだけに帰することはできません。
def mean_score(scores):
    if not scores:
        return 0.0
    return sum(scores) / len(scores)
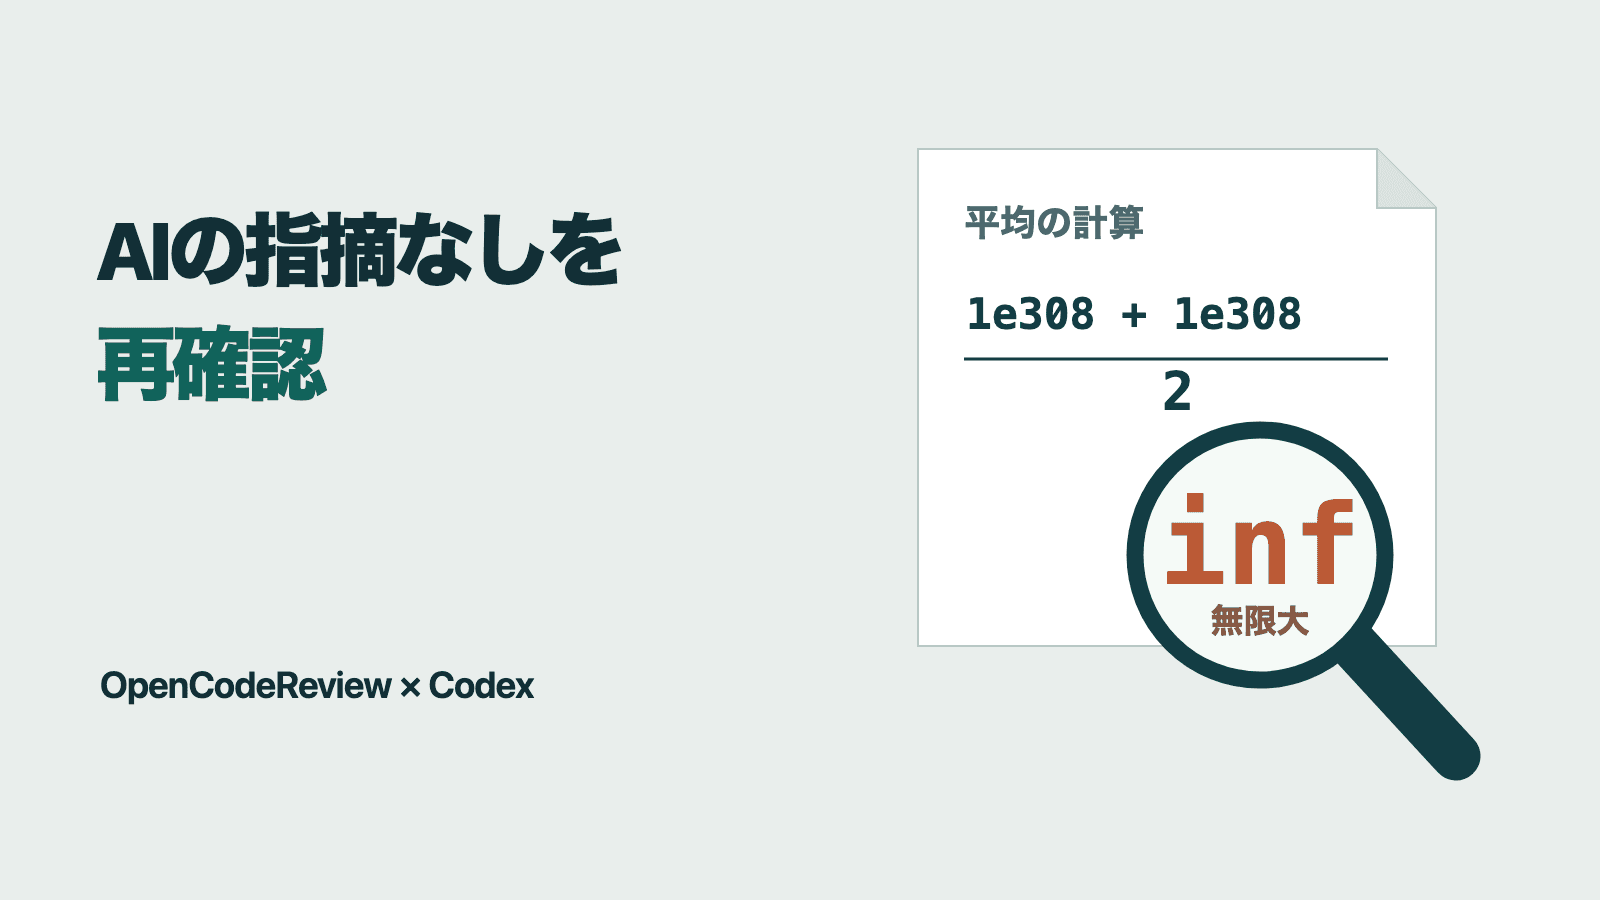
仕様は「有限の数のリストを受け取り、算術平均を返す」としていました。1e308、つまり10の308乗を二つ渡すと、正しい平均は同じ1e308です。しかし、先に合計する段階で浮動小数点数の扱える範囲を超え、結果は無限大を表すinfになりました。Codexの追加指摘どおり、Pythonで実行しても再現しました。
| 渡したコード | 各版の1回目のレビュー | 同じ版・同じ依頼での2回目 | コードを実行した確認 |
|---|---|---|---|
| 最初の不具合を含む版 | 空リストのゼロ除算とメモの混在を指摘 | 同じ二つを指摘 | 両方とも再現 |
| 二つの不具合を直した版 | 指摘なし | 巨大な数の平均が無限大になる問題を指摘 | 追加の問題も再現 |
修正版では、1回目に指摘がなかった一方、同じコードと依頼文を使った2回目に平均計算の問題が見つかりました。この結果だけで、AIレビューを繰り返せば必ず欠陥が見つかるとは言えません。修正版の1回目で「指摘なし」と答えられた時点でも、仕様に反する動作が残っていたことは、コードの実行で確認できました。修正後に試した小さな数の平均やメモ追加は正常でしたが、その確認だけでは巨大な数の問題を拾えませんでした。

手元の変更をレビューへ渡す手順
自分のコードで試す場合は、変更履歴を管理するGitで保存したプロジェクトと、その変更で実現したい動作の説明を用意します。AIへ渡すコードには秘密情報を含めず、小さな変更から始めると指摘を確かめやすくなります。
Codexへ渡す材料は、OpenCodeReviewが出す点検項目、Gitで取り出す変更前後の差分、自分で書く期待する動作の説明です。Git 2.41以上を用意し、公式の導入手順でocrをインストールしたら、プロジェクトの端末で次を実行して、対象一覧、点検項目、変更前後の差分を取り出します。mean_score.pyとnotes.pyは今回の例なので、実際に対象になったファイル名へ置き換えてください。
ocr delegate preview
ocr delegate rule mean_score.py notes.py
git diff HEAD -- mean_score.py notes.py
最初のコマンドで対象と除外理由を読み、二つ目で点検項目、三つ目で変更前後の差分を取り出します。新しく作った未追跡ファイルはgit diff HEADに出ないため、そのファイルの内容も別途渡します。
Codexなどへの依頼には、点検項目と差分に加えて、正常とみなす動作を書きます。今回の平均計算なら「有限の数を並べたリストの算術平均を返す。巨大な有限数も入力範囲に含め、空のときは0を返す」、メモ追加なら「保存先を省略した場合は毎回新しいリストを使う」という条件です。コードだけを見て、業務上の仕様まで推測させないようにします。
次の仕様、点検項目、差分を使ってレビューしてください。再現できる不具合ごとに、ファイルと行、再現入力、期待値と実際の違いを示してください。コードの修正はまだ行わないでください。
この手順を自分のコードに使う人は、Codexから指摘を受け取ったら、その入力でコードを実行するか、同じ条件のテストを追加します。今回の巨大な数のように、仕様に含めるべき値か判断が必要な場合は、入力範囲も確認します。たとえば得点が0から100までに限られる業務なら、その制約を仕様と入力処理の両方へ反映するのが次の作業です。
試した環境と外部へ渡した内容
実験日は2026年9月22日です。macOSのApple Silicon環境でOpenCodeReview v1.12.8を使い、Gitで変更履歴を保存した、実験用の小規模なコードだけを対象にしました。Codex CLIは0.155.1、再実行時の起動表示で確認したモデルはgpt-6-astraです。コードの動作はPython 3.14.6で確かめました。
各AIレビューの回答待ちは、今回の小さなコードでは約12〜21秒でした。実際のプロジェクトでの待ち時間や、他のレビュー方法との速度差を示す数字ではありません。
OpenCodeReviewによるレビュー対象と点検項目の抽出は、外部通信を止めたローカル環境で行いました。その後、Codex CLIからオンラインのAIモデルへ点検項目とコードを送り、仕様に反する動作を指摘させました。
Codexへ渡したのは、今回作ったコードと仕様、公開されている点検項目、差分だけです。OpenCodeReviewへ追加のAPIキーを渡さない委譲モードでも、コードを渡す先のAIサービスの利用枠とデータ取り扱い条件は適用されます。社内コードで使う場合は、その送信先を確認する必要があります。
すでにCodexなどを使っているなら、OpenCodeReviewで対象と点検項目を取り出し、手動でCodexへ渡す方法を、小さな変更のレビューに組み込めます。採用する際は、対象外になったファイルと、仕様から選んだ入力例を確認する工程を残してください。AIが返した指摘件数だけでは、変更全体の確認が終わったかは判断できません。
参照リンク6件
2026年9月22日時点の公式資料を確認しています。仕様は更新される可能性があります。