AIにコードを書かせる費用は、単価に加え、考える量や修正の回数で変わります。GPT-6.1 SolとClaude Opus 5.5を中心に、旧GPT-6 Sol、Astra、Fable 5.1の料金と第三者評価を比較しました。同じ実装課題を渡した手元の結果も使い、追加料金を払う理由と、安いモデルから試せる条件を整理します。
AIに実装を任せるときに増える選択肢
AIにアプリの変更を頼むとき、人が渡すのは完成したコードではなく、「注文の一部を返品できるようにしたい」「この不具合を直したい」といった目的です。AIは既存のファイルを読み、変更する場所を探し、コードを書いてテストを実行します。結果が合わなければ、原因を調べて修正します。開発を助けるAIには、こうした作業を何度も続ける能力が求められます。
OpenAIのCodexとAnthropicのClaude Codeは、AIがファイルや実行環境を使って開発を進める道具です。その中で、何を調べ、どう直すかを判断する役割を担うのがAIモデルです。同じ道具でも、使うモデルや、考える量を指定する「推論設定」を変えると、結果と費用が変わります。
OpenAIは2026年9月29日、開発や長い作業向けの新モデルGPT-6.1 Solを公開しました。2026年9月22日公開のClaude Opus 5.5と比べると、通常の入出力単価は半額です。以下では新しいモデルをSol 6.1、ひとつ前のGPT-6 Solを旧Solと呼び分けます。
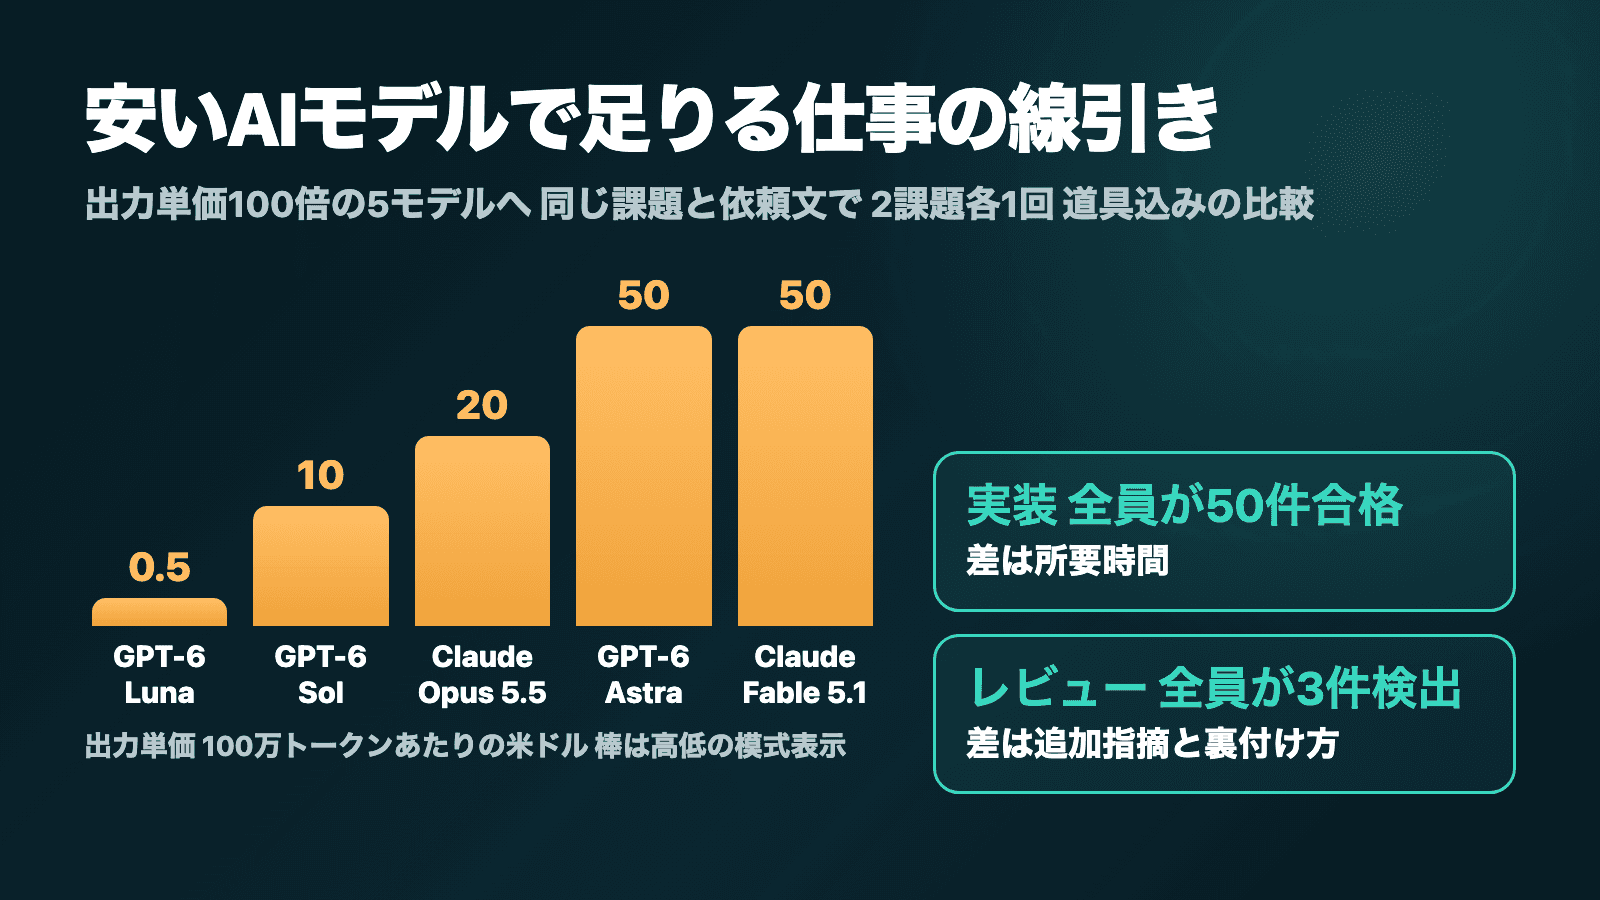
両社にはさらに高い価格のモデルもあります。OpenAIのGPT-6 AstraとAnthropicのClaude Fable 5.1です。高いモデルを選んで失敗が減るなら、その料金には意味があります。一方、同じ仕事を安いモデルが同じ合格条件で終えられるなら、毎回追加料金を払う理由は弱くなります。
比べたいのは、コードを生成する単価と、完成した仕事にかかる費用の関係です。通常料金を確認したあと、同じ第三者評価で5モデルの位置を見ます。そのうえでSol 6.1とOpusへ同じ変更を頼み、料金の差が手元の実装でも結果の差になるか確かめます。
通常単価は半額でも長い入力は差が縮む
モデルの従量料金は、外部のプログラムからAIを呼び出すAPIで使う場合の目安です。処理する文章やコードは「トークン」という単位で数えられ、読み込む入力と生成する出力にそれぞれ料金がかかります。月額契約の利用枠は別の仕組みなので、下の単価から何回使えるかは計算できません。
2026年9月30日時点の標準API料金を、100万トークン当たりの米ドルで並べました。OpenAIの値は、APIを1回呼び出すときに送る入力が27.2万トークン以下の場合です。この入力には、コードや過去のやり取り、キャッシュとして再利用する分も数えます。
| モデル | 入力 | 出力 | キャッシュ読取 |
|---|---|---|---|
| 旧GPT-6 Sol | $2 | $10 | $0.20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Astra | $10 | $50 | $1.00 |
| Claude Fable 5.1 | $10 | $50 | $0.25 |
キャッシュは、繰り返し渡すコードや指示の一部を再利用する仕組みです。Sol 6.1とOpusの読取料金は、それぞれ通常入力から95%引きです。Sol 6.1の変化は、旧Solと同じ入出力単価を保ち、キャッシュ読取をさらに半額にした点にあります。キャッシュの初回作成には別途費用がかかるので、読取単価だけで全体の費用を見積もらないようにします。
長いコードや会話履歴をまとめて渡す場合は、OpenAI側の追加料金が効いてきます。Sol 6.1は1回の入力が27.2万トークンを超えると、その呼び出し全体の入力・キャッシュ単価が2倍、出力単価が1.5倍になります。通常入力は$4、出力は$15になり、Opusの$4、$20に近づきます。Opusは入力と出力を合わせて100万トークンまで扱え、長い入力でも標準単価は変わりません。
たとえば出力を2万トークンに固定し、キャッシュを使わないとします。入力10万トークンならSol 6.1は$0.40、Opusは$0.80です。入力50万トークンでは、それぞれ$2.30、$2.40になります。同じトークン数を使う仮定の計算ですが、長い入力で「半額」の差が縮むことは確認できます。

実際には同じ文章でもモデルごとにトークン数が違い、再試行やキャッシュの使い方も変わります。作業中の入力を全部足して27.2万を超えたかを見るのではなく、1回ごとの使用量と料金を集計します。
Astraに近づいたSol 6.1とFableを上回るOpus
単価をそろえても、同じ仕事に使う量はそろいません。第三者の評価機関Artificial Analysisは、複数の課題を各モデルへ実行させ、成績と、実際に使ったトークンから計算した費用を公開しています。
2026年9月30日に確認した総合指標は、知識労働、ターミナルでの作業、資料の理解など10種類の評価を合わせたものです。表の5モデルはいずれも最大推論設定です。考える量の設定名が同じでも、計算量が同じという意味にはなりません。OpusとFableの結果は、提供側の安全対策が働くと一部の処理を別モデルへ切り替える設定を含みます。以下の第三者評価は、この切替を含む提供形態の成績として読みます。単一モデルだけの能力差とは扱いません。
| モデル | 総合指標 | 評価1課題の平均費用 |
|---|---|---|
| 旧GPT-6 Sol | 47.5 | $1.049 |
| GPT-6.1 Sol | 51.8 | $0.724 |
| GPT-6 Astra | 52.7 | $3.258 |
| Claude Opus 5.5 | 57.6 | $5.982 |
| Claude Fable 5.1 | 53.4 | $7.630 |
総合指標は正答率ではなく、複数の評価をまとめた点数です。費用は入力、キャッシュの作成・読取、推論と回答の出力を含みます。各評価の1課題当たりの費用を、その評価が総合指標に占める重みで平均した値です。特定の課題や、成功した仕事1件の価格ではありません。人が確認する時間も含まれていません。

OpusはSol 6.1より総合点が5.8高い一方、この集計での費用は約8.3倍です。通常単価の2倍という差だけでは、実際の評価費用の差を説明できません。使った量やキャッシュの条件まで確認する必要があります。
旧SolからSol 6.1への変化は、成績が上がりながら、この評価では費用も下がったことです。Astraとの差は総合点で0.9に縮みました。ただし、総合点が近くても、得意な課題がすべて同じとは限りません。
Anthropic側ではOpusがFableを総合点で上回り、費用も低くなっています。この集計を使う限り、Fableを選ぶ理由を「より高い価格のモデルだから」だけで説明するのは難しくなりました。特定の仕事でFableが勝るかどうかを、別に確かめる必要があります。
Opusの強さは資料から成果物を作る仕事に表れる
Sol 6.1とOpusの差は、課題を分けると見えやすくなります。下の表は、前節と同じArtificial Analysisによる最大設定の実測で、Opusは別モデルへの切替を含みます。
| 評価する仕事 | Sol 6.1 | Opus 5.5 |
|---|---|---|
| ターミナルでの作業(Terminal-Bench 4.0) | 56.1% | 59.6% |
| 専門PDFの設問に全項目合格(GDP.pdf) | 31.0% | 26.2% |
| 複数資料から作る成果物の採点項目へ合格(AA-Briefcase) | 55.7% | 61.2% |
ターミナルでの作業を評価するTerminal-Bench 4.0は、コマンドを実行してソフトウェアの修正やデータ処理を進める課題です。各課題のテストをすべて満たした場合に合格となり、Opusが3.5ポイント上回りました。
専門PDFを読むGDP.pdfの設問ではSol 6.1が上回りました。表、図、脚注まで読んで答えを出す課題で、すべての採点項目を満たした割合です。この値からPDFの仕事全般の優劣までは決められません。
AA-Briefcaseは、複数のファイルや業務の資料を読み、分析や文書、表などの成果物を作る課題です。表には、依頼ごとに用意された採点項目を満たした割合を載せました。仕事全体に合格した割合ではありません。この値ではOpusが5.5ポイント上回っています。
PDFの設問や資料からの成果物作成は、コードの実装とは別の仕事です。開発とともに仕様書の整理、設計メモ、調査報告まで任せたい人には、その作業でもOpusとSol 6.1を比べる根拠になります。
両社の発表資料にも同名の評価がありますが、実行環境や推論設定、PDFの渡し方が異なる場合があります。発表の最高値と別の評価機関の値を混ぜると、同じ仕事を比べた表にはならなくなります。今回の表は評価元をそろえています。
考える量を増やすと性能も費用も変わる
モデルを変える前に、推論設定も確認したいところです。Sol 6.1とOpusのAPIで既定の設定はmediumで、最大設定より考える量を抑えます。ここでもOpusは別モデルへの切替を含む評価です。Artificial Analysisの同じ集計を設定別に並べると、モデル名だけでは見えない違いが出ます。
| モデルと推論設定 | 総合指標 | 評価1課題の平均費用 |
|---|---|---|
| Sol 6.1 medium | 47.8 | $0.214 |
| Sol 6.1 max | 51.8 | $0.724 |
| Opus 5.5 medium | 51.2 | $1.336 |
| Opus 5.5 max | 57.6 | $5.982 |
Sol 6.1のmaxとOpusのmediumは、総合点が近くなります。それでもTerminal-Bench 4.0の合格率は、Sol 6.1のmaxが56.1%、Opusのmediumが52.5%です。設定と課題をそろえて見ないと、総合点だけではどちらを選ぶか決められません。
失敗した課題を考える量の設定を上げて解けるなら、別のモデルへ移る前に試す候補になります。そのときは、設定を上げた結果の合否と追加費用を記録します。月額プランの画面にある設定名とAPIの設定名は、同じものとして扱わず、実際に使った設定を残します。
同じ部分返金の実装を3回ずつ依頼した結果
公開評価だけでは、手元の小さな変更でどこまで差が出るか分かりません。筆者は、注文アプリに一部の商品だけを返品する処理を追加する課題をSol 6.1とOpusへ渡しました。
返品では、端数のある金額を複数回に分けても元の合計額を保ち、通信の再試行で二重に返金しないようにする必要があります。金額を数量で割った整数部分を各個へ配り、余りのセントは先頭から1ずつ足す規則です。たとえば3個で1001セントの商品を1個ずつ返す場合は、334、334、333セントになります。返金する数量の管理、金額の計算、エラー応答、画面へ出す文字を、複数のファイルにまたがって変更させました。
今回測ったのは、Codex+Sol 6.1とClaude Code+Opus 5.5の組み合わせです。両道具の内部指示やキャッシュの保持条件はそろえていません。換算費用は、この条件で出た使用量から計算する参考値です。
同じ初期ファイルと日本語の仕様を用意し、新しい会話で3回ずつ実行しました。Sol 6.1はCodex、OpusはClaude Codeを使いました。Codex CLIのmodel_reasoning_effortとClaude Codeのeffortを、どちらもmediumへ明示的に設定しました。
仕様には、丸め、二重処理の防止、入力を拒否した後の状態、通貨と文言の要件を書き、表示を「一部返金」とすることも指定しました。AIが見られる既存テストに加え、先に決めた40項目の確認コードを実行後に当てました。AIに渡さなかったのは、この確認コードです。
初回に40項目すべてを満たしたのは、Sol 6.1が3回中3回、Opusが3回中1回でした。Opusの残る2回も金額の計算と二重処理防止は合っていましたが、表示が指定の「一部返金」ではなく「全額返金」になっていました。この差を伝えて1回修正を頼むと、Opusの2回とも全項目に合格しました。
| 同じ課題を3回実行した結果 | Codex+Sol 6.1 | Claude Code+Opus 5.5 |
|---|---|---|
| 初回に全項目へ合格 | 3回/3回 | 1回/3回 |
| 修正を1回まで加えた後の全項目合格 | 3回/3回 | 3回/3回 |
| 道具の所要時間の中央値・修正込み | 139秒 | 101秒 |
| 道具の所要時間の最短〜最長・修正込み | 137〜151秒 | 92〜106秒 |
| 標準API単価での換算費用の中央値・修正込み | $0.094 | $0.354 |
| 出力トークンの中央値・修正込み | 3,874 | 10,190 |
この課題ではCodex+Sol 6.1の換算費用が低く、Claude Code+Opusは修正を含めても所要時間が短くなりました。費用と待ち時間の順序が一致しない結果です。Opusは出力したトークン数が多く、キャッシュ作成の費用も加わったため、通常単価の2倍という差以上に換算費用が開きました。実行時間は、道具の起動、ファイルの読取り、編集、AIが実行したテストを含みます。Opusの追加修正はそれぞれ21秒と22秒で、表では初回の時間に足しました。人による採点や確認の時間は含みません。
実験は2026年9月30日、Codex CLI 0.159.1とClaude Code 2.1.285で行いました。月額契約の利用枠で実行し、表のドル額はログにある使用量を標準API単価へ換算した値です。入力、キャッシュの作成・読取、出力と、追加の修正を含めています。Sol 6.1の各試行では入力の累積量自体が10.2万トークン未満で、どの呼び出しも27.2万の加算境界を超えませんでした。ログにはキャッシュ作成の使用量がなく、通常入力$2、キャッシュ読取$0.10、出力$10で換算しました。Opusは、1時間保持するキャッシュの作成が記録されていたため、1時間キャッシュの作成単価$8に加え、通常入力$4、読取$0.20、出力$20を使いました。いずれも100万トークン当たりの単価です。キャッシュの保持条件も両道具でそろえた実験ではありません。実際の月額請求額を比べたものではありません。
CodexとClaude Codeでは、内部の指示やファイルを扱う仕組みも違います。Opusの実行ログに記録されたモデルは全回Opus 5.5だけで、別モデルの使用は確認されませんでした。この実験は開発道具を含む結果であり、モデルだけの能力差ではありません。1種類の課題を3回試した結果なので、大規模な改修や仕様が曖昧な仕事まで同じ結果になるとは言えません。
追加料金は自分の課題の合否で決める
公開評価と手元の課題を合わせると、筆者なら、mediumで行った今回のように、仕様と受け入れ条件が決まった小さな実装ではSol 6.1から試します。1回の入力が27.2万トークン以下なら通常単価が低く、今回のCodex+Sol 6.1の組み合わせでは、初回から指定した条件を満たし、換算費用も低くなりました。モデル単体の優劣は、この結果だけでは決められません。ただし、最大設定の第三者評価では、Terminal-Bench 4.0でOpusが3.5ポイント上回っています。結果が合わない場合や、複数の資料から分析や成果物を仕上げる仕事では、Opusも同じ課題で比べます。
AstraやFableを選ぶ場面は、いま使っているモデルが満たせない条件があるときです。解けない不具合、見落とす制約、足りない分析を具体化して同じ課題を渡し、改善が追加費用に見合うかを見ます。長い入力を使う場合は、料金の加算条件も含めて選び直します。
モデルを選ぶための記録は、依頼した仕事、合格条件、初回と修正後の結果、使った費用、確認にかかった時間です。コードが動いても表示する金額や文言を間違える場合があり、反対に大きな総合点の差が小さな実装では現れない場合もあります。自分が繰り返す仕事で一度この記録を取れば、追加料金を払う理由を具体的に判断できます。
参照リンク18件
- OpenAIGPT-6.1 Solの発表と比較条件
- OpenAI標準API料金と長い入力の追加料金
- OpenAIGPT-6.1 Solの仕様と推論設定
- OpenAI旧GPT-6 Solの仕様
- OpenAIGPT-6 Astraの仕様
- AnthropicClaude Opus 5.5の仕様と料金
- AnthropicClaude Fable 5.1の仕様と料金
- Anthropic長い入力とキャッシュ作成の料金
- Artificial AnalysisGPT-6.1 Solの最大設定の実測
- Artificial AnalysisOpus 5.5の最大設定と別モデルへの切替を含む実測
- Artificial Analysis旧GPT-6 Solの最大設定の実測
- Artificial AnalysisGPT-6 Astraの最大設定の実測
- Artificial AnalysisFable 5.1の最大設定と別モデルへの切替を含む実測
- Artificial Analysis総合指標v4.3.2の課題と採点方法
- Artificial AnalysisGPT-6.1 Solのmedium設定の実測
- Artificial AnalysisOpus 5.5のmedium設定の実測
- AnthropicClaude Codeのモデル指定と推論設定
- AnthropicOpusの評価で安全対策が働いたときの別モデルへの切替
2026年9月30日時点の公式資料を確認しています。仕様は更新される可能性があります。