汎用AIエージェントは、モデルの外側にある文脈、スキル、道具接続、実行環境を仕事ごとに組み替えて作ります。各要素の役割をたどり、汎用基盤へ能力を足すか、専用システムを作るかの判断を整理します。
汎用性は能力の組み替えから生まれる
AIエージェントの定義、任せられる仕事の型、費用の見方は、入口の記事「AIエージェントとは」にあります。この記事が扱うのは、入口の記事で示した一業務を社内の複数業務へ広げるときに、能力をどう分けて組み替えるかです。どこまでをモデルの判断へ渡すかという境界は「AIが状況を見て次の行動を選ぶ」で扱っています。
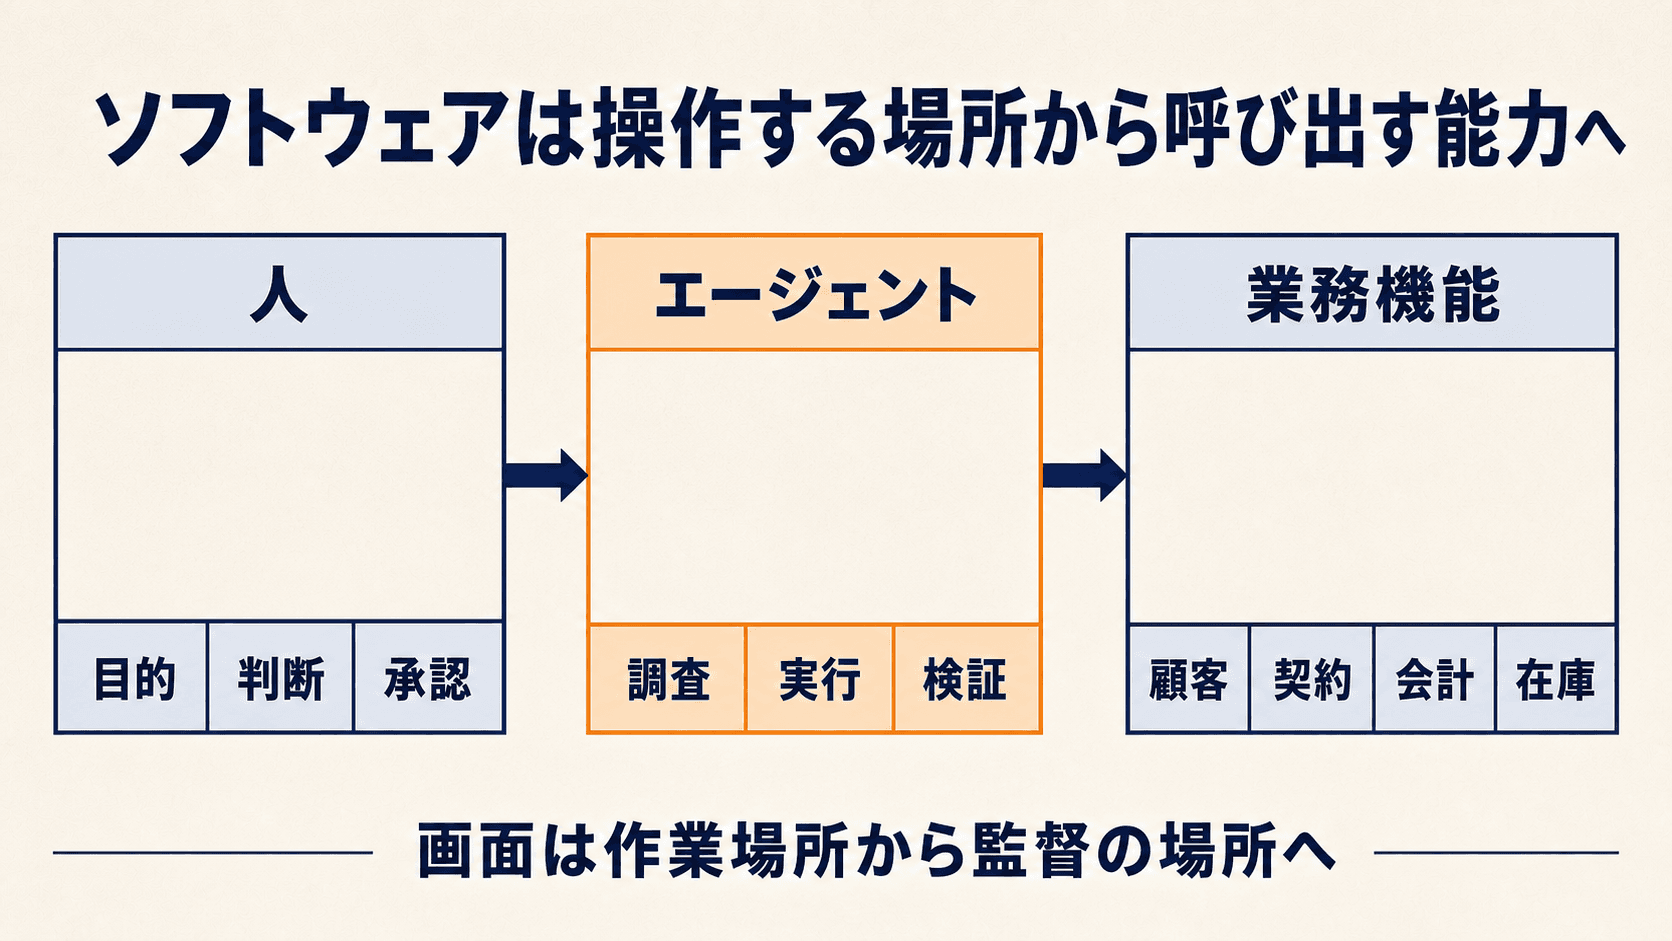
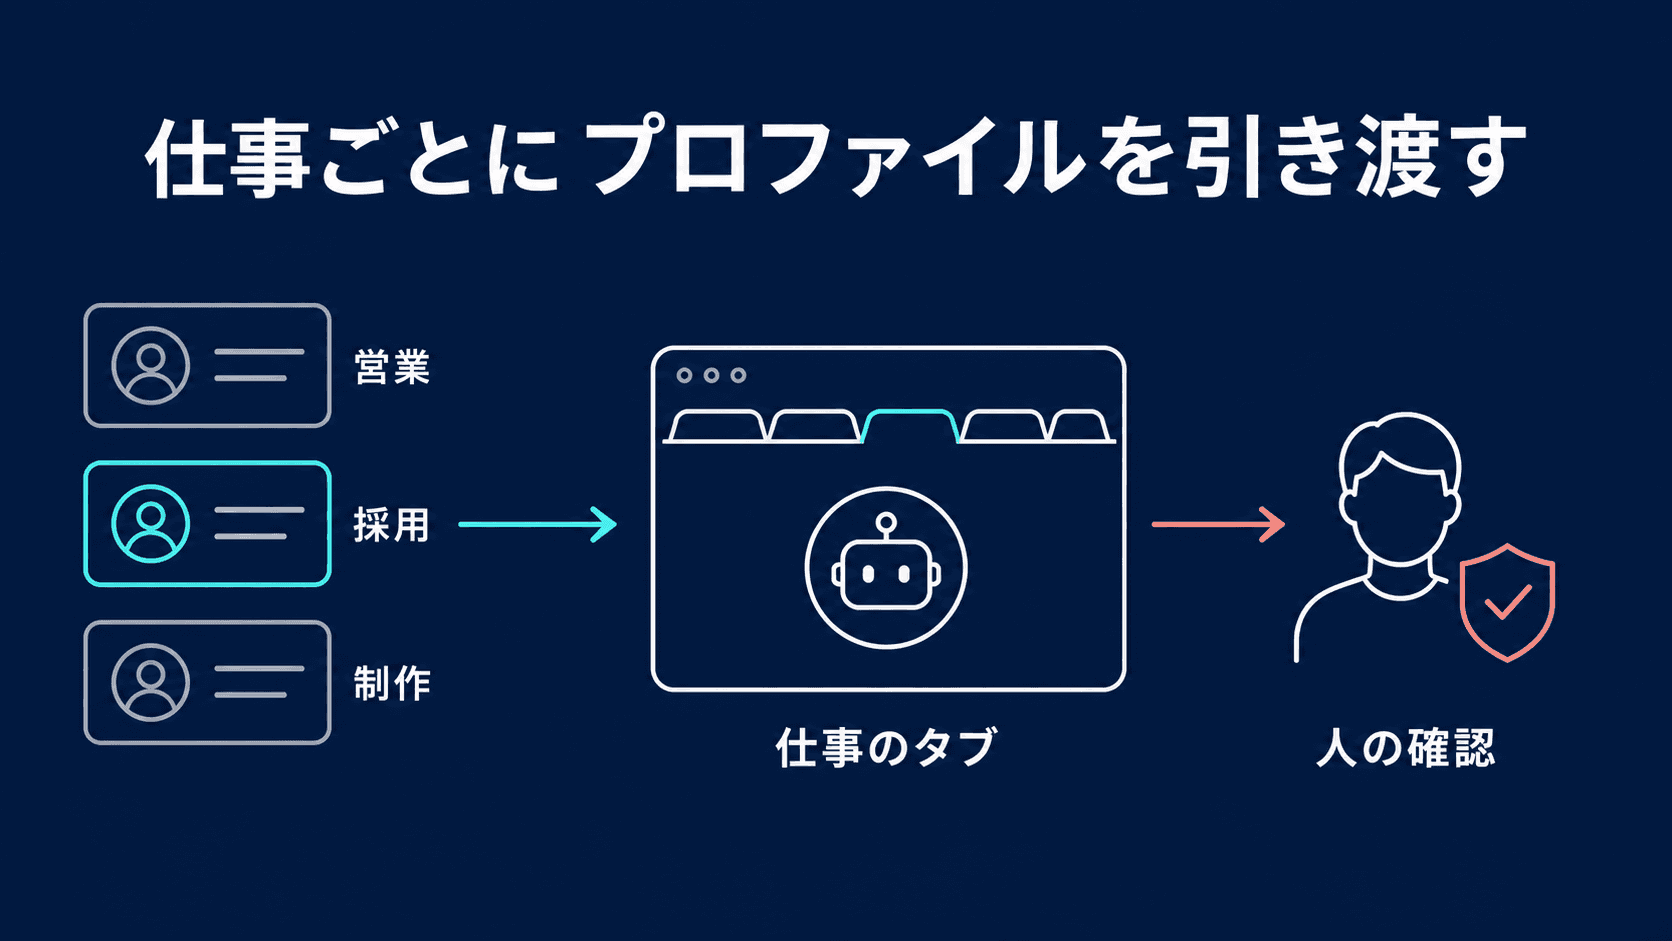
汎用性は、能力を仕事ごとに組み替えられることから生まれます。同じエージェントでも、一次情報を調べて記事の根拠を残すスキルとWeb検索を渡せば調査役になり、リポジトリの規約、シェル、テスト、Gitを渡せば開発役になります。中心にあるモデルは一つでも、読める文脈、使える手順、操作できる対象が変わるため、別の仕事へ移れるわけです。
つまりここでいう汎用性は、最初からすべてを内蔵することではなく、必要な能力だけを後から装着できることを指します。2026年8月時点のCodexとClaude Codeはいずれも、スキル、MCP、フックやサブエージェントなどを役割ごとに分けて拡張する構成を公式に説明しています。124
能力を分けて組み替える
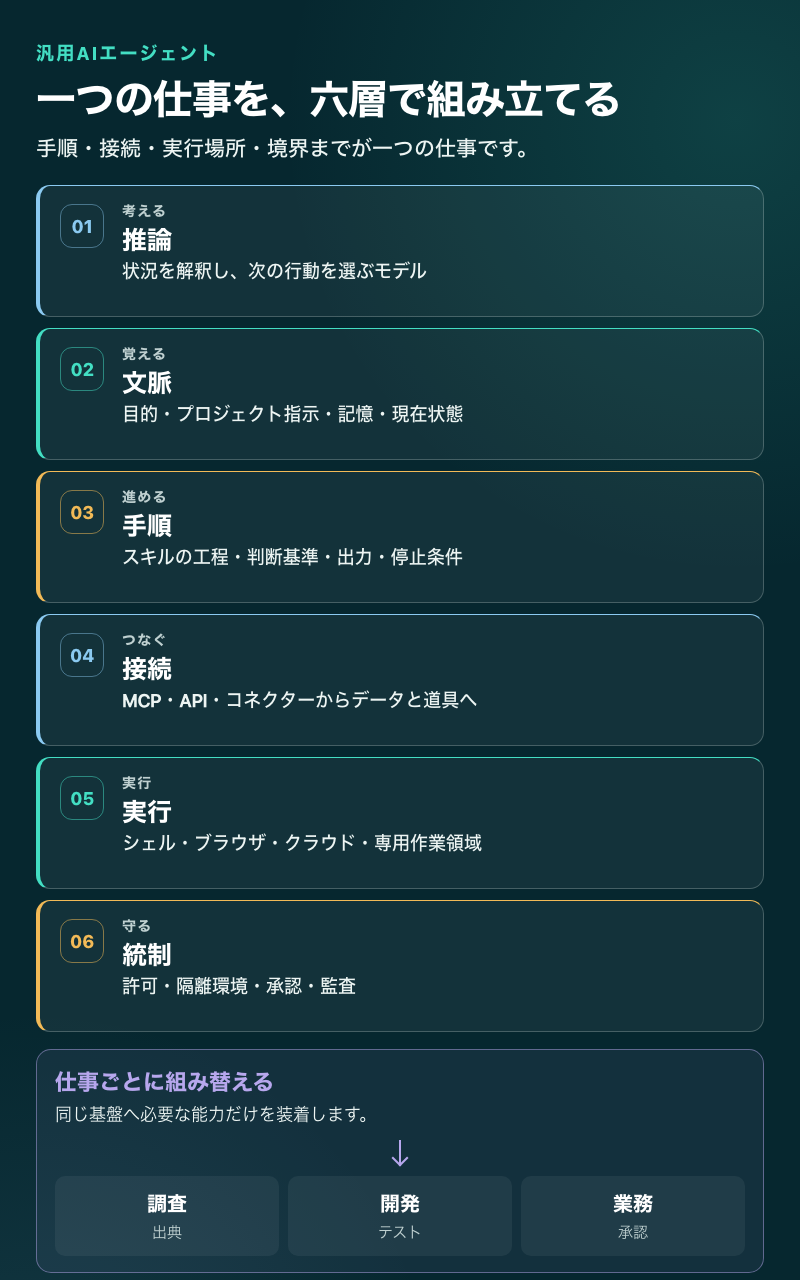
汎用エージェントをチャット画面だけで捉えると、なぜ仕事によって得意不得意が変わるのか説明できません。実体は、推論、文脈、手順、接続、実行、統制という六つの層です。
モデルは状況を解釈して次の行動を選びます。プロジェクト指示と記憶は、今回の目的や制約を保ちます。スキルは再利用できる作業手順、MCPやコネクターは外部のデータと操作への接続、シェル・ブラウザ・クラウド環境は実際の処理場所です。隔離環境、許可、承認、監査は、どこまで任せるかを決めます。
どれか一層だけを増やしても、実務能力にはなりません。MCPを接続しても正しい順序や品質基準は増えず、スキルだけでは外部システムを操作できません。実行能力を広げても統制がなければ、できることと事故の到達範囲が同時に増えます。六層が一つの仕事としてつながって初めて、汎用性が役に立ちます。
スキル・MCP・プラグインを混同しない
スキルは仕事の進め方です。OpenAIの現行資料では、指示、参照資料、任意のスクリプトを一つのディレクトリへまとめ、必要になったときだけ詳しい内容を読む仕組みです。記事校正なら、入力、確認順、品質基準、成果物、停止条件をスキルへ置けます。1
MCPは、エージェントと外部の道具や文脈を結ぶ共通仕様です。どんな道具があり、どの引数で呼び、何が返るかを共通形式で見せます。MCPサーバーを追加することは、道具を増やすことであって、その道具をいつ、どの基準で使うかを教えることではありません。2
プラグインは配布単位です。現行のOpenAI資料では、再利用可能なスキルとコネクターをまとめ、ChatGPTとCodexへ配布するために使います。つまり、スキルは手順、MCPは接続、プラグインは能力のパッケージです。3
| 要素 | 主な役割 | 単独では持たないもの |
|---|---|---|
| スキル | 工程・判断基準・成果物 | 外部システムへの接続 |
| MCP/コネクター | データと道具への接続 | 業務の進め方 |
| プラグイン | スキルや接続の配布・導入 | 実行境界そのもの |
接続を仕事へ変える手順
CRMを読める道具を接続しても、「失注しそうな商談を見つけてください」という仕事はまだ曖昧です。対象期間、失注兆候、売上の基準時点、重複の扱い、根拠の残し方、誰へ見せるかを決める必要があります。接続は名詞と動詞を増やしますが、業務の意味までは決めません。
実用的なスキルは、正常系だけでなく例外を書きます。情報が矛盾したら質問する、対象が多すぎたら上位10件で止める、出典がない主張は成果物へ入れない、外部送信は確認へ戻す、といった停止条件です。さらに、完成を検査できる出力形式やテストを用意します。
そのうえで、必要なコマンド、ブラウザ、依存関係、作業環境、ネットワークを固定し、仕事ごとに入力と成果物を分けて、実行環境が同じ手順を再現できる状態にします。モデルへ詳細な指示を一度渡すだけではなく、再実行できる手順と環境へ落とすことが、汎用能力を仕事に変える工程です。5
同じ依頼を各層へ割り当てる
「失注しそうな商談を毎週見つけ、担当者へ確認案を出す」という同じ例を、六つの層へ分解してみます。モデルへ依頼文だけを渡すと、失注の意味も、どの時点の売上を使うかも、担当者へ何を返すかも決まりません。各層が一つずつ曖昧さを減らします。
| 層 | この仕事で固定するもの | 欠けたときの失敗 |
|---|---|---|
| 推論 | 複数の兆候から要確認の商談を選ぶ | 単純条件で拾えない例を落とす |
| 文脈 | 対象期間、営業段階、失注定義、除外顧客 | 古い商談や対象外地域を混ぜる |
| 手順 | 取得、重複除去、根拠確認、順位付け、出力 | 担当者ごとに結果が変わる |
| 接続 | CRMの商談、活動履歴、担当者を読む道具 | 必要な事実へ到達できない |
| 実行 | 定期起動、作業領域、結果ファイル、通知 | 途中結果を失い再現できない |
| 統制 | 読み取り専用、対象件数上限、送信前確認 | 誤更新や過剰な通知へ広がる |
最初に自動化するのは、CRMを読み、根拠付きの候補表を作るところだけです。人が「この兆候は失注ではない」と直したら、単なる会話の訂正で終わらせず、除外条件か評価例へ戻します。精度が安定してから定期実行を加え、担当者への送信はさらに別の承認付き能力として足します。
ここで専用化されるのは、巨大な新モデルではなく、対象データ、失注兆候、出力形式、評価例、権限という設定です。別の部署へ転用するときは、共有できる実行と統制の層を残し、業務の意味を持つ文脈と手順を入れ替えます。この一連の設定変更が、「汎用基盤から専用エージェントを作る」という言葉の具体的な中身です。
専用エージェントを設定として作れる
以前は業務ごとにエージェントの実行循環、道具の呼び出し、状態、エラー処理、記録をコードで組み立てることが一般的でした。製品へ組み込む場合は今も重要で、OpenAI Agents SDKもエージェント、道具、仕事の引き継ぎ、保護規則、実行状態、実行追跡などを部品として提供しています。6
一方、個人や小さなチームの内部業務では、汎用基盤へプロジェクト指示、スキル、コネクター、許可範囲を追加するだけで、記事調査、請求書確認、リポジトリ保守などの専用エージェントを作れる場面が増えました。専用化の一部がアプリケーションのコードから設定と業務手順へ移っています。
モデルに加えて、認証、道具一覧、隔離環境、成果物の扱い、承認、通知という運用の土台も再利用の対象です。仕事を増やすたびに新しいボットを一から運用するより、一つの基盤へ境界付きの能力を足す方が小さく始められます。
汎用基盤と専用システムの選び方
汎用基盤と専用システムは、仕事の性質で使い分けるのが基本です。曖昧な依頼を人と調整し、複数の道具を横断し、成果物を確認へ出す内部業務は汎用基盤へスキルを足す方法に向き、試行しながら工程を固める段階にも適しています。
顧客向け製品へ組み込む、多数の利用者を厳密に分離する、応答時間と費用を保証する、同じ入力へ一定の挙動を返す、法規制に沿った評価を継続する場合に向くのは、コードで境界を固定した専用システムです。汎用エージェントがその専用システムを道具として呼ぶ構成も可能です。
| 観点 | 汎用基盤+スキル | 専用システム |
|---|---|---|
| 依頼 | 曖昧で対話的 | 入出力を固定できる |
| 利用者 | 個人・小チームの内部 | 多数の顧客・利用者組織 |
| 運用 | 工程を試しながら改善 | 応答時間・費用・サービス水準目標を管理 |
| 失敗 | 確認で止められる | コードで例外処理を保証 |
判断基準になるのは、誰が使うか、失敗の影響はどこまでか、入出力は固定できるか、処理量を予測できるか、継続評価が必要かという点で、枠組みの好みとは切り離して考えます。最初は汎用基盤で工程を学び、安定した部分だけ専用サービスへ切り出す進め方も現実的です。
汎用基盤を使い続けない条件
能力を後付けできることには裏面があります。スキルが増えると、似た名前の手順が同時に候補になり、どれを使ったかで結果が変わります。接続先を増やすと、同じ認証情報が読める範囲も広がりやすくなります。すべての仕事の規則を共通文脈へ入れると、関係のない制約が競合し、原因を追いにくくなります。
次の条件が揃った工程は、汎用基盤の自由な判断からコードで固定したサービスへ切り出す候補です。
- 入力と出力の形式が安定し、例外を列挙できる
- 同じ工程が大量に動き、応答時間と単価を管理する必要がある
- 誤りの影響が大きく、毎回同じ検査と権限境界を通したい
- 複数のスキルが競合し、どの手順を使うべきか事前に決められる
- 特定モデルの判断を使わずに検証、計算、変換できる
反対に、依頼の意味を人と調整し、参照先が毎回変わり、途中の観測で手順を組み替える仕事は、汎用基盤へ残す価値があります。実務では、探索と例外発見を汎用エージェントへ残し、認証、計算、更新、公開を専用サービスへ渡すという分担が扱いやすく、全体をどちらか一方へ寄せる必要はありません。
切り出しの合図になるのは、エージェントの失敗回数よりも、人が直す場所が毎回同じ、道具の呼び出し列がほぼ一定、待ち時間の多くが自由な推論ではなく固定処理、という実行記録が揃ったときです。汎用性は、工程を学ぶための余白として使い、保持すること自体を目的にしません。
能力の棚卸しから始める
実装の最初は、モデル選びで終わらせず、一件の仕事について、必要な文脈、再利用したい手順、読むデータ、実行する道具、動かす環境、止める境界を六列で書き出します。いま人が画面間で転記している箇所は、接続や道具が不足している候補です。担当者ごとに結果がぶれる箇所は、スキルの判断基準が不足している候補です。
次に、読み取り専用で成果物を作る小さな仕事を実行し、入力、参照元、道具の呼び出し、出力、失敗理由を記録します。完成条件をテストできる形へ直し、外部へ影響する操作は別仕事と承認へ分けます。能力を増やすのは、一件を再現できる形になってからです。
汎用AIエージェントの価値は、同じ運用基盤を保ちながら、仕事ごとに必要な能力だけを理解可能な形で組み替えられることです。何ができるかを増やすほど、どの層がその能力を与え、どの境界が止めるかを説明できる設計が重要になります。
参照リンク6件
- OpenAIBuild skills — reusable workflows for ChatGPT and Codex
- OpenAIModel Context Protocol — tools and context for Codex
- OpenAIPlugins — skills, connectors, MCP servers and hooks
- AnthropicExtend Claude Code — Skills, MCP, hooks and subagents
- OpenAICodex non-interactive mode
- OpenAIOpenAI Agents SDK — loops, tools, guardrails and tracing
2026年8月20日時点の公式資料を確認しています。仕様は更新される可能性があります。