エージェンティックとは、外部の結果を観測し、次の行動をモデルが選び直す実行構造です。推論の長さではなく観測後の分岐を誰が決めるかを軸に、ツール呼び出し、ワークフロー、長期実行、サブエージェントとの違いを説明します。
推論と行動を分ける
AIエージェントの定義、任せられる仕事の型、導入時に確認する条件は、入口の記事「AIエージェントとは」にまとめています。この記事が扱うのは、その先にある一点だけです。どの観測の後に、どこまでの判断をモデルへ渡すのか。汎用基盤へスキルや接続を足して社内業務へ広げる側の設計は「AIエージェントに社内業務を任せる」にあります。
まず、長く考えることと、外部へ働きかけて次の行動を変えることを分けます。難しい問題を長く考えて一つの答えを返すモデルは、高度な推論ができます。しかし外部へ働きかけず、途中結果を観測して次の行動を変えないなら、実行構造は「入力→モデル→出力」の一回で終わります。見るべきなのは、外部の結果がモデルへ戻り、次の選択を変えるかです。
OpenAIの現行資料は推論モデルを、回答の前に内部の推論用トークンを使い、選択肢の検討や曖昧さからの復旧を行うモデルとして説明しています。1 これは答えを作る内部計算です。
一方、エージェントで問題になるのは、検索する、ファイルを読む、コマンドを実行する、失敗を受けて別の手段を選ぶ、といった外部との相互作用です。推論能力とエージェンティックな実行は別の軸で、強い推論は計画や復旧の質を上げますが、推論時間だけではエージェントかどうかを判定できません。
ツール呼び出しは入口にすぎない
ツール呼び出しでは、アプリケーションが利用可能な関数と引数の形をモデルへ渡します。モデルが呼び出しを提案し、アプリ側が実行し、結果をモデルへ返します。2
天気APIを一回呼んで文章に直す処理にも、モデルが道具を選ぶという小さな委任があります。ただし、道具が一つで常に一回だけ動き、失敗時の分岐もコードで固定されているなら、エージェンティックさは限定的です。
道具の数や呼び出し回数ではなく、途中結果ごとに新しいモデル判断が必要かが境界になります。OpenAIの2026年8月時点のモデル利用指針も、予測可能な絞り込み、結合、順位付け、集計はプログラムによるツール呼び出しでまとめ、各結果によって次の判断が変わる処理や承認が必要な操作は直接道具の呼び出しへ残すよう案内しています。3
複数道具をコードで束ねても、それだけでは適応的なエージェントの実行循環になりません。検索結果が不十分なら検索語を変え、テストの失敗を見て別のファイルを直し、画面の変化から次の操作を選ぶ、といった動きが該当します。ツール呼び出しが観測、選択、行動の循環へ組み込まれたとき、エージェントの実行循環になります。
最小のエージェントは閉ループで動く
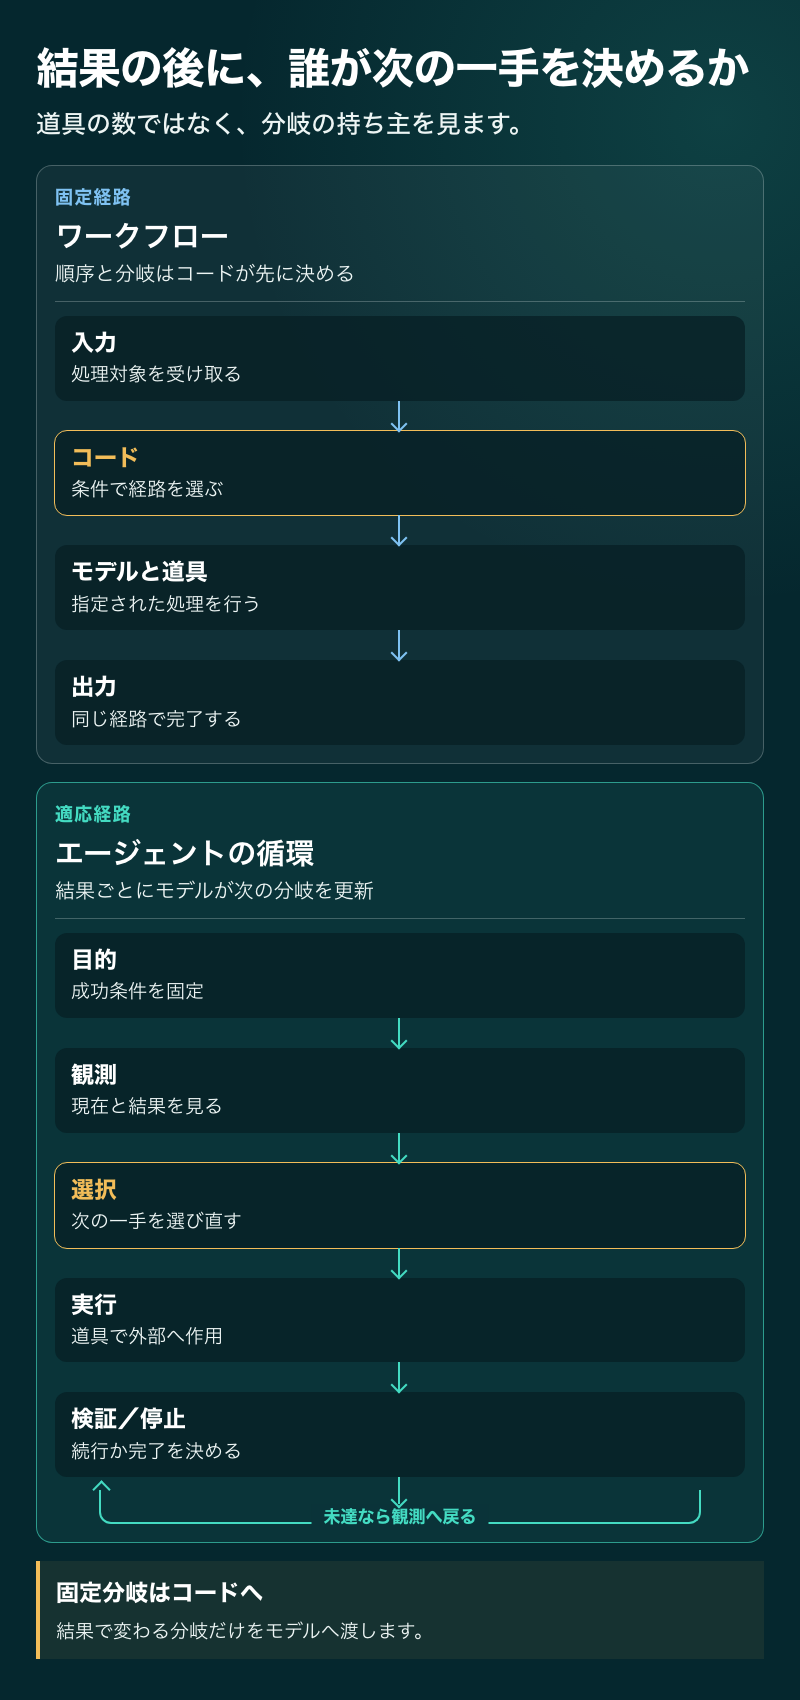
計画し、行動し、結果を観測し、調整する自己指向のループが、単発の対話AIとの実務上の差です。4 最小構成は六つの要素に分けられます。
- 目的:達成したい状態と成功条件
- 観測:現在の状態と直前の結果
- 選択:許可された行動から次の一手を選ぶ
- 実行:道具や外部環境へ働きかける
- 検証:結果が成功条件を満たすか調べる
- 停止:完了、中止、承認待ちを決める
成功条件がなければ、エージェントはいつ終わるべきか判断できません。計画には、最初に長い手順書を作ることだけでなく、現在の情報から次の一手を仮決めし、実行結果に応じて更新する動きも含まれます。
現実の環境では、最初の計画を守る能力より、予想外の結果を取り込み、目標を保ったまま手段を変える能力が重要です。
ワークフローとの違いは分岐の持ち主
Anthropicは、LLMと道具があらかじめ決めたコード経路で動くものをワークフロー、モデルが自ら処理と道具利用を方向付けるものをエージェントとして区別しています。5 下書き、校正、翻訳の三段階を常に通るなら、各段にLLMがいても分岐の持ち主はコードです。
この区別に優劣はありません。決定論的なワークフローは、同じ入力を同じ検査順序へ通しやすく、費用、遅延、権限、障害箇所を予測しやすい仕組みです。エージェントは必要な工程を事前に列挙できない仕事に強い一方、探索のばらつき、累積誤差、停止しない危険を持ちます。
実務では、分岐の性質に応じて担当を分けるのが基本です。
| 判断の種類 | 担当 | 向いている処理 |
|---|---|---|
| 決定論 | コード/規則 | 認証、検証、計算、公開、削除、監査 |
| 適応的判断 | モデル | 探索、分類、仮説、文章化、例外発見 |
| 責任判断 | 人 | 対外発信、重大な副作用、曖昧な意図 |
決定論的な処理とモデル判断は、一つのグラフへ混在させられます。8 認証、入力検証、金額計算、公開、削除、監査記録はコードで固定し、情報探索、分類、仮説形成、例外発見をモデル判断へ渡し、重大な副作用は人へ戻します。
分岐を増やすほど累積誤差も増える
一つ一つの判断が十分に良く見えても、依存する判断を長く直列につなぐと、一件を最後まで正しく終える確率が下がっていくのが累積誤差の問題です。単純化した思考実験として、十個の必須判断がそれぞれ95%の確率で正しく、誤りが独立なら、すべて正しい確率は0.95の10乗で約60%です。実際の失敗は独立ではなく、最初の誤りが後段へ伝わるため、この計算を性能予測には使えません。ただし「各ターンがかなり正しい」ことと「長い仕事が安定して完了する」ことが別だと分かります。
モデルを強くする以外にも対策はあります。決定論的に計算できる工程をコードへ戻す、途中で成立条件を検査する、誤った前提を後段へ持ち越さない、探索回数に上限を置く、元へ戻せない操作の前で人へ確認する、という形で自由な分岐の距離を短くします。
たとえば出張手配なら、候補探索と旅程案の作成はモデルへ任せたうえで、予算計算、旅程の重複検査、社内規程、予約直前の便名と金額の照合をコードで固定し、購入は人へ戻します。探索の自由度を残したまま、一つの誤判断が決済まで通り抜ける経路を切る構成です。
エージェンティックさを上げる設計は、モデルへ判断を足す設計でもあります。価値があるのは、事前に列挙できない分岐へ適応が必要で、途中結果を検査できる場合です。分岐を固定できる仕事では、閉ループを増やすよりワークフローへ戻す方が、品質と費用を同時に改善できます。
長期実行に必要な運用
一分で終わる処理でも、観測から数回再計画すればエージェンティックです。反対に、毎晩同じ順番で百件を処理する一括処理は、十時間動いても決定論的です。長時間実行は自律性ではなく、永続化と運用の問題を追加します。
長期実行には、処理が落ちても再開できる再開地点、同じ副作用を二重実行しない冪等性、期限、費用、最大ターン数、承認待ちからの再開が必要です。冪等性とは、同じ処理をやり直しても外部の結果が二重にならない性質を指します。
OpenAIのバックグラウンド実行は、長い処理を接続から切り離して非同期に実行し、状態を後から確認する仕組みです。6 長期実行の土台にはなりますが、それ自体が再計画能力を与えるわけではありません。
記憶の設計では、保存量よりも再開に使える中身を優先します。残すのは、目標、確認済みの事実、未解決点、実行済みの副作用です。会話全文だけを延々と保持すると、誤情報や外部からの命令まで長く残り得ます。LangGraphの現行文書も、長期実行を再開地点、永続化、人による確認、障害復旧の問題として扱っています。7
同じ調査を実行構造で比べる
「ある制度の変更点を公式資料から調べ、旧版と比較する」という同じ仕事でも、実行構造は三通りあります。単発生成では、利用者が資料を渡し、モデルが差分を一度でまとめます。資料が揃い、比較項目が固定されているなら、最小の費用で済みます。資料不足へ自分で対処はしません。
固定ワークフローでは、公式サイトを検索し、最新版を取得し、旧版と比較し、出典形式を検査する順序をコードで決めます。検索結果が空なら検索語を一つ変える、二件以上なら発行日が新しいものを選ぶ、といった分岐も列挙できます。対象サイトと文書形式が安定していれば、この方式の方が再現しやすくなります。
エージェントの閉ループでは、検索結果が告知ページしか示さないときに添付PDFを探す、文書内の参照規程をたどる、旧版が見つからなければ文書番号から保管場所を探す、といった次の一手を観測後に選びます。事前にすべての経路を書けないときに価値があります。一方、探索先が増えるほど、非公式資料を公式版と誤認する経路も増えます。
比較実験で測るのは、完成率だけでなく、誤った版を使った回数、道具の呼び出し、時間、費用、人への質問です。同じ資料不足の例を三方式へ渡し、単発で十分な例には閉ループを使わず、固定ワークフローが繰り返し止まる例だけを適応的な分岐へ移します。エージェントを選ぶ根拠は、実演の柔軟さではなく、固定経路で解けなかった例を安全に回収できるかです。
サブエージェントが効く仕事
複数のエージェントを並べても、自動的に高度にはなりません。互いに依存しない調査を並列化する、専門的な文脈を隔離する、作成役と評価役を分ける、といった測定可能な目的があるときに意味があります。
OpenAIの現行モデル利用指針は、複数エージェントを、独立した作業単位へきれいに分割できる複雑な仕事で所要時間を減らす試験提供機能として説明しています。3 重要なのはエージェントの人数ではなく、結果を独立に検証でき、統合方法を先に定義できることです。
同じ曖昧な目標を複数エージェントへ渡し、別のエージェントが何となく統合すると、誤りの出所と責任境界が見えにくくなります。エージェント間の会話が増えれば、コストだけでなく、誤った前提が伝播する経路も増えます。
サブエージェントを使う前に、次を確認します。
- 仕事を互いに独立した単位へ分けられるか
- 異なる道具、権限、専門文脈が必要か
- 各出力を客観的に検査できるか
- 統合形式と失敗時の扱いを先に決められるか
どれにも当てはまらなければ、一つのエージェントと決定論的な工程の方が扱いやすくなります。
委任する分岐の量を設計する
エージェンティックさは、単発生成、単発道具、閉ループ、長期実行、動的委任という連続した段階で見られます。この段階分けは製品ランキングではなく、次の一手を誰が決めるかを測る設計上の尺度です。
| 段階 | モデルへ委ねる分岐 | 実行構造 |
|---|---|---|
| 0 単発生成 | 答えの生成だけ | 入力 → モデル → 出力 |
| 1 単発道具 | 一つの外部操作 | モデル → 道具 → 回答 |
| 2 閉ループ | 結果を見た次の一手 | 観測 → 実行 → 再計画 |
| 3 長期実行 | 障害や待ち時間をまたぐ判断 | 観測と実行の循環+永続状態 |
| 4 動的委任 | 工程やサブエージェントの追加 | 観測と実行の循環+委任 |
段階が高いほど良いわけではありません。目標が固定でき、失敗の影響が大きいほど、低い段階へ戻してコードで流れを決める価値が上がります。必要な手順が事前に分からず、環境を調べながら進め、結果を検証できる仕事では閉ループの価値が高くなります。
導入時は、次の順で試せます。
- 成功条件を定義する
- 結果で変わる分岐だけをモデルへ渡す
- 道具回数、ターン数、費用、時間の上限を置く
- 外部への副作用を承認地点で止める
- 同じ仕事を単発、ワークフロー、エージェントの実行循環で比較する
エージェンティックな設計の中心は、次の一手を決める権限を、どの観測の後に、どの範囲までモデルへ渡すかです。成功条件、権限、停止条件を先に決め、適応が必要な分岐だけを閉ループへ入れることで、ワークフローとエージェントを目的に応じて使い分けられます。