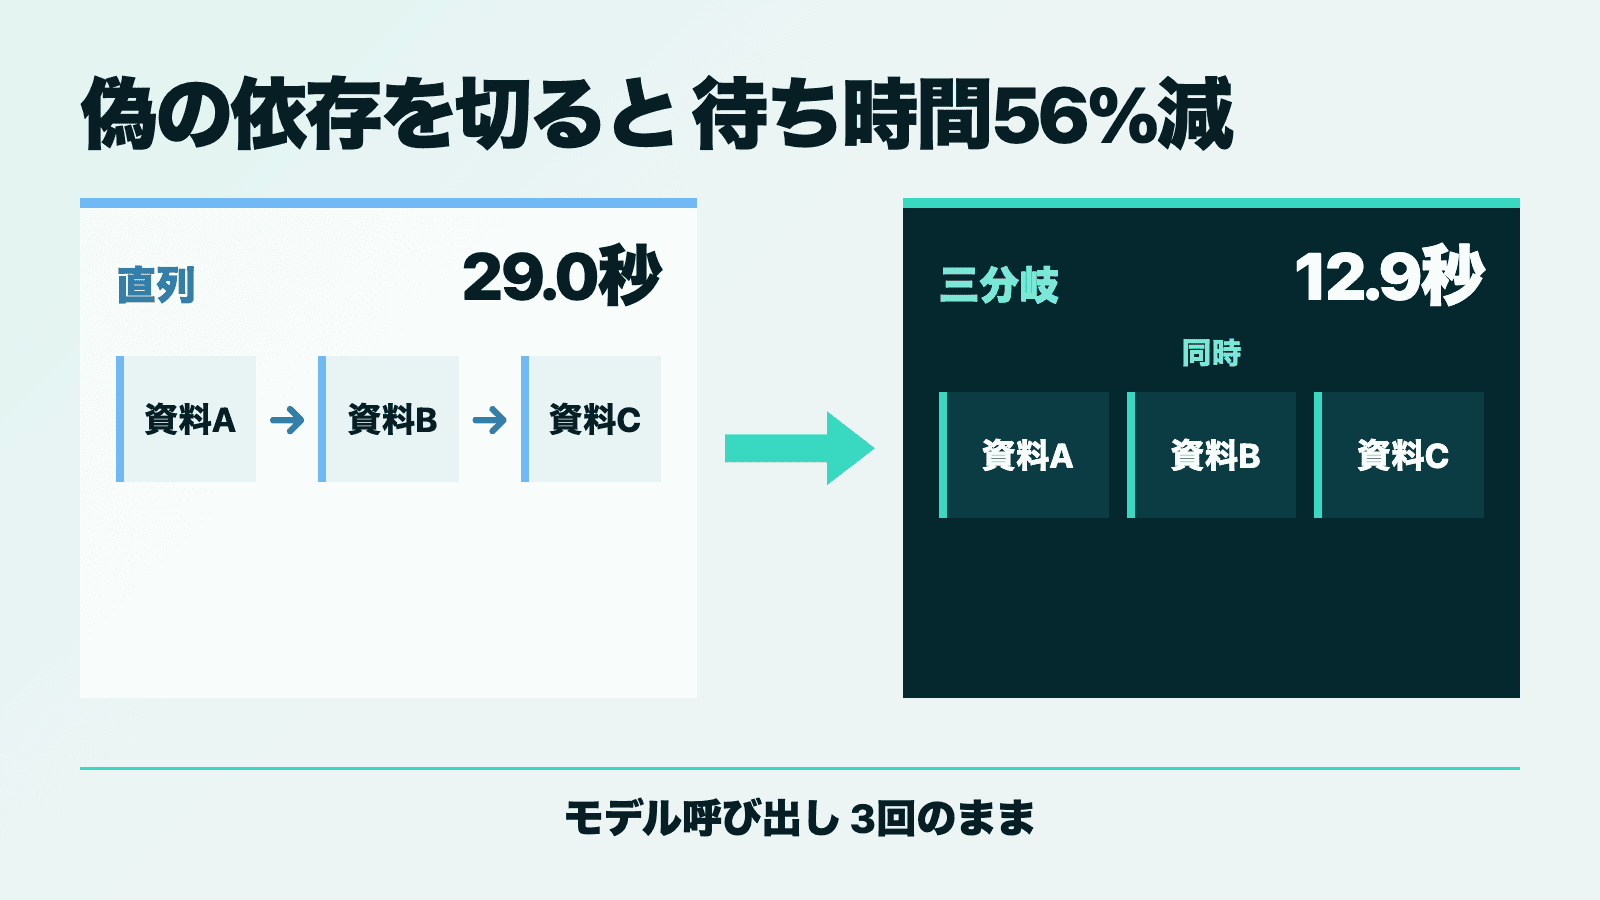
グラフエンジニアリングは、一つのAIへ詰め込んでいた複数の仕事を、依存関係、受け渡す状態、分岐と再開条件を持つ実行図へ分ける設計です。ハーネスが一つのAIに道具と実行環境を与え、ループが観測と修正の反復を設計するのに対し、グラフは複数のループ、通常のコード、人の承認をどうつなぐかを扱います。三つの資料抽出を直列と三分岐で比べた実測と局所復旧から、グラフが効く条件を確かめます。
一つのAIループの成功が次の課題を生んだ
AIエージェントは、質問へ一回答えるだけのAIから、目的を受け取り、道具を使い、結果を確かめながら完了まで進む実行役へ変わりました。たとえば製品発表の記事なら、公式文書を探し、公開リポジトリを読み、競合料金を確認し、下書きを作り、検査結果に応じて直すところまで、一つのAIへまとめて任せられます。
この便利さを支えるのが、AIに見せる情報、使わせる道具、保存する記憶、操作権限、実行結果を返す仕組みです。AIは「検索する」「ファイルを読む」「テストを実行する」と判断し、観測した結果を次の判断へ入れて反復します。関連する情報が一つの会話に収まり、前の判断を次の工程でも使う仕事なら、この一つのループが最も素直です。
同じループへ独立した仕事を足すと、AIは調査員であると同時に、進行役、記録係、検査役まで兼ねることになります。公式文書の確認、公開リポジトリの調査、競合料金の確認は、最後にまとめる必要はあっても、三件を順番に待つ理由はありません。それでも一本の会話では実行が直列になりやすく、生データ、途中の仮説、失敗した検索、採用しなかった案が同じ履歴へ積み上がります。
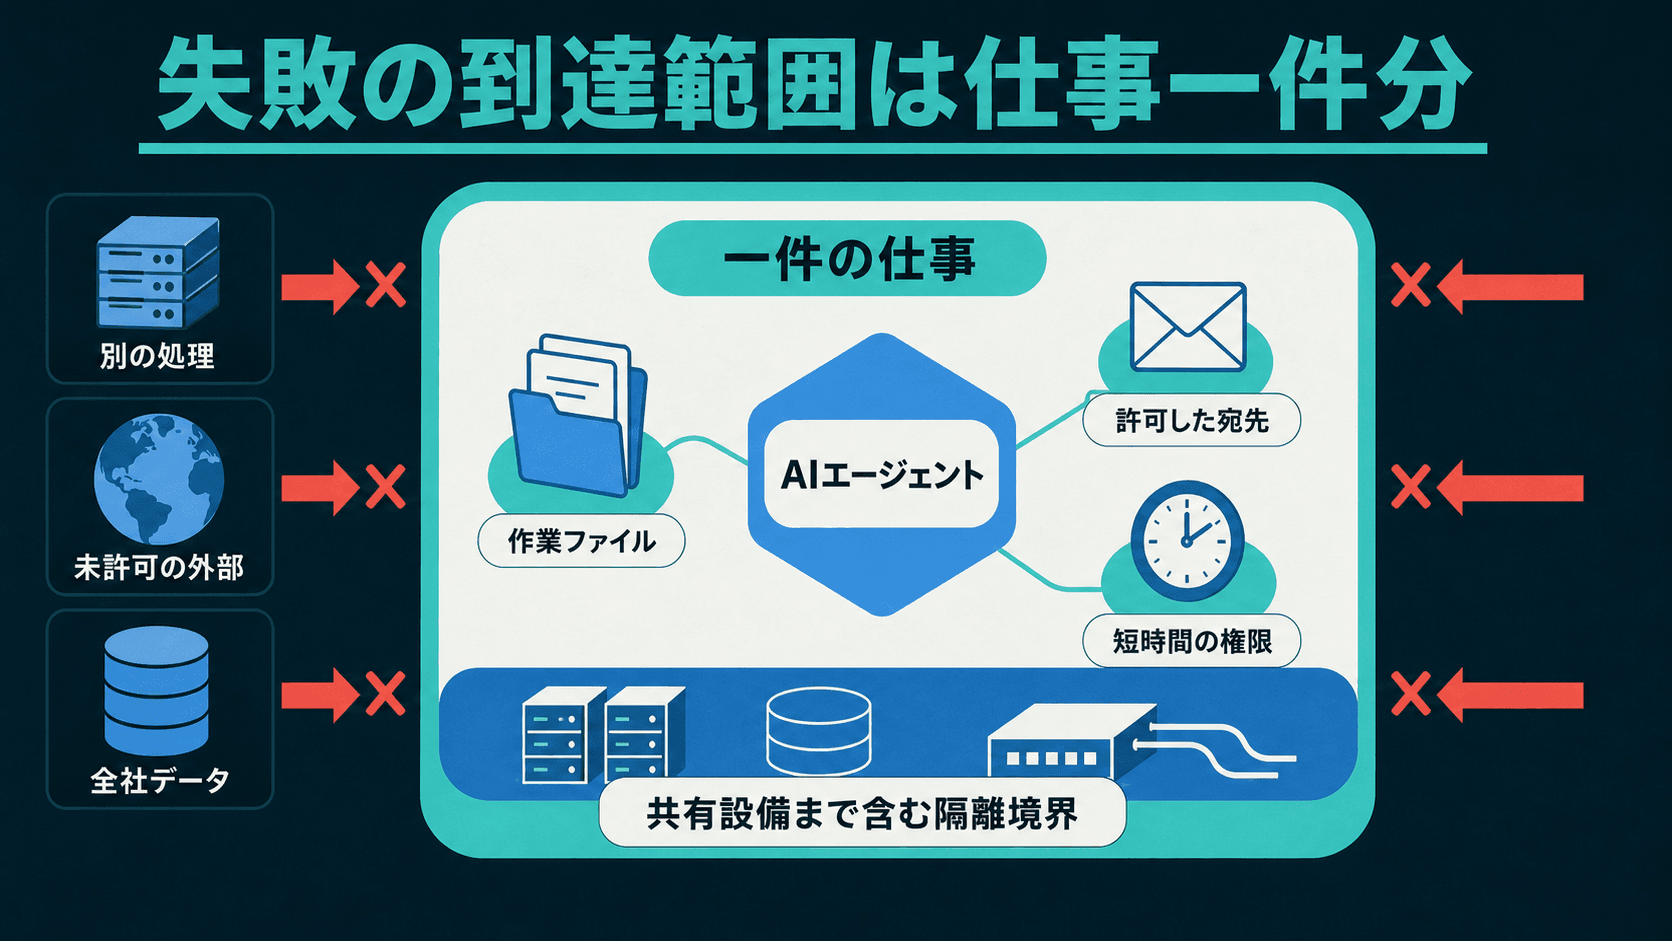
仕事が長くなるほど、速さ以外の問題も出ます。料金調査だけ失敗しても全体を最初からやり直し、下書きを作ったAIが自分で合格を出し、公開権限を持つ同じループがそのまま外部へ変更を加える設計では、失敗範囲と責任の境界が曖昧です。AIを賢くしたり、会話へ情報を追加したりするだけでは、この調整問題は解けません。
そこで、前工程の出力を本当に読む仕事だけを線でつなぎ、独立作業は分け、下流へ渡すデータ、失敗時の戻り先、人が止める地点を明示します。この実行地図がグラフです。目的はエージェントの人数を増やすことではなく、待ち時間、情報の混線、検査の独立性、復旧範囲、操作権限を仕事ごとに設計できるようにすることです。
ハーネスとループの外側を設計する
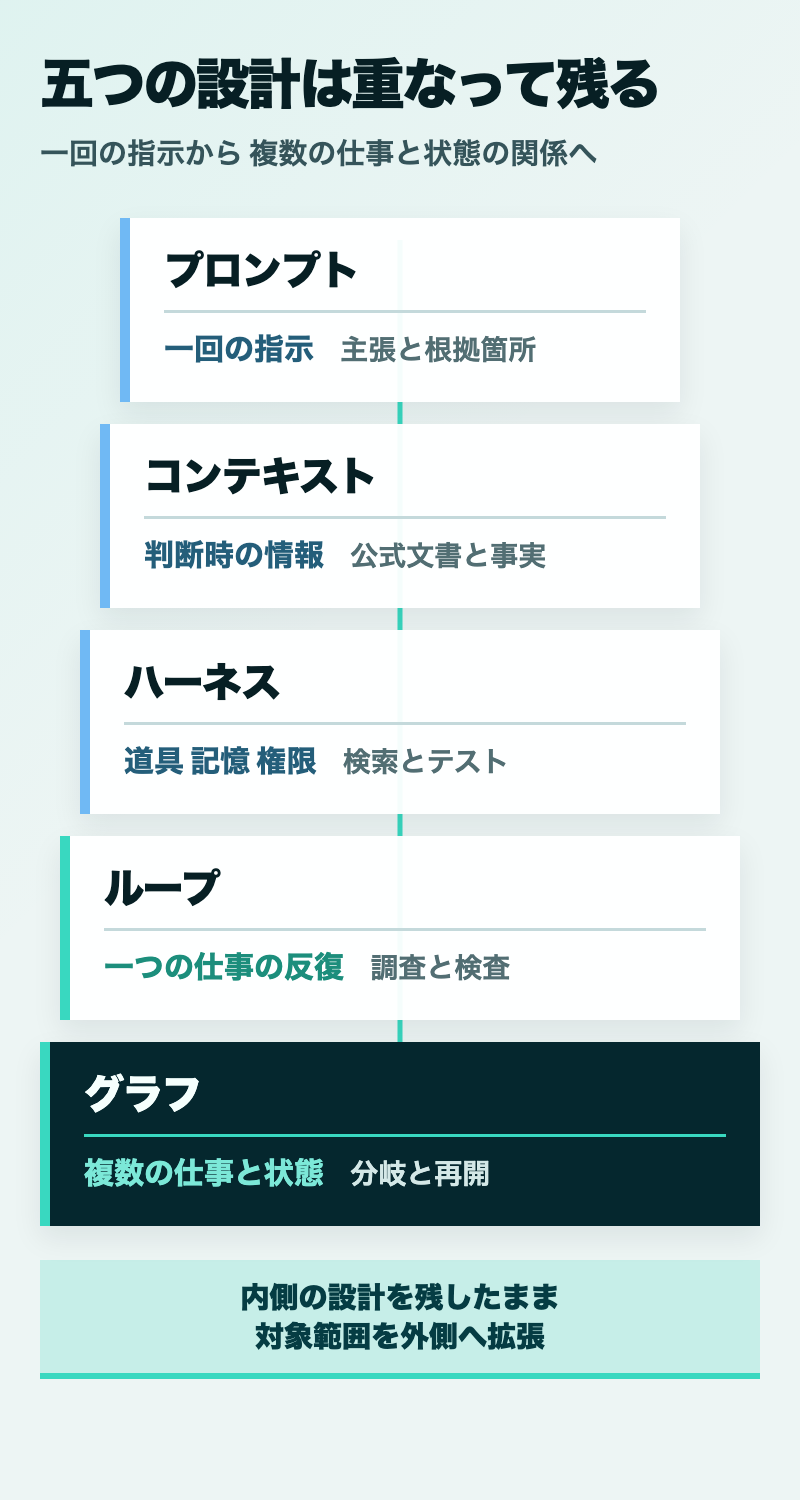
グラフエンジニアリングは、プロンプト、コンテキスト、ハーネス、ループを置き換える言葉ではありません。AIに任せる範囲が一回の応答から長い仕事へ広がるにつれ、設計対象がモデルへの入力から、モデルの周囲、反復、複数の実行役の関係へ広がりました。同じ記事制作を例にすると違いが見えます。
| 呼び名 | 主に設計する対象 | 記事制作で決めること |
|---|---|---|
| プロンプトエンジニアリング | 一回の指示 | 一次資料を優先し、主張と根拠箇所を分けて返すよう頼む |
| コンテキストエンジニアリング | AIが判断時に見る情報 | 公式文書、既存記事、採用済みの事実だけを、その工程へ渡す |
| ハーネスエンジニアリング | 道具、記憶、権限、実行環境 | Web検索、ファイル操作、テスト、保存先、公開権限の範囲を用意する |
| ループエンジニアリング | 一つの仕事の観測と修正 | 調査、抽出、検査、追加調査を、合格条件や予算まで反復する |
| グラフエンジニアリング | 複数の仕事と状態の関係 | 三調査をいつ分け、何を結合し、誰が検査し、失敗後にどこから戻るか決める |
Anthropicは2025年9月、長く動くエージェントでは指示文だけでなく、道具の定義、外部データ、会話履歴を含む限られた情報枠全体を選ぶ必要があると説明しました。1 OpenAIが2026年2月に公開したハーネスエンジニアリングの実践では、環境、道具、リポジトリ内の知識、検証の仕組みを整え、人が目的を示しAIが実行する開発体制を扱っています。2 ループでは、完了条件、予算、途中保存、停止しない場合の脱出経路まで決めます。3
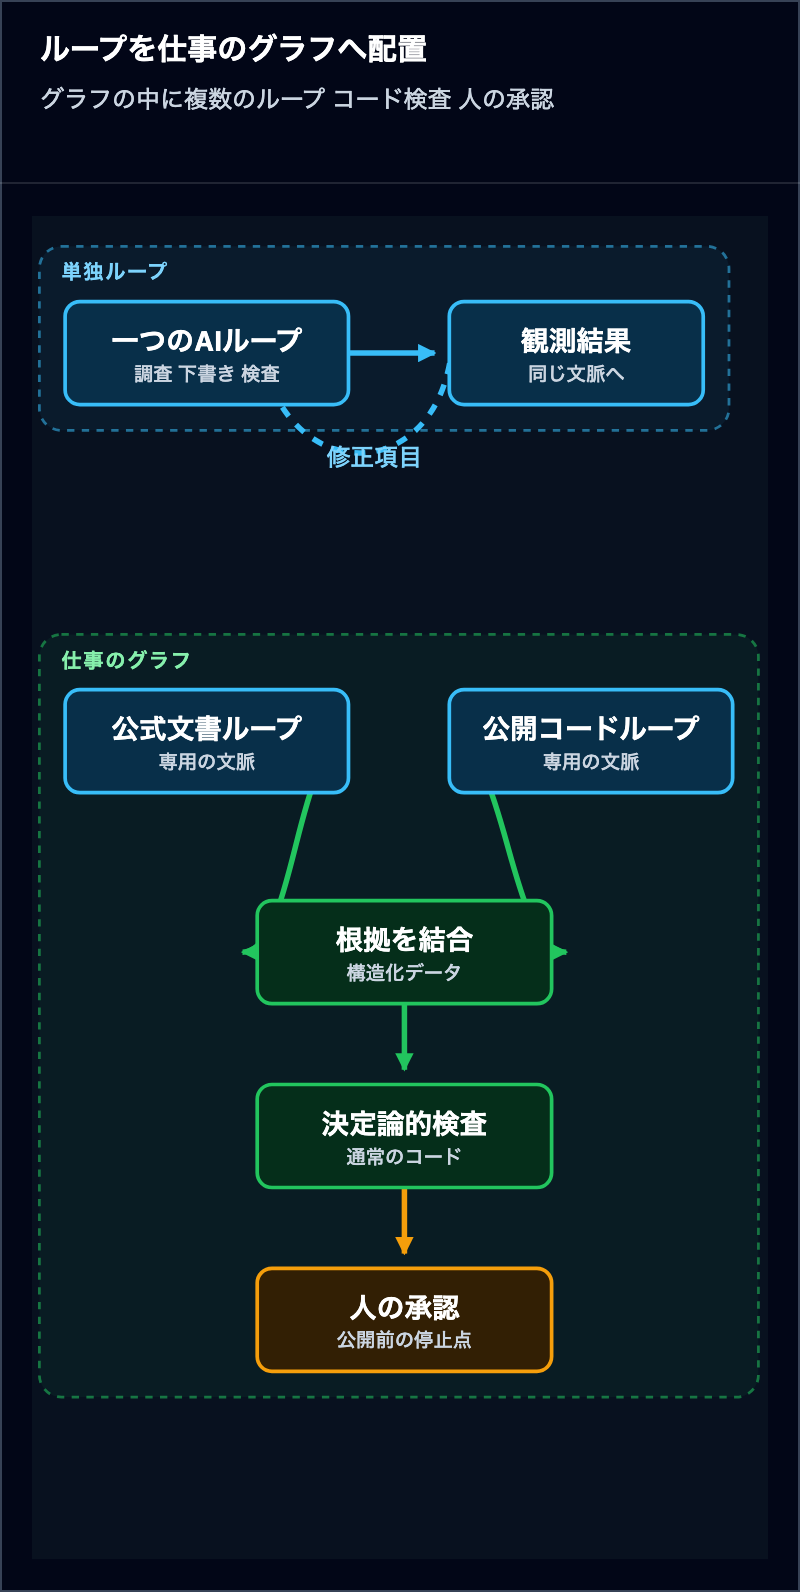
一つのループを安定して回せるようになると、次に「そのループをどの仕事へ割り当て、何と接続するか」が問題になります。グラフの一つのノードには、単発のモデル呼び出しだけでなく、道具を使って完了まで進む一つのエージェントループも入ります。別のノードは通常のコード、API操作、機械検査、人の承認でも構いません。グラフは内側の設計を捨てる段階ではなく、それらを仕事全体の中へ配置する段階です。
呼び名が急に広まったのは2026年7月中旬です。7月18日の短いX投稿をきっかけに議論が広がり、LangChainは7月22日、同社がエージェントをグラフとして実装してきたのは約3年前からであり、新しいのは完全なエージェントループを一つのノードとして実用的に置けるようになった点だと説明しました。4 8月12日の実践者記事は、ノード、エッジ、状態、振り分け、ゲートを持つ実行地図として整理し、8月21日の調査論文は、仕事の組織、エージェント連携、実行時状態の管理という三面から研究領域としてまとめています。56 後者は調査時点で査読前のプレプリントであり、定義が確定した標準規格ではありません。
部品は呼び名より前からありました。Anthropicは2024年12月に直列処理、振り分け、並列処理、統括役と作業役、生成役と評価役の反復を公開し、Microsoft ResearchのAutoGenも2023年から専門役を持つ複数エージェントの相互作用を示しています。78 AI以外でも、AWS Step FunctionsやMicrosoftのDurable Functionsは、並列分岐、状態、再試行、復旧を状態機械として扱ってきました。151617 グラフエンジニアリングは新しいアルゴリズムというより、確率的に判断するAI、分かれた文脈、トークン費用、人の承認、外部操作の副作用を、既存のワークフロー設計へ一緒に載せる呼び名です。
知識グラフとも役割が異なります。知識グラフは企業、人物、製品、事実などの関係を保存し、検索や推論に使うデータ構造です。ここで扱う実行グラフは、調査、検査、承認といった仕事をいつ動かし、何を渡し、失敗後にどこへ進むかを決めます。知識グラフを調査ノードの道具として使うことはできますが、同じグラフではありません。
グラフが効く仕事と効かない仕事
グラフが効くのは、仕事の一部に予測できる構造があり、分岐、検査、権限、復旧の境界を固定したい場合です。複数エージェントを使うこと自体は条件ではなく、通常のコードと人だけのノードが混ざっても構いません。
| ユースケース | 実行の形 | 得られるもの |
|---|---|---|
| 複数資料の調査 | 公式文書、公開リポジトリ、料金を同時に調べ、根拠カードを結合する | 独立作業の待ち時間を減らし、資料ごとの文脈を分ける |
| 問い合わせ対応 | 内容とリスクを分類し、定型回答、専門担当、人の承認へ振り分ける | 返金や個人情報変更など、高リスク操作だけを別経路へ送る |
| コード変更 | 実装役の後に、テスト、セキュリティ検査、レビューを独立して置く | 作ったAIと合格を出す役を分け、検査を省略しにくくする |
| 大量の定型制作 | 商品や地域ごとに作業を分け、失敗した枝だけ再開する | 完了済み成果物を再利用し、二重送信や全件やり直しを避ける |
反対に、短い仕事が一つの情報枠へ収まり、独立した枝がなく、失敗が安く、人が最後にすぐ確認できるなら、一つのループで十分です。調査の行き先や作業数を事前に決めにくい汎用調査へ固定経路を増やしすぎると、AIが状況に応じて計画する余地が狭まります。LangChainも、初期の詳細な調査を定義済みグラフで実装した後、計画と分担をハーネス内で決める一つの中核ループへ移しました。4
費用はもう一つの選択条件です。Anthropicの複数エージェント調査は、同社の内部評価で単独構成を90.2%上回った一方、通常のチャットの約15倍のトークンを使い、全員が同じ文脈を共有する依存の多い仕事には向かないと報告しています。9 グラフは経路を短くし、不要な枝を起動しない設計にも使えますが、並列に呼ぶだけでは安くなりません。
三分岐で待ち時間が56%減った
偽の依存を一本ずつ切る効果を確かめるため、三つの短い資料から事実と根拠箇所を抜き出す業務を作りました。資料はAnthropicのワークフローパターン、LangGraphの実行構造、Anthropic Researchの複数エージェント構成を、筆者が日本語で要約した合計2,556バイトの検証用データです。
環境はApple SiliconのMac、Node.js 25.8.1、Claude Code 2.1.243、モデルはClaude Haiku 4.5です。外部のグラフ基盤は使わず、409行のNode.jsで直列実行、三分岐、状態保存、結合、検査を実装しました。モデルには検証用資料と抽出指示だけを送り、道具、Web、外部接続、会話保存を無効にしています。
各抽出ノードの出力は、自由文ではなく次の形に固定しました。evidenceが入力資料に一字一句含まれるかは、AIではなくコードで検査します。
{
  "sourceId": "langgraph-runtime",
  "claims": [
    {
      "claim": "日本語の事実",
      "evidence": "入力資料から抜いた根拠箇所",
      "confidence": "high"
    }
  ]
}
直列版は一件の完了を待って次を呼び、三分岐版はPromise.allSettledで同時に呼びました。入力、モデル、出力契約、結合後の検査は同じです。
| 実行 | 方式 | 壁時計時間 | モデル呼び出し | 費用 | 検証済み根拠カード |
|---|---|---|---|---|---|
| 1回目 | 直列 | 29.327秒 | 3 | 0.033201ドル | 6 |
| 2回目 | 直列 | 28.680秒 | 3 | 0.029323ドル | 6 |
| 1回目 | 三分岐 | 12.721秒 | 3 | 0.031091ドル | 6 |
| 2回目 | 三分岐 | 13.040秒 | 3 | 0.035987ドル | 6 |
| 平均 | 直列 | 29.004秒 | 3 | 0.031262ドル | 6 |
| 平均 | 三分岐 | 12.881秒 | 3 | 0.033539ドル | 6 |
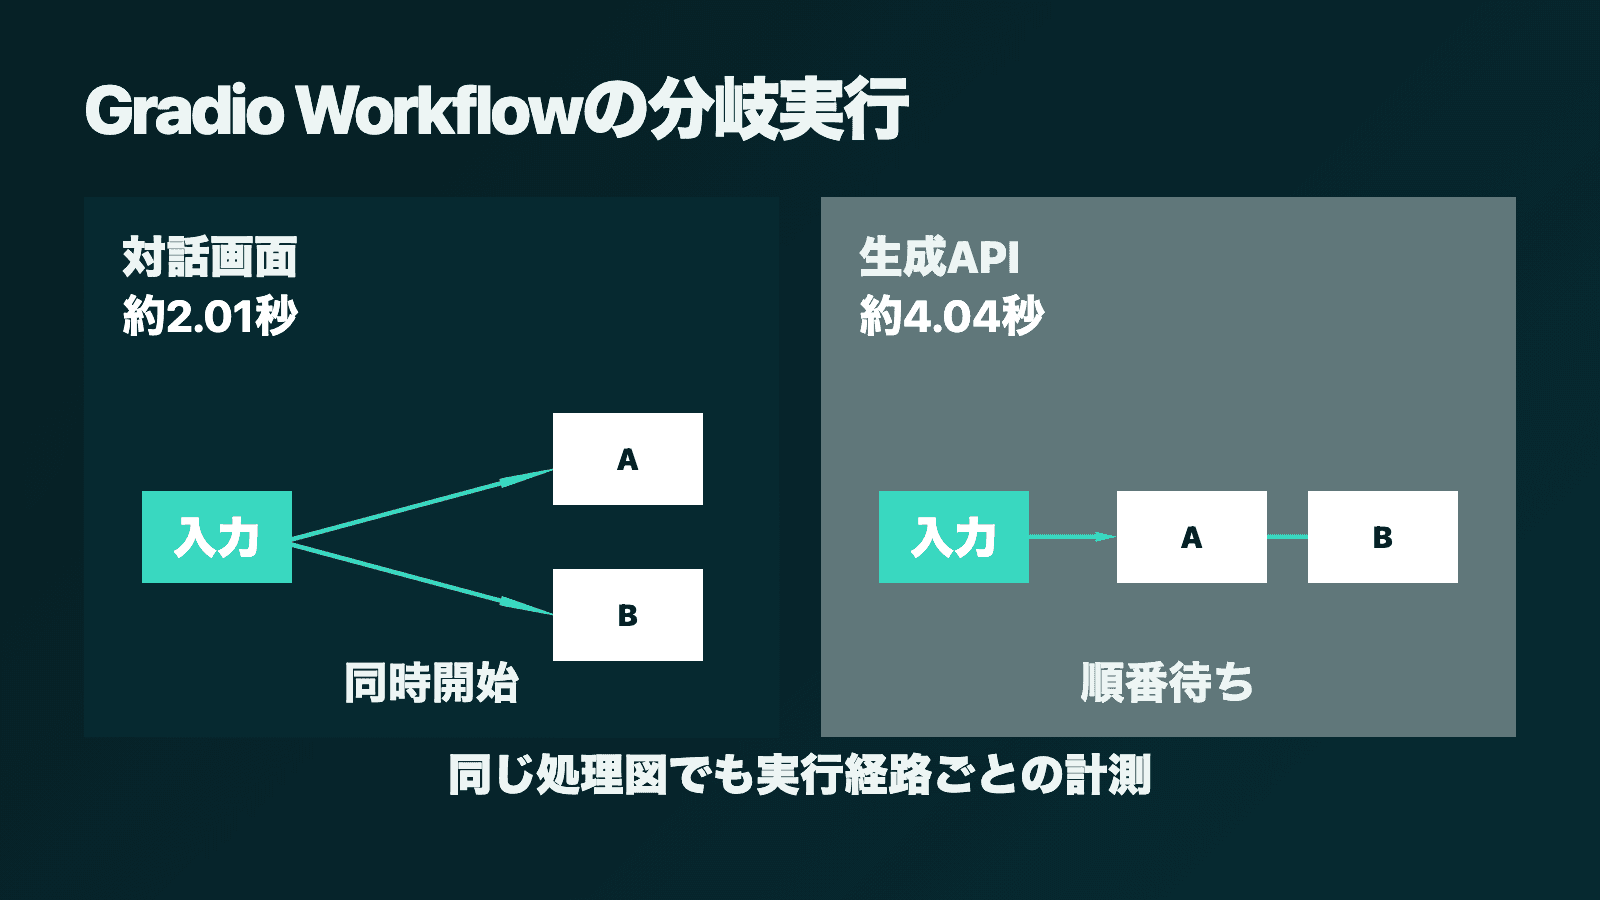
三分岐は直列より16.123秒短く、待ち時間は55.6%減りました。二回ずつの小さな測定なので、一般的なモデル性能値にはできません。ただし、後の仕事が前の出力を読まないのに待たせていたという構造上の無駄は、そのまま時間差へ表れました。
費用は別です。どちらもモデルを3回呼んでおり、三分岐の平均費用はむしろ0.002277ドル高くなりました。この差は二試行の出力量のばらつきを含むため、並列化の影響とは判断できません。確かなのは、同時に動かすだけでは呼び出し数が減らず、安くもならないことです。短い経路への振り分け、不要な枝の停止、コードによる整形まで加えて、初めて費用を下げられます。
試走では、設計していなかった失敗も出ました。二件目のモデルが、JSONをMarkdownのコード枠で包んで返したため、厳格な受け取り側が19.405秒の地点で拒否しました。指示にはコード枠を使わないと書いていても、自然言語の依頼だけでは契約になりません。
復旧ではAIへ書き直しを頼まず、JSONコード枠だけを通常のコードで外し、その後は同じ構造検査と根拠文字列検査へ通しました。モデルは資料から事実を選ぶ判断に使い、形式の正規化は決定論的に処理する分担です。この小さな失敗が、ノード契約とエッジ上の検査を置く理由を、時間比較よりも分かりやすく示しました。
ループとグラフの境界はエッジ
実装の中心はエージェントの人数ではなく、ノード間をつなぐ線に何が流れるかです。次の仕事が前の成果を読まないなら、そこに実行上のエッジは要りません。前後に書かれた手順を、本当に必要な依存へ書き直すところから始まります。
| 要素 | 決めること | 今回の実装 |
|---|---|---|
| ノード | 一つの仕事、入力、出力、失敗条件 | 一資料から最大二件の根拠カードを作る |
| エッジ | 次の仕事へ渡すデータまたは操作権限 | 三資料のカードを結合検査へ渡す |
| 状態 | 中断後も残す事実と成果物参照 | 完了ノード、JSONファイル、失敗理由、費用 |
| 振り分け規則 | 現在の状態から選べる次の経路 | 未完了ノードだけを再実行する |
| ゲート | 下流へ進める条件 | 構造と根拠文字列の検査に合格する |
ノードはAIに限りません。今回も、資料から主張を選ぶ部分だけをAIへ任せ、JSONの正規化、構造検査、根拠の照合、重複除去、成果物の結合は通常のコードで処理し、人の承認は公開を許可するまで止めるノードとして置きました。
エッジも「BはAの後」という予定表ではありません。「Aが作った根拠カードをBが読める」「人が承認した場合だけ公開処理が操作権限を受け取る」というデータと権限の契約です。順番だけを表す線が増えれば独立処理にも待ち時間が生じ、必要な線が抜ければ下流は古い状態や推測で動きます。
実務で現れる形を分けると、次の四つです。
| 形 | 動き | 選ぶ条件 |
|---|---|---|
| 直列 | AからB、BからCへ進む | 後工程が前工程の出力を必ず読む |
| 分岐と結合 | 独立作業を同時に動かし、必要な地点でまとめる | 全結果の比較、順位付け、重複除去が必要 |
| 振り分け | 入力や状態に応じて一つの経路を選ぶ | 簡単な仕事と高リスクの仕事で検査量を変える |
| 制御された循環 | 作成、検査、修正を条件付きで繰り返す | 合格条件、最大回数、予算、脱出経路を測れる |
循環を含まない有向グラフはDAGと呼ばれますが、グラフエンジニアリング全体がDAGとは限りません。修正や追加調査では前のノードへ戻ります。戻り道には「良くなるまで」ではなく、未解決項目数、検査合格、最大回数、費用上限といった停止条件が必要です。
AIに振り分けを判断させる場合も、許可する行き先はコードで限定します。AIが変更を低リスクと分類したら短い検査へ、高リスクなら複数の専門検査へ、不明なら人へ戻す、といった構成です。確率的な判断を使いながら、公開、削除、決済まで自由に経路を作らせないための境界になります。
失敗した一件だけを再開する
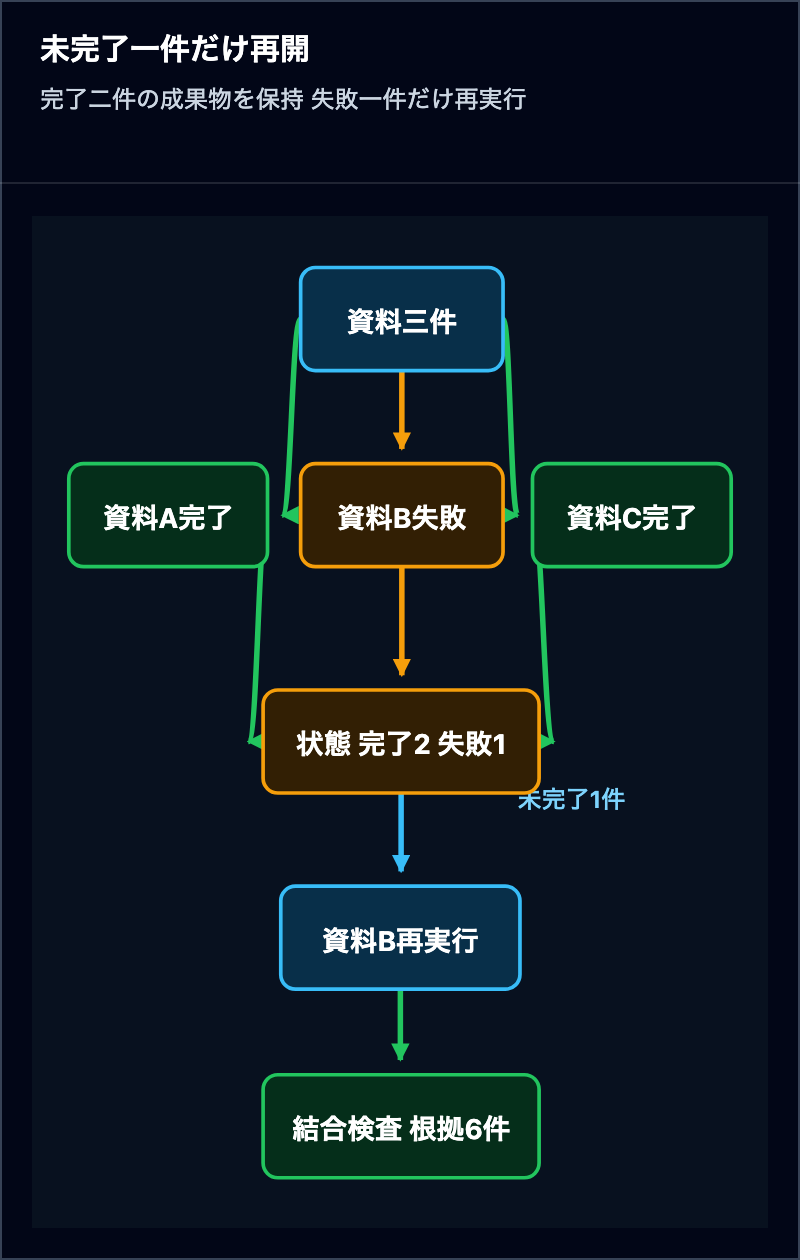
並列化より運用で効くのが、失敗を小さな範囲へ閉じ込める設計です。三分岐の追加試験では、全モデルの応答が返った後、LangGraph資料のノードだけに人工的な例外を起こしました。最初の実行は12.002秒で終わり、二件のJSON成果物と、一件の失敗理由を状態ファイルへ保存しています。
次の実行は、状態ファイルから完了済みの二件を読み、未完了一件だけを再度呼びました。モデル呼び出しは最初の3回と再開時の1回で累計4回です。全体を最初から実行すれば累計6回になるため、二件分の重複を避けられました。最終的な累計費用は0.047050ドルで、六つの根拠カードが構造検査と根拠照合に合格しています。
再開した一件には20.958秒かかり、時間だけを見れば速い試行ではありませんでした。モデル応答時間のばらつきがあるため、チェックポイントの価値を一回の所要時間で評価すべきではありません。再利用できる成果物と、二重に起こさなかった外部操作の数で測る方が確実です。
グラフの図を描くだけで再開できるわけでもありません。直列の業務でも状態を保存すれば再開できます。必要なのは、各ノードの完了を永続化し、大きな会話文ではなく成果物のファイルや識別子を渡し、同じノードを再実行しても副作用が重複しないようにすることです。LangGraphはノード間のチェックポイントと失敗情報の保存を備えています。1011
記事の下書き作成なら、同じ節を二度生成してもファイルを置き換えれば復旧できます。メール送信、決済、公開、顧客管理システムの更新では、処理ごとの一意な識別子、送信済み記録、書き込み前後の確認を持たせ、二重送信や二重請求を防ぎます。道具側を何度呼んでも結果が一つに保たれることが、AIへ再試行を任せる前提です。
状態が崩れるとグラフの絵も崩れる
きれいな実行図だけでは、必要な情報が正しく渡ることまで保証できません。MicrosoftのAutoGen GraphFlowは、誰がいつ動くかを決める実行グラフと、各エージェントがどのメッセージを受け取るかを決める情報の流れを分け、初期状態で全員へ渡るメッセージを絞る機能も別に用意しています。12 実行順の正しさと、情報の不足や過剰を防ぐことは別の設計課題です。
今回の実装では、三つのノードが同じ状態ファイルへ直接書き込まないようにしました。各ノードは独立したJSON成果物だけを作り、三件が落ち着いた後に統括処理が状態を一度更新します。同じ配列へ並行して追記する設計では、後から完了した書き込みが前の結果を上書きしない統合規則が必要です。LangGraphが状態項目ごとに更新をまとめる関数を持つのも、この衝突を扱うためです。10
結合地点の置き方も速度を左右します。今回の最終検査は三資料がそろっていることを確認するため、全枝を待つ意味がありました。一方、一件ずつ独立して公開前検査へ進める仕事なら、毎段階で全件を待つ必要はありません。分岐を作っても各所に待ち合わせを置けば、処理の形は並列でも、待ち時間は直列へ戻ります。
複数エージェントの失敗は、モデルの賢さだけでは説明できません。2025年のMAST研究は、5つの複数エージェント基盤と150超の課題を調べ、1,642件の実行記録から14の失敗類型を見つけました。大分類は、仕様とシステム設計、エージェント間の不整合、検証と終了です。13 役割が曖昧、必要な情報が渡らない、誰も結果を確かめないという、ノードとエッジの問題が含まれます。
原因を後から追える記録も必要です。ACL 2026のTraceElephant研究では、最終出力だけでなく、入力と途中文脈を含む完全な実行記録を使うことで、部分的な記録に比べて失敗担当の特定精度が最大76.5%改善しました。14 残すべきなのは「失敗した」という一行ではなく、どの入力と状態を見て、誰がどの経路を選び、何を出力し、どの検査で止まったかです。
小さなグラフから始める
最初の実装は、複数エージェント基盤を選ぶ作業ではありません。実際の仕事を一回記録し、どの出力を誰が読むかを確認するところから始めます。
- 目的と完了条件を一文にします。
- 実行した仕事を、AI、コード、道具、人の確認に分けて並べます。
- 各仕事について、前の出力を本当に読むかを確認し、読まない線を切ります。
- 残った各ノードへ、入力、構造化出力、失敗条件、担当する権限を決めます。
- 整形、重複除去、計算、形式検査はコードへ戻し、判断だけをAIへ残します。
- 高価なノードの後に成果物と状態を保存し、再試行、停止、人への引き継ぎを決めます。
- 同じ課題を一つのループと小さなグラフで測り、品質、時間、呼び出し数、費用、復旧時の重複を比べます。
グラフへ移す合図は、独立作業を同時に走らせたい、担当ごとに道具や権限を分けたい、生成役と検査役を独立させたい、中断後に安全に再開したい、という要求が現れたときです。人数ではなく、必要な関係が増えたかで判断します。
今回の実測で最も効いた変更は、エージェントを増やしたことではなく、存在しなかった依存を二本削除したことでした。グラフを描いてみて、ほとんどの矢印がデータも権限も運んでいないなら、先に線を消せます。消した後に一つのループだけが残るなら、それもグラフエンジニアリングが導いた正しい設計です。
参照リンク17件
- AnthropicEffective context engineering for AI agents
- OpenAIHarness engineering: leveraging Codex in an agent-first world
- AnthropicStartup Builds: Getting Started with Loops
- LangChain3 Years of Graph Engineering with LangGraph
- 0xwhrrariGraph Engineering: How to Build AI Agent Systems That Don't Break at Scale
- arXivGraph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence
- AnthropicBuilding Effective AI Agents
- Microsoft ResearchAutoGen: Enabling next-generation large language model applications
- AnthropicHow we built our multi-agent research system
- LangChainGraph API overview
- LangChainFault tolerance
- MicrosoftGraphFlow (Workflows) — AutoGen
- arXivWhy Do Multi-Agent LLM Systems Fail?
- ACL AnthologySeeing the Whole Elephant: A Benchmark for Failure Attribution in LLM-based Multi-Agent Systems
- AWSParallelワークフローの状態
- AWSStep Functionsワークフローでのエラー処理
- Microsoft LearnDurable Functionsの概要
2026年8月26日時点の公式資料を確認しています。仕様は更新される可能性があります。