コード修正を任せるAIモデルは、公開順位表の総合点ではなく、自社で失敗すると困る課題の成功率と結果のばらつきで選びます。Railsが公開した4モデル252回分の記録では、49対48の二モデルでも得意課題が入れ替わりました。順位表で候補を絞り、自社の課題を足して最終判断する方法を説明します。
モデル選びは失敗すると困る課題から始める
AIにコード修正を任せるときに知りたいのは、順位表の一位ではなく、自社で繰り返す修正を安定して任せられるモデルです。公開順位表は候補を絞る入口に使い、失敗すると困る課題、同じ課題を繰り返したときのばらつき、人が直す時間を自社の条件で比べます。
Ruby on Railsが公開した評価では、OpenAIのGPT-5.6 Terraが63回中49回、AlibabaのQwen 3.8-27Bが48回成功しました。差は一回ですが、失敗した課題と結果の安定性は大きく違います。12
Railsは、Webサービスを作るためのソフトウェアです。その開発チームは2026年8月24日、Rails上の修正をAIへ任せる評価基盤lemansと、各モデルの実行記録を公開しました。最終順位だけでなく、課題、採点手順、コード差分、失敗理由まで確認できます。12
知能圏編集部は、同日に追加された四モデルについて、21課題を3回ずつ解いた252回分の記録を再集計しました。成功数、所要時間、費用は公式値と一致しました。一方、Rails標準機能を使えた割合は、公開記録だけでは同じ値を再現できませんでした。
252回分の記録を使い、総合点が近いモデルでも得意な修正が入れ替わることを確かめます。その結果から、公開順位表で候補を絞り、自社の課題を足して最終的なモデルを選ぶ手順へつなげます。
一モデルの順位は63回から作られる
評価に使われたのは、Rails製の書籍公開アプリへ小さな不具合や機能追加を入れた21課題です。各モデルは同じ課題を3回ずつ解くため、一モデルの成績は63回から作られます。今回の検算対象は四モデルなので、確認した記録は252回です。23
モデルに渡されるのは、課題文と、コマンドでコンピューターを操作する道具です。作業後には自動テストが走り、アプリ本来のテストと課題専用のテストを両方通れば成功、どちらかへ落ちれば失敗になります。採点役のAIは使いません。3
順位表には成功率のほか、所要時間、出力量、費用、Rails標準機能の利用率が並びます。最後の指標は「課題を解けたか」ではなく、「Railsが用意した機能を選んで解いたか」を見る別の数字です。5
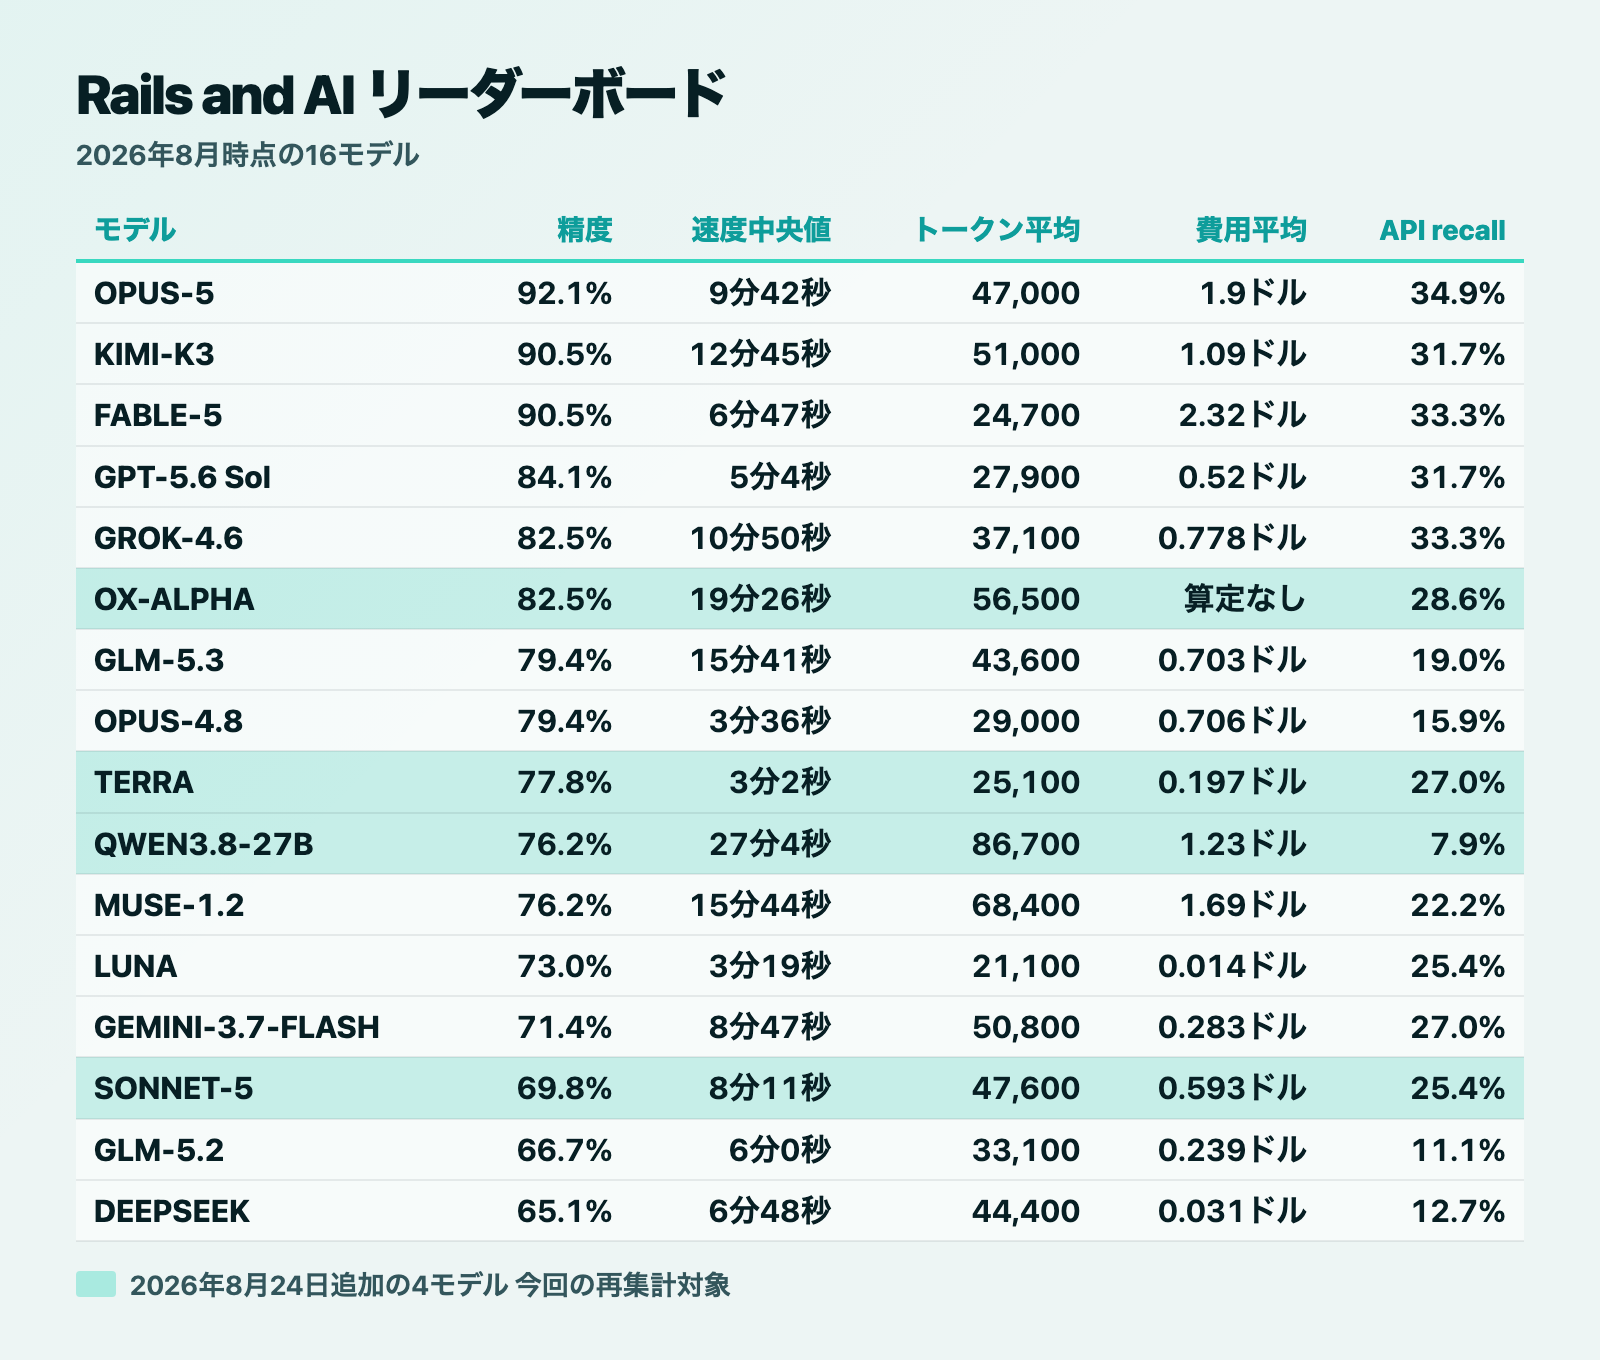
図は公式順位表に載る16モデルの位置関係を示したものです。今回の再集計は、そのうち2026年8月24日に追加された四モデルへ絞りました。
この試験は、コード修正のすべてを測るものではありません。社内文書の検索、ブラウザー、複数AIの分業は使わず、小さなRails修正を一つの道具で解く条件です。順位は、同じ条件でモデルを横に並べた結果として読みます。13
252回を再集計すると三つの数字は一致した
知能圏編集部は公式リポジトリを固定の版で取得し、四モデルの実行結果を集計しました。成功は自動テストへ通った回数、所要時間は63回の中央値、費用は一回あたりの平均です。2
| モデル | 成功 | 所要時間中央値 | 平均費用 | 3回とも成功 | 成否が混在 |
|---|---|---|---|---|---|
| ox-alpha | 52/63 | 19分26秒 | 算定なし | 15課題 | 4課題 |
| GPT-5.6 Terra | 49/63 | 3分2秒 | 0.197ドル | 15課題 | 3課題 |
| Qwen 3.8-27B | 48/63 | 27分4秒 | 1.230ドル | 13課題 | 6課題 |
| Claude Sonnet 5 | 44/63 | 8分11秒 | 0.593ドル | 10課題 | 9課題 |
ox-alphaは提供元を伏せた試験公開中のモデル、Claude Sonnet 5はAnthropicのモデルです。四モデルすべてで成功数と時間が公式順位表に一致し、費用が公表されている三モデルも同じ値になりました。ox-alphaの費用は算定なしです。表の費用は評価記録にある米ドル建てで、円換算は為替によって変わるため載せていません。125
8月25日と27日に同じ固定版から計算しても、結果は変わりませんでした。成功数、時間、費用は、公開された実行記録から第三者が同じ方法で再計算できます。
ここで実行したのは、公開済み記録の再集計です。筆者のMacには評価実行が求める新しいRubyと隔離環境がなかったため、モデルへ252回の課題を解かせ直してはいません。検算できたのは、公開記録から機械的に計算できる成功数、時間、費用です。4
合計点が近くても失敗した課題は違う
Terraの49回とQwenの48回を21課題へ戻すと、成績が異なる課題は七つありました。
| 課題の中心 | Terra | Qwen |
|---|---|---|
| リダイレクト後の戻り先 | 3/3 | 2/3 |
| 一度だけの通知 | 2/3 | 1/3 |
| 並び順の詰め直し | 3/3 | 1/3 |
| 埋め込み画像の削除 | 0/3 | 2/3 |
| 画像変換の重複防止 | 0/3 | 2/3 |
| 権限別キャッシュ | 1/3 | 3/3 |
| 古い変換処理への対応 | 3/3 | 0/3 |
Qwenは、Terraが全敗した二つの画像課題で2回ずつ成功しました。Terraは、Qwenが全敗した古い変換処理で3回とも成功しています。合計点の近さは、得意分野の近さを意味しません。
結果の安定性にも差があります。Terraは15課題で3回とも成功し、成否が分かれたのは3課題でした。Qwenは全勝が13課題、成否混在が6課題です。Qwenの実行では9回が、AIへ許されたコマンド操作100回の上限へ達して終了し、Terraは全件が通常どおり完了しました。12
画像処理が多い製品と、古い変換処理を保守する製品では、同じ49対48から別の選択が生まれます。平均点より先に、自社で失敗すると困る課題を探す必要があります。
標準機能の利用率だけは同じ値を出せない
Rails標準機能の利用率は、課題ごとに想定された機能へ実装が到達した割合です。公式値はTerraが27.0%、Qwenが7.9%でした。動作を直せても手作りのコードが増えれば、その分だけ将来の保守対象も増えます。15
ところが、252回分の結果ファイルには、各実行を標準機能の利用として数えたかどうかが記録されていません。コード差分へ想定機能の名前が含まれる割合を数えると、公式値とは大きく異なりました。
| モデル | 公式値 | コード差分の文字列一致 |
|---|---|---|
| GPT-5.6 Terra | 27.0% | 55.6% |
| Qwen 3.8-27B | 7.9% | 50.8% |
Terraは画像削除の課題で標準機能purge_laterを使いながら、3回ともテストへ失敗しました。Qwenは戻り先の課題で想定機能url_fromを使わず、3回中2回成功しています。機能名がコードにあること、正しく使えたこと、課題を解けたことは別の事実です。
公式値と同じ数字を出すには、各実行の判定結果か、別名で呼び出した場合まで含む判定規則が必要です。成功数、時間、費用は検算できますが、この列だけは現在の公開範囲では発表元の判定を独立に確かめられません。
この順位表が測らない仕事もある
lemansは、課題、実行環境、操作回数、採点方法を固定し、モデル以外の差を減らします。モデルがテストを書き換えて合格を装えないよう、採点前にテストと設定を元へ戻す仕組みもあります。24
条件を揃えるほど、順位表が答えられる範囲も狭くなります。今回の評価が測るのは、小さなRails修正を一つのコマンド操作環境で解く能力です。
| 順位表に含まれない要素 | 実際の仕事で起きること |
|---|---|
| 社内情報 | 文書や過去の設計判断を検索してから直す |
| 外部操作 | ブラウザーや外部サービスを使う |
| 分業 | 複数のAIへ調査、実装、確認を分担させる |
| 長い仕事 | 数日かかる機能開発や大きな設計変更を進める |
| 人の作業 | 変更を読み直し、必要な箇所を修正する |
順位表が役に立たないのではありません。「この条件での成績」として候補を絞るために使い、実際の開発環境で同じ順位になるとは決めつけないことが大切です。
自社の課題を足してモデルを選ぶ
公開順位表は、候補モデルを数個へ絞る入口になります。契約や標準モデルを決める前に、自社で繰り返し起きる変更や不具合を10件から20件ほど評価課題へ変えます。
記録する項目は、合否、再依頼の回数、待ち時間、費用、変更量、人が直した時間です。一つの課題を3回以上繰り返して平均と結果のばらつきを分け、失敗が事故へつながる課題では、3回中2回の成功を「ほぼ成功」と扱わない基準を置きます。
得意分野が入れ替わるなら、モデルを一つへ固定する必要もありません。安く速いモデルを通常の修正へ使い、画像処理や古い変換処理など、失敗しやすい仕事だけ別モデルへ送れます。
順位表の49対48は答えではありません。どの数字を再計算できるか、どの課題で失敗したか、同じ課題を繰り返したときに安定するかを確認し、自社の失敗へ重ねたところで初めて選定材料になります。