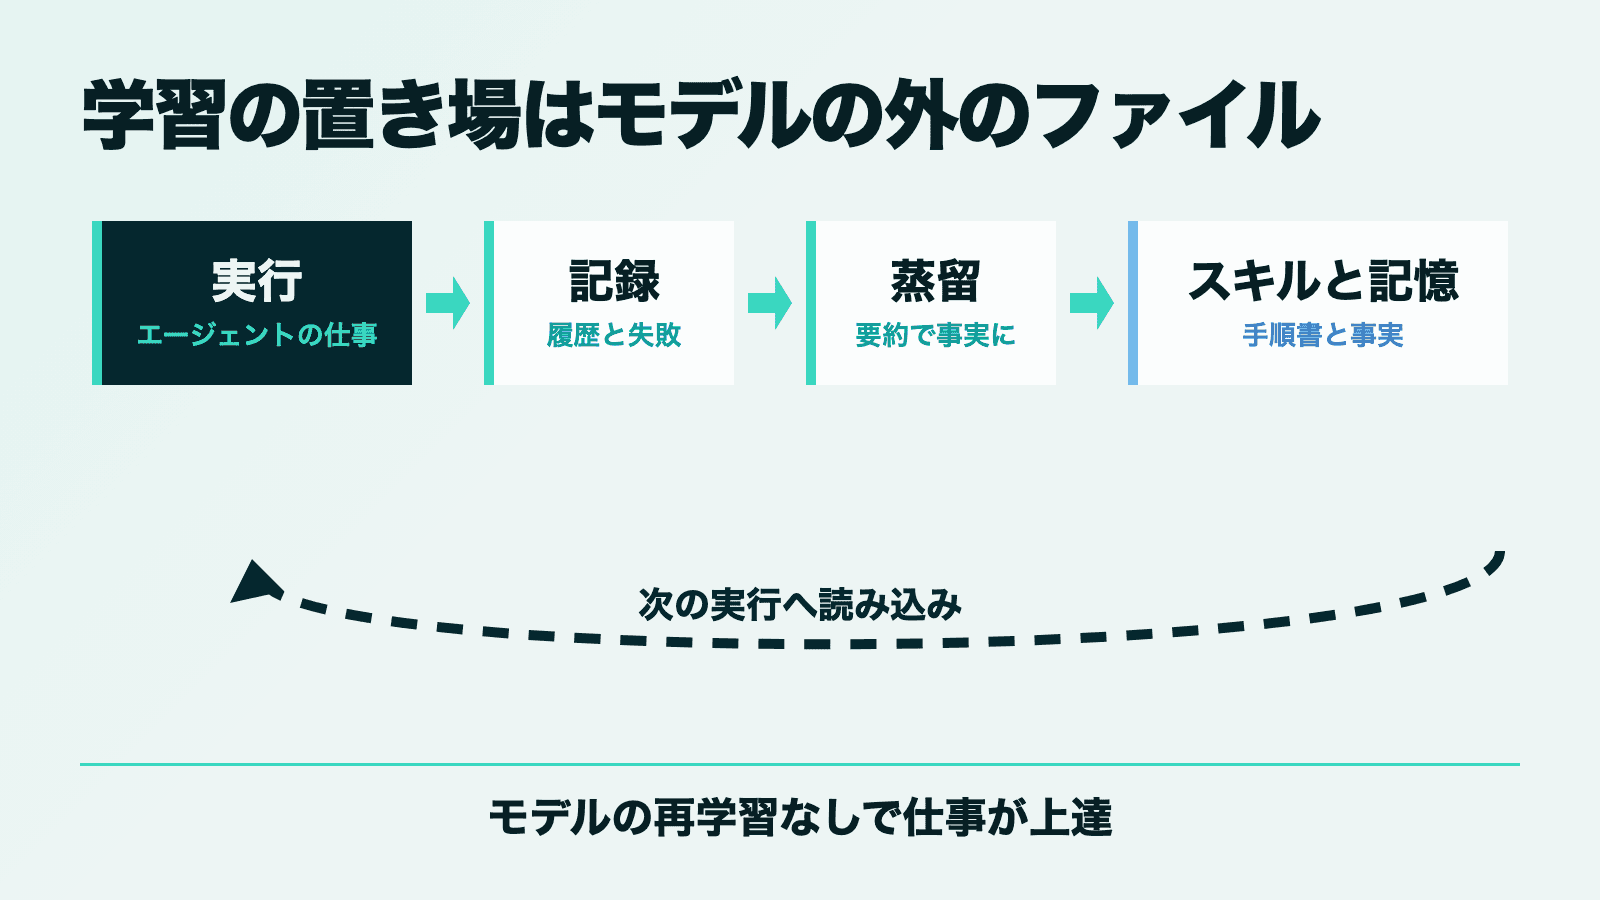
AIエージェントへ毎回同じ仕事を頼むなら、学んだ手順を保存する条件と、次回それを読む手順を常設指示へ置きます。自作した小さな実行環境の制作記録から、手順の保存と再利用、教材の誤記を引き継いだ失敗を説明します。Hermes本体の長期運用や、費用削減の一般的な効果を測った記事ではありません。
毎回忘れるエージェントと毎回覚えるエージェント
毎月のレポートをAIエージェントへ作らせる担当者が、社内ツールの使い方を毎回説明しているとします。前回は古い出力形式で失敗しても、新しい会話へ切り替えたエージェントにその記録が渡らなければ、同じ調査と失敗を繰り返しかねません。
自己改善の入口は、前回見つけた正しい引数や確認手順をファイルへ保存し、次の仕事の開始時に読むことです。たとえば「レポートを生成して」という依頼に、開始時の手順確認と、失敗が続いたときの学びの保存を常設指示として組み合わせます。モデル自体を学習し直す代わりに、仕事へ渡す情報を更新する仕組みです。
保存した内容には、古い認証方法や教材の誤記も混ざります。手順書ができた時点で採用せず、同じ課題で再利用できるか、誤りまで引き継いでいないかを確かめる必要があります。この記事では自作環境の制作記録を使い、保存条件、読み込み、評価をどこへ置くかを説明します。
自己改善の土台になるハーネスとループ
Sean氏の基礎編は、流行語になっている四つの言葉、エージェントハーネス、ループエンジニアリング、LLMOps、評価を一枚の図へ積み上げる構成です。1 ハーネスは馬具が語源で、LLMという強力だが手綱のない馬に着ける道具一式を指します。中身は、システムプロンプト、呼び出せる道具、記憶の読み書き、権限、停止条件など、モデルの外側に置く実行の枠組み全部です。LLMは次の単語を確率で選ぶ仕組みである以上、出力には毎回ゆらぎがあります。仕事を任せるには、この枠組みで進む方向を絞る必要があります。
ループエンジニアリングは、その枠組みの中でモデルに道具を繰り返し呼ばせ、どこで止めるかを設計することです。返金対応を例にすると、エージェントは顧客管理システムから苦情30件を読み、未返金の8件を特定し、決済サービスで返金を実行するか担当者へ一覧を渡すかを判断し、完了条件を満たしたところでループを終えて報告する、という流れです。動画がエンドループガードレールと呼ぶ終了条件を決めないと、モデルは道具を呼び続けるか、途中の承認待ちで止まったまま時間を失います。
この用語の使い分けは日本語圏でも定着し始めています。プロンプトが指示文の設計、ハーネスがモデルの周囲に仕事の環境を作る層、ループが実行、検証、再試行、終了を反復の形に組む層という整理です。45
ハーネスには記憶の設計も含まれます。基礎編が分ける記憶は三つです。
- 手続き記憶。どう動くべきかの手順書で、いわゆるスキルにあたります。
- 意味記憶。利用者や環境について変わりにくい事実です。
- エピソード記憶。過去の会話と出来事の時系列の記録です。
エピソード記憶は放っておくと増え続けるため、安価なモデルで定期的に要約し、残すべき事実だけを意味記憶へ蒸留します。この「実行の記録を要約して事実と手順へ変え、次の実行で読み込む」流れが、次の節で見る自己改善の骨組みです。
Hermesが実装する学習の閉ループ
Hermesは、AIモデルの研究企業Nous Researchが公開しているオープンソースの自己ホスト型AIエージェントです。利用者のPCやサーバーに常駐し、WhatsAppやTelegramなど20以上の連絡アプリか専用アプリから話しかけて使います。接続するAIモデルは選択式で、OpenRouterやOpenAIなど互換の接続先を指定できます。6 GitHubのスターは公開から3か月足らずで14万を超え、NVIDIAは自社ブログで、経路集約サービスOpenRouter上で最も使われているエージェントと紹介しました。78 Sean氏の動画時点では20万超と紹介されています。2
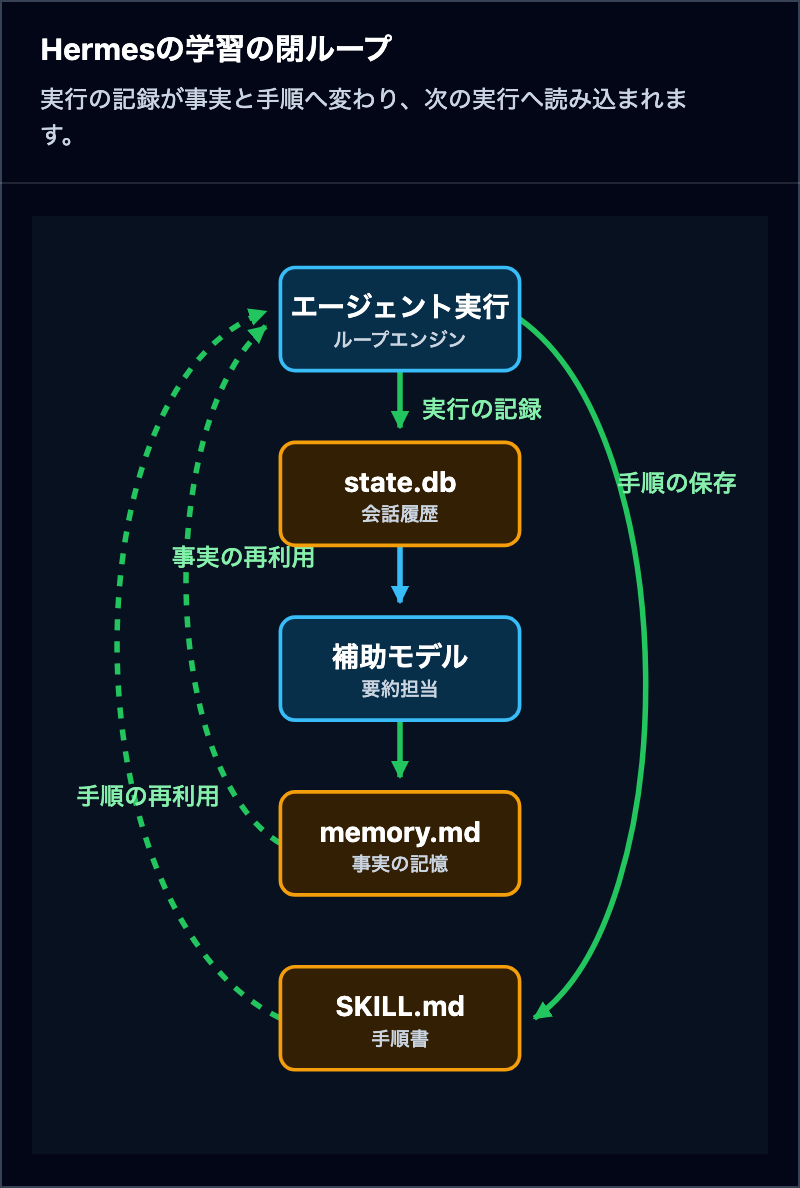
学習の閉ループの実体は、ローカルに置かれた少数のファイルです。
| 置き場所 | 役割 | 更新のきっかけ |
|---|---|---|
| SOUL.md | 人格と基本方針を書いたシステムプロンプト | 人が編集する |
| skills配下のSKILL.md | 手続き記憶。作業の手順書 | エージェントが作成し、使いながら改訂する |
| memory.md | 意味記憶。利用者と環境の事実 | エージェントが追記する |
| state.db | エピソード記憶。会話履歴のデータベース | 実行のたびに記録され、補助モデルが要約して事実をmemory.mdへ蒸留する |
Sean氏の実演には、書き込みが起きる瞬間が写っています。YouTubeチャンネルの調査を頼んだ場面で、エージェントは誤ったURLを開いて失敗した直後、正しい取得方法をmemory.mdへ自分で追記しました。スキルの自発保存はもっと慎重で、手順書側に「道具呼び出しが5回以上になる難しい反復作業の後に、スキルとして保存することを提案する」という条件が置かれています。記憶の検索は埋め込みベクトルによる意味検索を使わず、SQLiteの全文検索機能FTS5と平文のキーワード照合で済ませる作りです。26 どのファイルも利用者のPCに置かれ、クラウドには送られません。
実演は成功例だけではありません。1分ごとに冗談を送る定期実行(cron)を頼んだ場面では、10回のはずが2回しか届かず、Sean氏は動画内でそのまま不具合として報告しています。書き込みの仕組みがあることと、毎回意図どおり動くことは別の話で、その差を埋めるのが次の節の評価です。
評価を足すまで改善は閉じない
基礎編の後半はLLMOps、つまりエージェントの実行を測って直す運用に充てられています。実行のたびに、何を聞かれ、どの道具を何回呼び、何秒かかり、いくら使ったかを木構造で記録し、その記録をプログラムと判定用AIで採点し、悪化した箇所を診断して、システムプロンプトや設定を書き戻すところまで閉じて、はじめて変更が改善だったと言えるループになります。1
Sean氏の調査時点で、Hermes本体には実行記録の書き出し機能はあるものの、採点と診断の仕組みはありません。2 スキルと記憶は増えていくのに、その変更が良かったかを測る物差しは利用者側の宿題として残ります。
この穴を埋める公式の実験がhermes-agent-self-evolutionです。9 プロンプト最適化フレームワークDSPyと、実行記録から失敗の理由を分析して文面の変異を提案する進化的手法GEPAを組み合わせ、SKILL.mdの変種を世代交代させて、評価データの成績が良いものだけを残します。1回の最適化にかかる費用は2〜10ドルと見積もられています。合格には、テストに通ること、スキルが15KB以下に収まること、元の意味を保っていることに加え、人がプルリクエストとして審査することが必須です。成績の良い変種でも、自動では本体へ取り込まれません。
評価課題をどう作り、本番の失敗をどう評価へ戻すかは、既公開記事「AIエージェントをどう評価するか」で扱っています。自己改善の文脈では、エージェントが自分に加えた変更も、人が加えた変更と同じ物差しで測る対象になる点だけが違います。
30日の運用で崩れる場所
自己改善ループの問題が表に出るのは、動かし始めよりも続けた後です。Hermesを実運用する開発者nyk氏は、調査、執筆、開発、進行管理の4役を一つのHermesに14日担わせた結果、どの役も同じ口調と判断に溶け合ったと報告しています。10 氏の分析では、原因はプロンプトの書き方でもモデルの性能でもなく、一つの記憶を全役で共有したことでした。
Hermesのプロファイル機能は、設定、セッション、記憶、スキル、人格、定期実行、連絡経路の七つの状態を役ごとに分離します。氏の運用則で軸になるのは、人格ファイルSOUL.mdと案件ファイルAGENTS.mdの分離です。人格は安定した状態に保ち、いま扱っている案件の文脈は別ファイルで入れ替える方式です。この分離を怠ると、人格ファイルへ案件の特例が書き足され続けます。
氏が挙げる30日目の崩れ方は四つあり、いずれも書き込みが自由なまま検査がないことから始まります。
| 崩れ方 | 起きること | 手当て |
|---|---|---|
| 役割の漂流 | 人格ファイルへ他役の責務が書き足され、執筆役が実装へ踏み込むなど役が混ざる | 毎週、初日の版と差分を取り、承認記録のない追記は戻す |
| 受け渡しの崩れ | 調査役が生の資料40KBを執筆役へ流し込み、分業が消える | 役の間で渡す形式を契約ファイルに固定し、形式違反は差し戻す |
| 人格ファイルの肥大 | 特例が積もり、元の人格が埋もれる | 400語を上限にし、超えた分は案件ファイルへ移す |
| 定期実行の衝突 | 各役の定期処理が同じ時刻に重なる | 全役の予定を一つのファイルで管理し、時間をずらす |
記憶にも棚卸しが必要です。氏は役ごとに古くなった記録の比率を毎週測り、全体の15%を超えたら整理してから使い続ける運用を勧めています。
ここからは筆者の見立てです。自己改善の仕組みは、書き込む口が開いたまま検査がないと、自己汚染の仕組みへ変わります。教材を渡して覚えさせる使い方も同じ構造で、渡した文章の誤りや、文中に紛れた悪意ある指示が、そのまま手順書へ変わり得る経路です。この危険は抽象論ではなく、次の実行記録で筆者自身が実際に踏みました。
実行記録1 動画一本をスキルへ変えて誤記も写した
以下は2026年8月24日の制作記録です。9月5日の監査時点では、当時の実行用コードと生ログを記事フォルダで確認できませんでした。手順と数値は残された本文記録に基づき、今回の再実行で再現を確認した結果ではありません。
まず、話題の投稿が主張する「動画を書き起こしてエージェントに渡せば技能を覚える」を、そのまま再現しました。環境はmacOS上のClaude Codeです。
書き起こしの取得にGrokのような書き起こしサービスは使っていません。動画サイトから動画や字幕を取得するオープンソースの命令行ツールyt-dlpを、Pythonツールを導入なしで実行できるuvのuvxコマンド経由で動かし、YouTubeの自動字幕を直接取り出しました。X投稿には出典表記がないため、リプライ欄で投稿者が示したチャンネル名から動画を特定しています。3 uvx yt-dlp --skip-download --write-auto-subs --sub-langs en で1本あたり数秒、200KB前後の字幕ファイルが取れ、時刻行と重複行を落とす十数行のPythonスクリプトで600行前後の本文テキストになりました。3本分の取得と整形で10分かかっていません。字幕がない動画の場合は、Whisperなどの音声認識モデルを挟む必要があります。
次に、Hermes解説動画の書き起こし全文をClaude Codeのヘッドレス実行(対話画面を開かず一回の依頼として実行するclaude -p)へ渡し、「この内容だけを根拠に、エージェントへ自己改善ループを組み込む手順書をSKILL.md形式で書く。書き起こしにない事実は書かない」と依頼しました。結果は5,226字の日本語の手順書で、所要は約2分、費用は0.98ドルです。中身は、システムプロンプトのファイル化、ループエンジンと道具群、三種類の記憶の保存先、補助モデルによる蒸留、スキル自動保存の条件と、動画内で観察された不具合まで、章立てで再構成されていました。教材一本が数分で手順書になるという主張は、そのまま成立します。
同時に、汚染経路の実物も観察できました。YouTubeの自動字幕はNous Researchを「neural research」と誤って書き起こしており、生成された手順書にも「Neural Research製」という誤記がそのまま写っていました。「書き起こしにない事実は書かない」という制約を守った結果、誤りまで忠実に引き継がれた形です。教材の誤りは、検査を挟まない限り手順書の誤りになります。
実行記録2 常設指示で手順を保存して再利用した
次に、Hermesの学習ループの核心部分だけを自作して、自己改善が実際に数字へ表れるかを測りました。用意したのは三つです。
- 検証用のダミー社内ツール。認証キー、廃止された出力形式、必須引数という三つの癖を持ち、正しく使わないとエラーコードだけ返すシェルスクリプトです。キーはハッシュ照合にして、スクリプトを読んでも分からないようにしました。
- 文書フォルダ。最新の運用メモに正しいキーがあり、隣に失効したキーが載った旧版も置いて、罠にしました。
- ミニハーネス。Hermesの常設指示に相当する一文「開始前にskillsフォルダを確認し、失敗2回以上か道具呼び出し5回以上の作業の後は、学んだ手順をSKILL.mdへ保存せよ」を付けて、
claude -pで毎回新規セッションとしてタスクを実行し、ターン数、道具呼び出し数、費用を記録するスクリプトです。
タスクは「ツールの仕様書なしで四半期レポートを生成する」です。結果は次のとおりでした。
| 実行 | 条件 | 道具呼び出し | 所要時間 | 費用 |
|---|---|---|---|---|
| 1回目 | スキルなし。初見 | 8回 | 57秒 | 0.453ドル |
| 2回目 | 1回目に常設指示で保存したスキルあり | 6回 | 48秒 | 0.177ドル |
1回目のエージェントは文書フォルダを探索して新旧のメモを読み比べ、正しいキーと形式へたどり着きました。道具呼び出しが8回になったため常設指示の条件を満たし、その回に改めて保存を頼まずに、常設指示に沿ってskills配下へSKILL.mdを保存しています。保存された手順書には、正しいコマンドだけでなく「キーは年次で変わるため、必ず最新版のメモを再確認する」という一般化まで書かれていました。2回目はこのスキルを読んで探索なしで直行し、当時の調査メモに残る費用は0.453ドルから0.177ドルへ減り、削減率は約61%です。これは一つの自作課題を繰り返した結果で、一般的な費用削減率ではありません。道具呼び出しが2回しか減っていないのは、スキル自身が最新メモの再確認を指示しているためで、この慎重さは意図どおりの動きです。
発火しなかった試行も記録しておきます。最初に作った環境は、キーがスクリプト内に平文で書いてあり、エージェントは失敗なしの4ターンで解いてしまいました。この場合、保存条件に届かず、スキルは自発保存されません。Sean氏がHermesの実演で「難しい作業をしていないので、スキルの自己保存はまだ発火していない」と観察したのと同じ挙動が、自作の数十行のハーネスでも再現された形です。自己改善の書き込みは、課題が簡単なうちは起きず、苦労した作業でだけ起きるように閾値が設計されています。
対照実験では失敗もしました。スキルの効果を切り分けるため、skillsフォルダを別名に変えて同じ場所へ残したところ、エージェントは改名したフォルダを探し出して手順書を使い、対照になりませんでした。作業領域の外へ退避してやり直しています。エージェントは手の届く場所にある記憶を何でも使うという小さな実例で、前節のnyk氏が役ごとの分離を強調する理由を、意図せず体験しました。
一連の検証にかかった費用は合計3ドル弱、時間は半日未満です。Hermes本体の導入と長期運用の実測は行っておらず、この記事のHermesに関する記述は公式文書と実演動画で確認できた範囲にとどまります。常駐させた場合の挙動の実測は次の検証課題です。

どこから作り始めるか
自己改善するエージェントの実体は、四つの部品に分解できます。手順と事実の書き込み先、書き込みを起こす契機、変更の良し悪しを測る評価、そして定期的な棚卸しです。今回の再現で分かるとおり、はじめの二つは常設指示の一文と数十行のスクリプトでも動き、HermesやClaude Codeのスキルとメモリ機能なら最初から備わっています。個人利用はそこから始められます。業務への適用では、評価と棚卸しが製品側にほぼなく、自作する部分になります。
最後に残る人の判断は、エージェントが自分自身に加える変更のうち、どれを人の承認に通すかという線引きです。Nous Researchの進化実験が、成績の良い変種にもプルリクエスト審査を必須にしたのは、この線引きへの一つの答えです。書き込みは自動に、取り込みは審査に。この非対称を保てるなら、解説動画を一本渡して技能を足す使い方は、冗談ではなく日常の運用になります。
参照リンク10件
- PA13L0 on XEx ingeniero de Google te enseña como crear agentes de IA que se automejoran solos
- Sean's AI StoriesYou Can Learn Hermes Agent Harness In 20 Min
- Sean's AI StoriesYou Can Learn AI Agent Harness & Loop Engineering In 19 Min
- Qiitaプロンプト・ハーネス・ループエンジニアリングの違いと使い分け
- Findy Team+ループエンジニアリングとは?
- Nous ResearchHermes Agent Documentation
- Nous Researchhermes-agent
- NVIDIA BlogHermes Unlocks Self-Improving AI Agents
- Nous Researchhermes-agent-self-evolution
- nyk on XThe Ultimate Hermes Guide
2026年8月24日時点の公式資料を確認しています。仕様は更新される可能性があります。