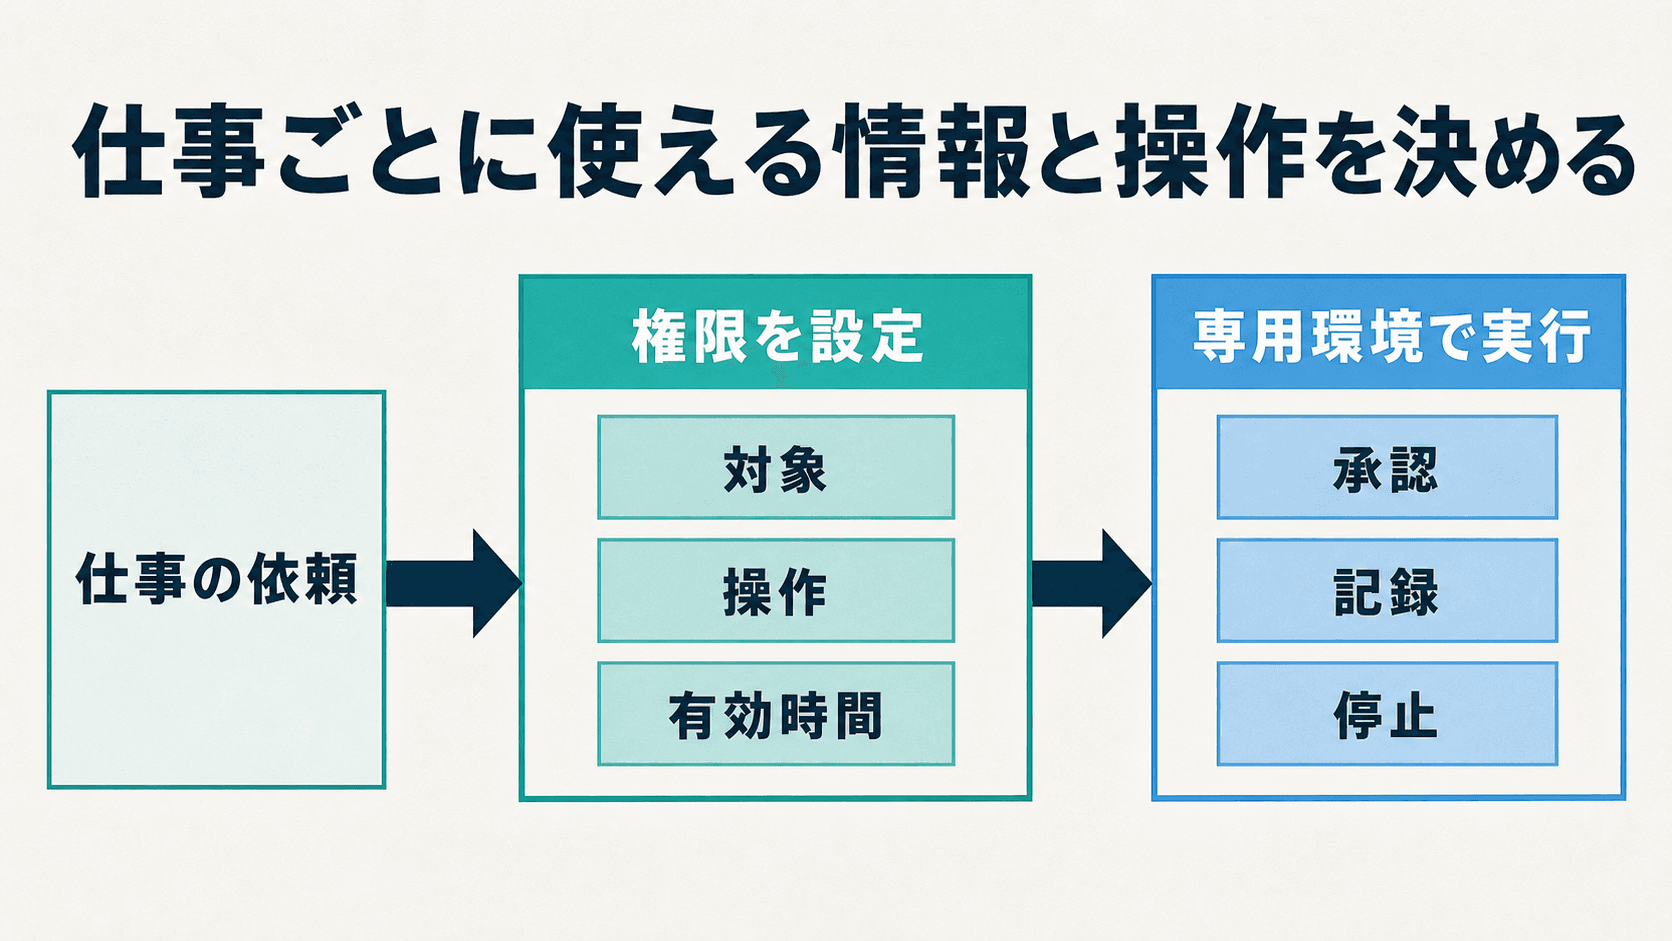
AIエージェントには、仕事ごとに使える情報、実行できる操作、有効時間を限定した権限を与えます。メールや顧客管理などへの接続は仕事を便利にする一方、誤判断や悪意ある指示を実際の操作へ変える力にもなります。この記事では、エージェント固有のID、短期トークン、専用の実行環境、人の承認、記録、緊急停止を組み合わせる方法を説明します。
仕事を任せるほど権限管理が重要になる
AIエージェントにメールの確認、予定の調整、顧客情報の更新、コードの修正まで任せるには、それぞれのサービスへ接続し、情報を読んだり変更したりする権限を渡す必要があります。権限と接続先が増えるほど、人が画面を行き来しなくても一連の仕事を進められるため、エージェントは便利になります。
一方で、その権限は、誤った判断も実際の操作へ変える力です。たとえば、取引先から届いたメールを読み、内容を顧客管理システムへ登録する仕事を任せたとします。メールの本文に悪意ある指示が紛れ込み、エージェントがそれを利用者の依頼だと誤認すれば、関係のない顧客情報を読み出したり、意図しない相手へ送信したりする可能性があります。
権限設計では、触れてよい情報と実行してよい操作を仕事ごとに区切ります。外部への送信や削除などの前で人へ確認し、操作を記録し、異常があれば権限をすぐ取り消せるようにします。これなら仕事を任せる便利さを保ちながら、失敗時の影響を限定できます。
この記事では、危険の大きさを『与えた権限 × 到達できる機密情報 × 信頼できない入力 × 動き続ける時間』として捉えます。まず依頼者、実行するエージェント、データの対象者を区別し、認証情報、外部サービスとの接続、実行環境、承認、記録、停止を一つの流れとして組み立てます。
依頼者 エージェント 対象者を区別する
最初に、仕事を始めた依頼者のID、外部サービスへ接続するエージェントの実行ID、データや操作の対象者のIDを分けます。エージェントの実行IDは、一般にワークロードIDと呼ばれ、人ではないプログラムや実行個体を識別します。共有ボットの名前一つでは、誰の依頼で、どの実行個体が、誰のデータを扱ったのか分かりません。
人間のアクセストークンをエージェントへ共有すると、この三つを区別できません。操作記録には本人が実行したように見えても、実際にはエージェントが行った状態になります。NISTは、利用者とエージェントのIDを結び、誰の代理で何を許可したかを追跡する仕組みを検討課題に挙げています。2026年2月の文書は、今後の実装指針を検討するための草案です。
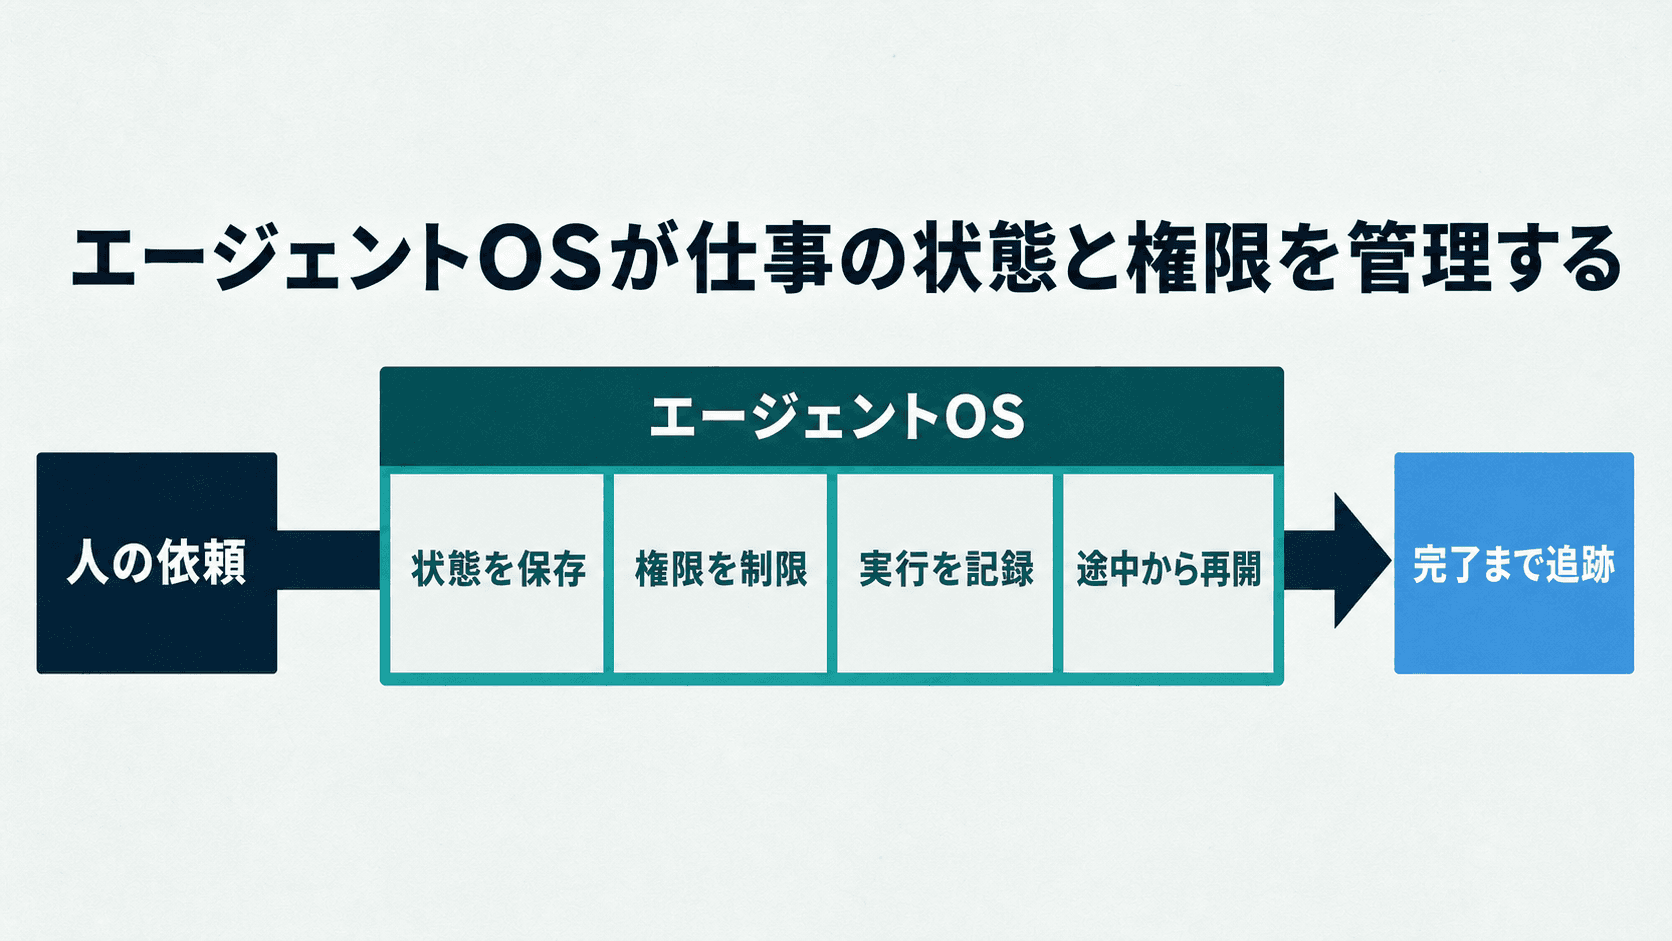
業務エージェントには専用の実行IDを与え、依頼者と承認者を一件の仕事番号へ結び付けます。依頼、権限の発行、ツールの実行、承認、結果、権限の取り消しまで同じ番号で追えることが、後から経緯を説明し、動作を止めるための土台になります。
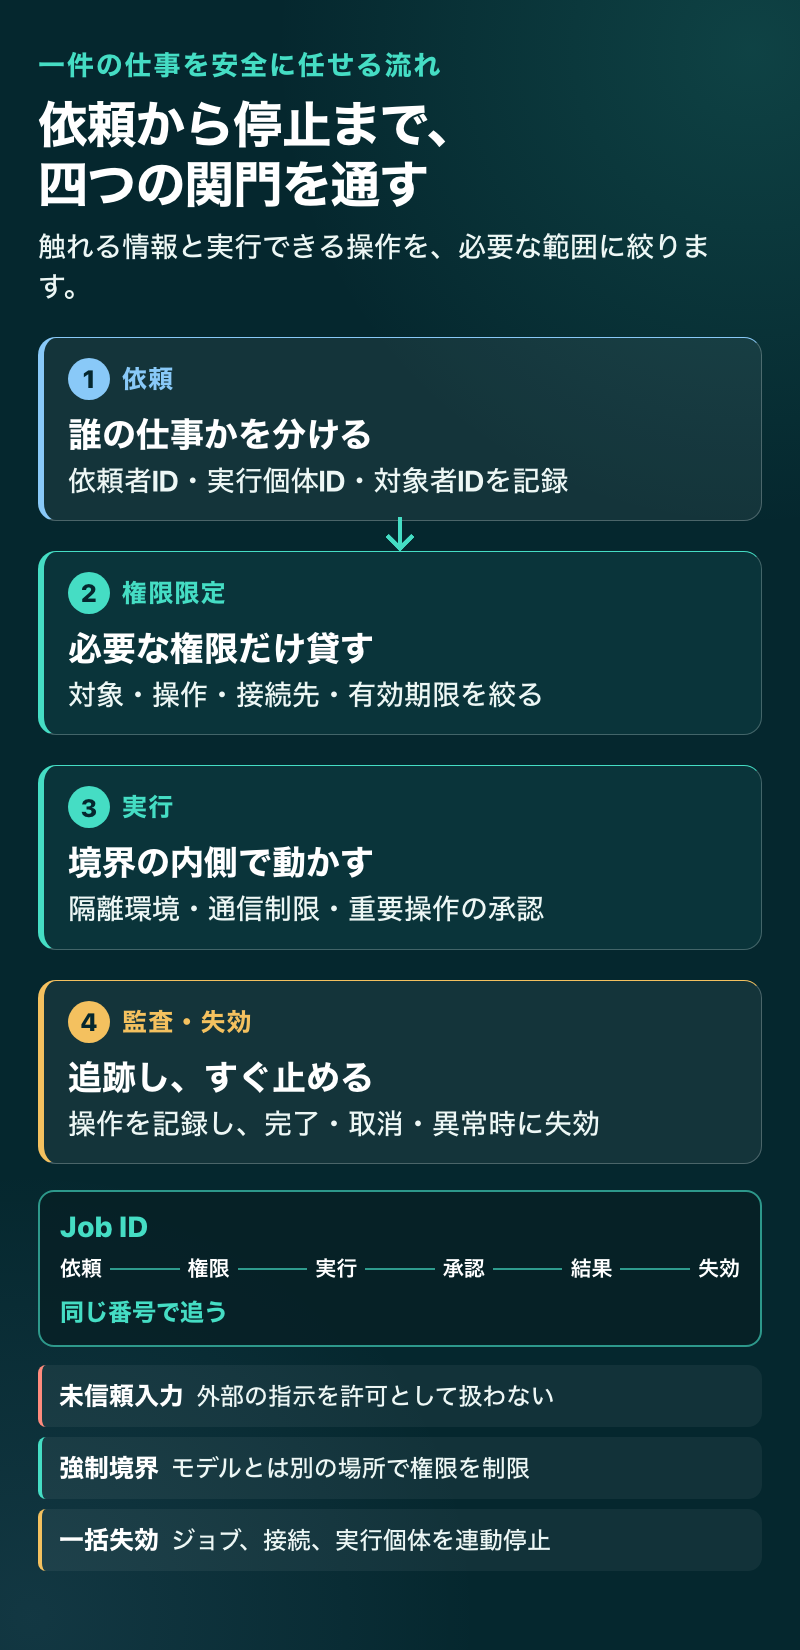
- 依頼者のID:誰が仕事を始め、どの操作を承認できるか
- エージェントの実行ID:どの実行個体が接続しているか
- 対象者のID:誰のデータを、誰の代理で操作するか
短期トークンで操作範囲を限定する
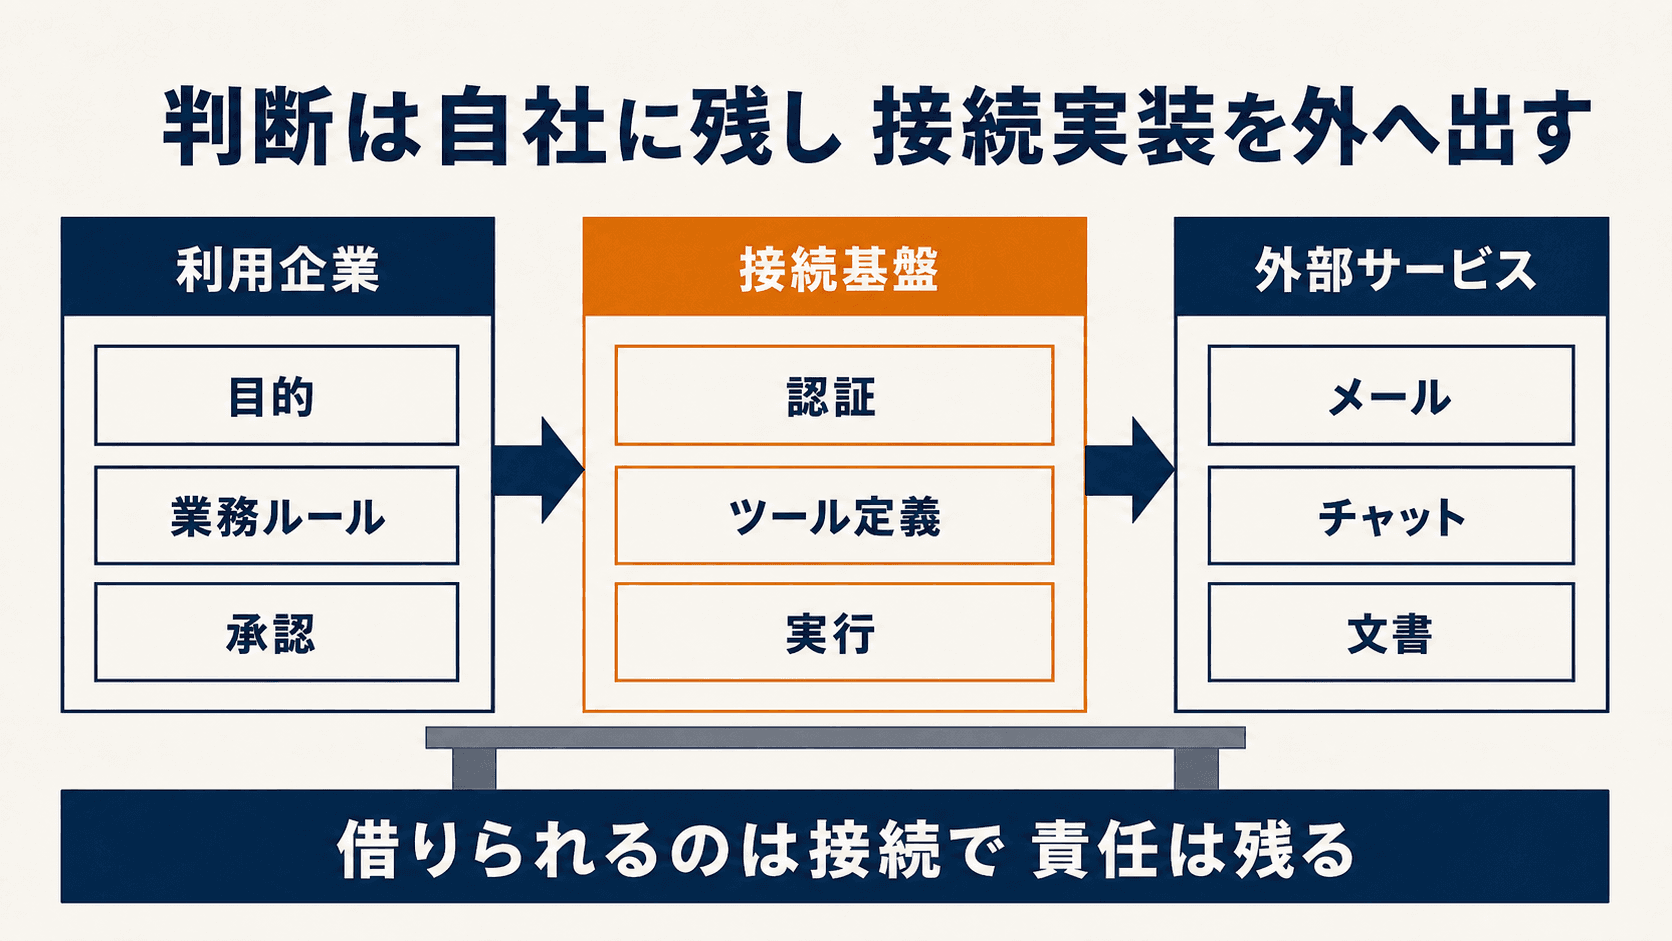
APIキー、SSH鍵、ブラウザのCookie、長期間使える更新トークンは認証情報です。これらをプロンプトや作業フォルダーへ置くと、悪意ある入力や生成コードから読み取られる危険があります。認証情報は専用の保管場所へ置き、モデルがコードを実行する場所から分離します。
エージェントが外部サービスを操作するときは、対象、操作、依頼者、利用先、有効時間を限定した短期アクセストークンを発行します。この仲介役が認証情報ブローカーです。OAuth 2.0のセキュリティ指針は、盗まれたトークンの再利用を抑えるため、利用できる送信元と受け手を限定することを推奨しています。Google CloudやAWSの日本語文書でも、固定キーを埋め込む方法より、有効期間の短い認証情報を動的に発行する方法が案内されています。
たとえばGitHubに対しては、『指定したリポジトリの課題を読む』『承認済みのブランチへ一度だけ書き込む』という単位まで許可を絞る形です。読み取りと書き込みを分け、仕事の終了、承認の取り消し、異常検知に合わせてトークンを使えなくします。攻撃者がモデルをだましても、固定のAPIキーを持ち出せず、許可していない対象を操作できない構成を目指します。
| 条件 | 確認する問い | 例 |
|---|---|---|
| 依頼元 | 誰の依頼をどの実行個体が行うか | 依頼者A/実行個体42 |
| 操作 | 何をしてよいか | 課題の読み取りのみ |
| 対象 | どの情報へ届くか | 指定リポジトリだけ |
| 利用先 | どのサービスだけが受け取るか | 指定MCPサーバー |
| 有効時間 | いつ自動で使えなくなるか | 10分または仕事終了時 |
MCP接続でも操作ごとに許可する
MCPは、外部サービスの機能やデータを共通の形式でエージェントへ接続する規格です。接続設定と、個々の操作を許可する認可は別に管理します。2026年7月28日版の仕様は、アクセストークンを利用先のMCPサーバーへ結び付け、サーバー側で自分向けのトークンか検証するよう定めています。
書き込みなど追加の権限が必要になった時点で、必要な操作範囲だけを利用者へ示し、再度許可を求める仕組みも仕様の一部です。たとえば読み取り用トークンで書き込みを試みた場合、サーバーは不足している権限を返し、利用者が追加許可した後だけ再試行します。追加要求が繰り返されないよう、再試行回数にも上限を設けます。
ツール名が『検索』でも、内部で全顧客のデータベースを検索できれば強い権限です。影響範囲は、実際に読める情報と実行できる操作で評価します。受け取ったトークンは利用先を検証し、下流APIへそのまま転送しません。依頼者、エージェント、対象、ツールの実行、下流操作を同じ仕事番号で追跡します。
- 運営者、配布元、更新物の検証方法を確認する
- Toolごとに読み取り、書き込み、破壊的操作を分ける
- Audience、Scope、有効期限、失効方法を実測する
- ツールの実行と下流操作を同じ仕事番号で結ぶ
ブラウザとCLIを専用環境で動かす
ブラウザはログイン状態、履歴、ダウンロード、クリップボード、保存済みパスワードを持ちます。普段使いのブラウザ設定をエージェントへ渡すと、個人がログインしている複数サービスへまとめて到達できます。エージェント専用のブラウザ設定とアカウントを用意して接続先を限定し、可能なら仕事ごとにブラウザや仮想マシンを破棄します。
OpenAIのコンピューター操作ガイドは、ブラウザや仮想マシンを隔離し、Webページ、PDF、メール、チャット、ツールの出力を信頼できない入力として扱うよう案内しています。購入、ログイン済みサービスでの重要操作、削除などは人の確認対象です。ローカル自動化では、環境変数、拡張機能、ローカルファイルへ不用意に接続させない設定も必要です。
コマンドライン操作では、読める場所、書ける場所、接続できるネットワーク、起動できるプログラム、実行時間をサンドボックスで絞ります。CodexとClaude Codeの公式文書も、操作ごとの許可とOSレベルの隔離を組み合わせています。モデルが誤った判断をしても、技術的に届く範囲を小さく保つことが目的です。
外部へ影響する操作を人が承認する
承認画面には、長いコマンドだけでなく、誰の依頼で、どの対象へ、どの変更を、どの公開範囲で反映するかを表示します。利用者が技術的な引数を読めなくても、業務上の結果を判断できる説明が必要です。
一時ファイルの作成や読み取り専用の検索は自動化できます。公開、外部送信、削除、支払い、権限付与、認証情報への接続は人の承認地点で止めます。金額、対象人数、公開範囲、取り消しの可否、信頼できない情報を読んだ直後かどうかが、承認条件を変える基準です。承認後に対象や引数が変わった場合は、改めて確認します。
確認回数を減らすには、安全な作業領域をサンドボックス内へまとめ、取り消しにくい操作だけを少数の承認地点へ集約します。利用者に示すのは、エージェントの思考過程よりも、外部に起きる具体的な変更です。
- 依頼者と承認者は誰か
- 操作対象と変更前後の差分は何か
- 外部へ送る情報と公開範囲はどこまでか
- 取り消せるか、費用はいくらか
攻撃を受けても到達範囲を広げない
プロンプトインジェクションは、Webページやメールなどに埋め込まれた悪意ある指示を、エージェントが利用者の依頼と取り違える攻撃です。検索結果、課題管理の投稿、README、PDF、MCPツールの出力、ブラウザ内の非表示テキストも入口になります。モデルへの指示だけに頼らず、ツールごとの許可、実行前の承認、サンドボックス、通信先の許可リストを組み合わせます。
テストでは、モデルがだまされるかに加えて、だまされた後にどの情報と操作へ届くかを確認します。信頼できない情報を読むエージェントは読み取り専用にし、機密情報と自由な外部送信を同じ実行環境へ持たせません。外部送信には、接続先と通信方法の許可リスト、送信量の上限、情報漏えい防止機能、人の承認を置きます。
実務での分担は、取得内容を整理する読み取り担当と、外部サービスを変更する書き込み担当です。書き込み担当へ元の文章をそのまま渡さず、許可した項目だけを決められた形式で渡します。攻撃を完全に防げない場合にも備え、侵害後に使える権限、読める機密情報、送信先、動作時間を小さく保ちます。

スキルとプラグインの配布元を管理する
スキルは文章ファイルに見えても、エージェントへコマンド、ブラウザ、MCPの使い方を教える実行指示です。スクリプト、フック、プラグイン、外部URLを含む場合は、一般のソフトウェア部品と同じように配布経路と更新を管理します。説明文が安全でも、後から参照先だけが差し替わる可能性があります。
導入時には、配布元、所有者、版、内容のハッシュ値、要求権限、依存パッケージ、参照する外部URLを台帳へ記録します。ハッシュ値は内容が同一かを確認する短い指紋です。同梱スクリプトを確認し、版とハッシュ値を固定し、更新時には差分を再承認します。使っていないスキルは削除し、エージェントごとに読み込めるものを限定します。
OWASPのAgentic Skills Top 10が別々のリスクとして整理するのは、悪意あるスキル、配布経路の侵害、過剰権限、外部の悪意ある命令、弱い隔離、未確認の更新、管理不足です。2026年時点で更新中の資料ですが、導入時の確認項目として利用できます。変更差分と承認者を記録し、異常時に全環境から無効化できることが重要です。
記録から緊急停止までをつなぐ
一件の仕事について、依頼、使用したエージェントとモデル、スキルと版、参照した外部情報、ツールの実行、操作対象、方針の判定、承認、トークン発行、外部サービスの結果を同じ仕事番号で結びます。APIキーや個人情報はログへ残さず、追跡に使うのはトークンの識別番号やハッシュ値です。『誰がこの公開を承認したか』『なぜこのデータを読めたか』を後から検索できる状態にします。
異常な送信量、新しい宛先、普段と違うツールの組み合わせを検知したら、トークンを使えなくし、実行中の仕事と待ち行列を止め、MCPサーバー、スキル、ブラウザ、エージェントの実行IDをまとめて停止します。緊急停止は文書を作るだけで終えず、実際に止まるかを定期的に試す必要があります。
導入は、依頼者とエージェントのIDを分ける、固定の認証情報を実行環境へ置かない、ブラウザとコマンドラインを隔離する、外部への重要操作を人が承認する、同じ仕事番号で記録してまとめて停止できるようにする、という順で進められます。権限設計の目標は、失敗時の影響を小さくし、発見し、止め、経緯を説明できる状態を作ることです。
参照リンク14件
- NISTAI Agent Standards Initiative
- NIST NCCoESoftware and AI Agent Identity and Authorization — concept paper
- IETFRFC 9700 — Best Current Practice for OAuth 2.0 Security
- Google Cloud 日本語ドキュメントワークロードの ID
- AWS 日本語ドキュメントIAM の一時的な認証情報
- Microsoft Learn 日本語Microsoft Entra エージェント ID での承認
- Model Context ProtocolAuthorization specification
- Model Context ProtocolSecurity best practices
- OpenAIComputer use — safety guidance
- OpenAISandboxing and agent approvals
- AnthropicClaude Code security
- OpenClawGateway security
- AnthropicTrustworthy agents in practice
- OWASPAgentic Skills Top 10
2026年8月17日時点の公式資料を確認しています。仕様は更新される可能性があります。