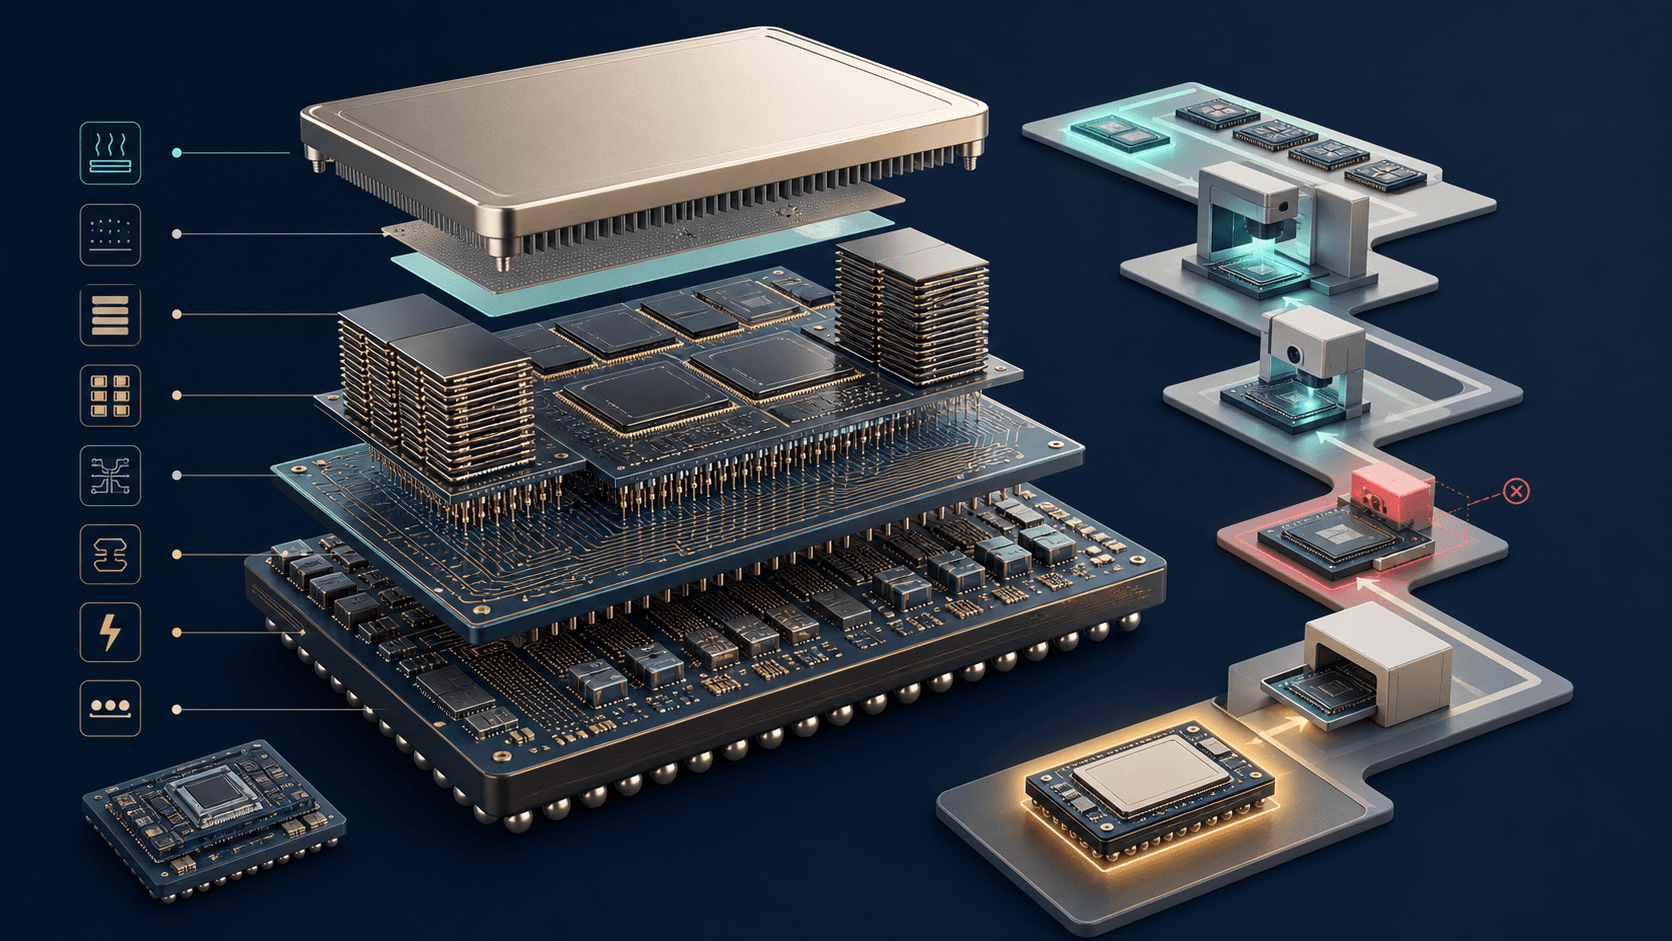
AI基盤の実力は、仕様表の演算性能ではなく、AIモデルがメモリに収まるか、データを演算器へ十分な速さで運べるか、GPU間の通信待ちを隠せるか、そのソフトウェアが最適化されているかで決まります。実際にMetaが公開したLlama 3の学習記録では、16,384基のH100で理論値の4割前後の効率で回っていました。この記事では、仕様表の数字と実測値の距離、詰まりやすい場所、購入前に測るべき値を順に整理します。
仕様表の数字と実際に出る性能の差
GPUの仕様表で最初に目に入るFLOPSは、1秒間に実行できる浮動小数点演算の理論上限です。実際の学習や推論では、AIモデルの重み、計算途中の値である活性値、勾配、過去の文脈を保持するKVキャッシュをメモリから読み出し、GPU間で交換し、計算を順に進めます。演算器へデータが届かない時間は、そのまま待ち時間になります。
距離の大きさは公開値で確かめられます。MetaがLlama 3の技術報告で公開した学習では、16,384基のH100を使い、GPU1基あたりの実測が400〜430TFLOPS、BF16での「モデルFLOPS利用率」が38〜43%でした。これは、AIモデルの計算に必要な演算量を実時間で割った値を理論上限と比べたもので、大規模な学習が理論値の4割前後で動いていることを示します。設定を詰めた結果としてのこの水準を、仕様表の数字と混ぜないことが出発点になります。
数字を比べる前に、条件を揃える必要もあります。FP4の理論値とBF16で動く処理は比較できず、ゼロを省く疎な計算を前提にした数値を、すべての値を計算する密な処理へ当てはめることもできません。標準性能試験のMLPerf Trainingが、単体チップの数字ではなく目標精度に到達するまでの時間を測るのは、この違いを含めるためです。2026年6月のv6.0では、24組織から95システム、13種類のアクセラレータと19種類のホストCPUの結果が出され、6割がマルチノード構成でした。総パラメータ6,710億のうち1トークンあたり370億だけを使うDeepSeek V3のような専門家混合型が加わり、測る対象そのものが変わっています。
演算器が待つ場所 HBMの容量と帯域
HBMは、GPUの近くへ積む高帯域幅メモリです。容量が決めるのは1基へ載せられる重み、KVキャッシュ、一度にまとめて処理する量で、帯域が決めるのは単位時間に演算器へ運べるデータ量です。容量を超えればAIモデルを複数のGPUへ分割する必要が生まれ、通信とソフトウェアの複雑さが増えます。
2026年の製品は、この二つを演算性能と同じ比重で説明しています。NVIDIAはRubin世代で1基あたり最大288GBのHBM4と毎秒22TBの帯域、GPU間接続は双方向で毎秒3.6TBと公表しました。AMDはMI455Xで432GBのHBM4と毎秒23.3TBを掲げ、72基を収めるHelios構成ではHBM4が合計31TB、メモリ帯域が毎秒1.67PBになるとしています。いずれもメーカー公称のピーク値であり、実際の処理では別途検証が必要です。読み取るべきなのは優劣ではなく、両社とも演算だけでは足りないと説明している事実です。
必要量の見積もりでは、重みだけを数えると足りません。推論では同時利用者数と文脈の長さに比例してKVキャッシュが増え、学習では活性値、勾配、最適化処理の状態が加わります。長い文脈を扱う用途では、重みが載っても同時要求数で容量が先に尽きます。NVIDIAがRubin世代でKVキャッシュをフラッシュ側の記憶装置へ退避する仕組みを用意したのも、この制約に対する回答です。
入力を読む段階と1トークンずつ出す段階
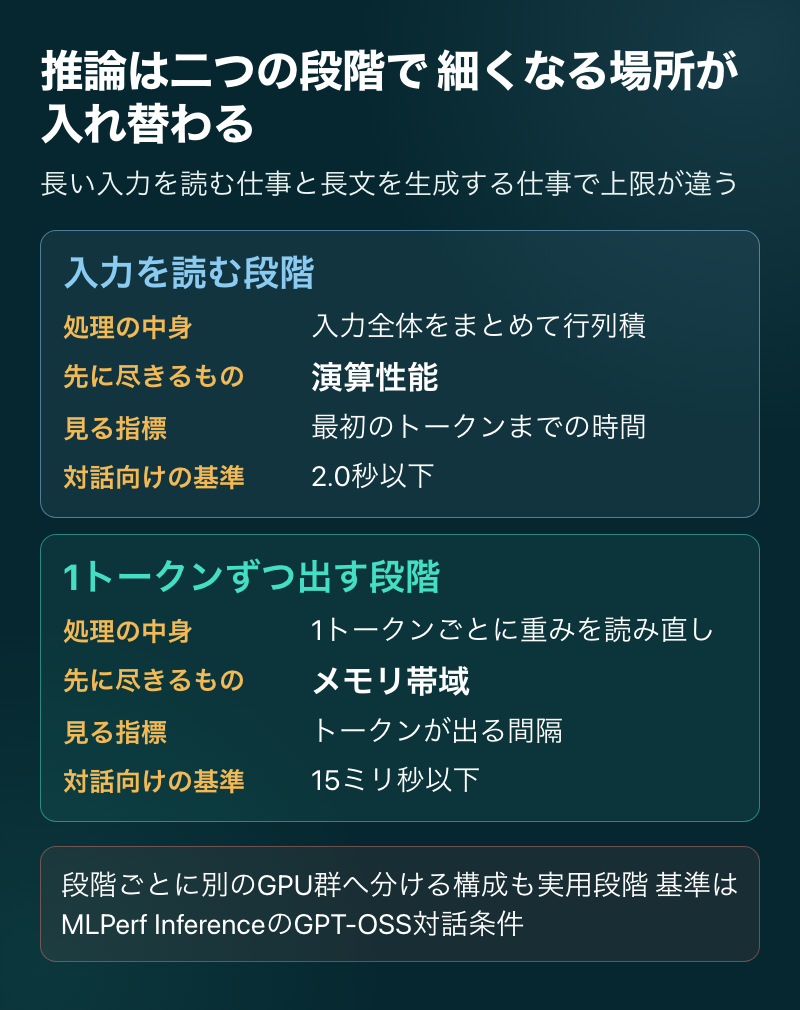
推論の詰まり方は、処理の段階で入れ替わります。入力文を読み込む段階では、大きな行列積がまとまって走るため演算性能が効きます。その後に1トークンずつ生成する段階で効くのは、1トークンごとにAIモデルの重みを読み直すために必要なメモリ帯域です。同じGPUでも、長い入力を要約する仕事と長文を生成する仕事では、細くなる場所が違います。
指標も二つに分かれます。利用者が最初の1文字を見るまでの時間(TTFT)と、その後のトークンが出る間隔(TPOT)です。MLCommonsは2026年のMLPerf Inferenceで、GPT-OSSの対話向け条件を99パーセンタイルでTTFT2.0秒以下かつTPOT15ミリ秒以下、通常のサーバ想定をTTFT3.0秒以下かつTPOT80ミリ秒以下と定義しました。DeepSeek-R1の対話向けはTTFT1.5秒以下かつTPOT15ミリ秒以下です。この厳しさを満たすため、先に複数トークンを予測して検証する投機的デコードが標準実装として初めて認められています。
段階ごとに必要な資源が違うため、実装も分かれ始めました。NVIDIAのDynamoは、入力を読む処理と生成する処理を別のGPU群へ割り当て、KVキャッシュを相手のメモリへ直接書き込む通信方式(RDMA)で転送する構成を提供しています。同じ基盤の中で、演算性能が効く仕事とメモリ帯域が効く仕事を別々に増減させる考え方です。自社の用途がどちらに寄るかで、同じ予算でも選ぶ構成が変わります。
機器内の接続とラック間の接続
複数のGPUを束ねる方法は、距離によって二つに分かれます。機器内で低遅延に結ぶスケールアップと、多数のラックをネットワークで結ぶスケールアウトです。前者ではNVIDIAのNVLink、AMDのInfinity Fabric、公開規格のUALinkが競い、後者ではイーサネットとInfiniBandが使われます。
公称値の定義はそろっていません。NVIDIAは第6世代NVLinkをGPU1基あたり双方向で毎秒3.6TBと表現し、UALink 200G 1.0は1レーン200GT/s、4レーンを1組として送受それぞれ毎秒800Gビットと記述します。UALinkは最大1,024基までを一つの塊として扱い、メモリの読み書きと同じ操作で他のGPUのメモリへ触れる方式を採り、実効で理論値の93%を目標に掲げています。片方向か双方向か、転送速度か有効データ量かを確認せずに並べると、比較そのものが成立しません。
ラックを越える側では、Ultra Ethernet Consortiumが1.0仕様を公開し、通信ライブラリ、転送、混雑制御、安全性までを対象にしています。NVIDIAはRubin世代でGPU1基あたり毎秒1.6TビットのネットワークカードをGPUと組み合わせます。通信量の形も変わりました。学習では勾配を集約するAll-reduceが中心でしたが、専門家混合型では入力を担当の専門家へ配り直すAll-to-allが主役になります。MLPerfが専門家混合型を追加した背景には、この通信の変化があります。
利用率を決めるソフトウェア
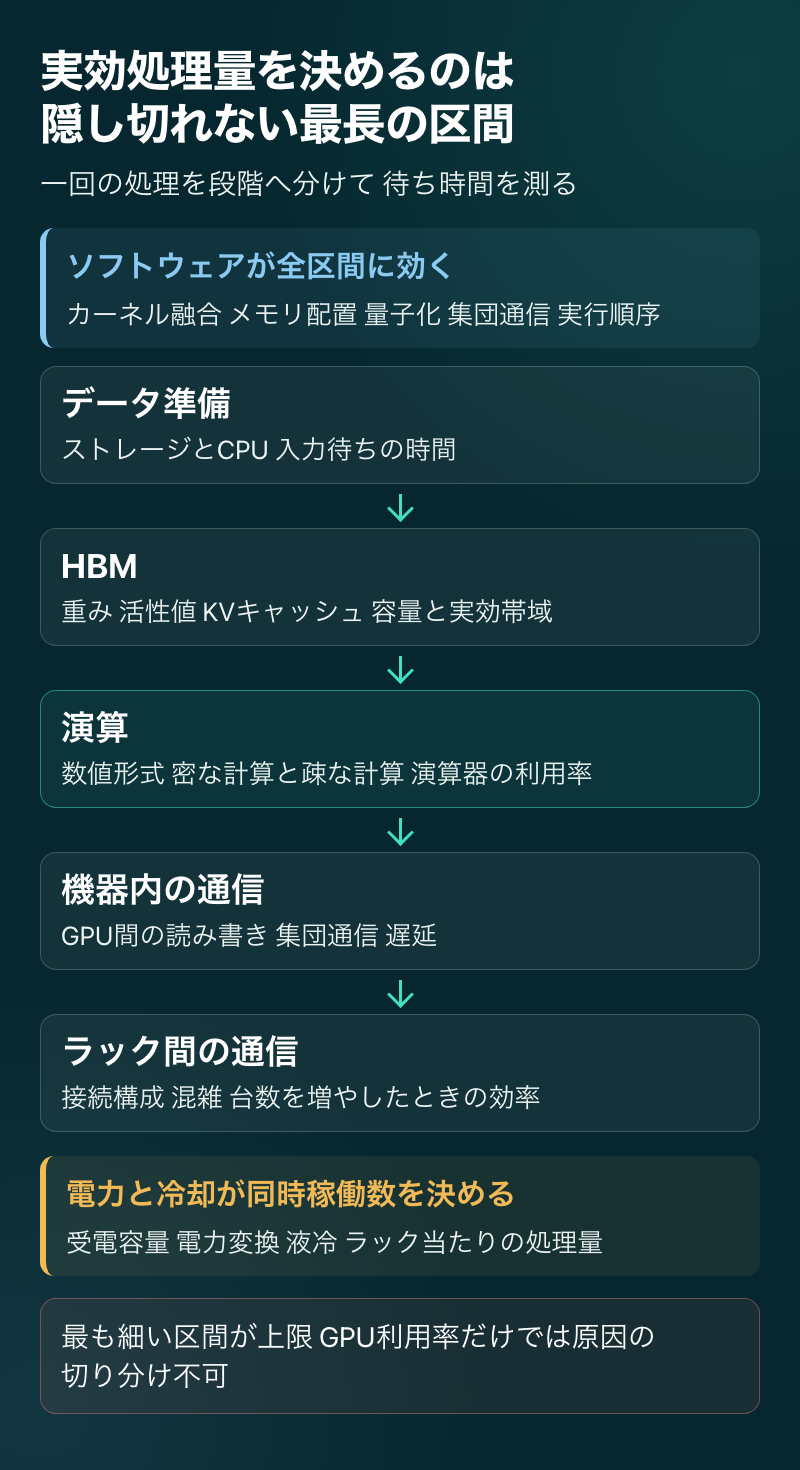
同じ演算器でも、実効性能はソフトウェアで変わります。複数の計算をまとめるカーネル融合、メモリ配置、量子化、コンパイラ、通信と演算の重ね合わせ、実行順序を決めるスケジューラが、演算器の待ち時間を増やしも減らしもします。NVIDIAのCUDA向け解説がメモリ配置と複数GPU通信を中心に据えているのは、この領域が性能の実体だからです。
評価では、動くかどうかの確認では足りません。自社のAIモデルが使う演算が最適化済みか、遅い代替経路へ落ちていないか、集団通信ライブラリが実際の接続構成を生かせるか、プロファイラで詰まりを特定できるか、ドライバとコンテナの組み合わせを再現できるかまで見ます。AMDもMI400世代の説明で、ROCmと集団通信ライブラリのRCCL、KVキャッシュの最適化、通信と演算の重ね合わせを、ハードウェアと同じ価値として並べています。
移植と運用の工数は費用です。ハードウェアの購入額だけを予算化し、演算の書き換え、性能検証、監視、障害対応の人件費を外すと、総保有費用を必ず過小評価します。比較の段階で、モデルFLOPS利用率のような共通の物差しを一つ決めておくと、移植先の評価が早くなります。
一回の処理が通る経路と最も細い区間
一回の処理を、データ準備、HBMの読み書き、演算、機器内通信、ラック間通信、同期に分けて測ります。重ねて実行できる部分もありますが、隠し切れない最長の区間が処理時間を決めます。GPU利用率が低いという観測だけでは、GPUが遅いのか、データが届いていないのかを区別できません。入力の読み込み、CPU、ストレージ、ネットワーク、同期待ちを同時に測ります。
計算資源は、この経路をまとめて設計します。産業技術総合研究所のABCI 3.0が公開する構成は、H200を8基積んだ計算ノード766台、GPUで6,128基、共有ファイルシステムとオブジェクトストレージで75PB、これらを結ぶInfiniBandです。GPUの台数だけでなく、保存と通信を同じ設計の中で示すのが、実際に動かす側の書き方です。
24時間動かして分かる実効性能
長時間の運転では、故障と復旧が実効性能そのものになります。MetaがLlama 3 405Bの学習で公開した記録では、54日間に466回の中断が起き、47回が計画的な保守、419回が想定外でした。想定外のうち約78%がハードウェア起因で、GPU関連が58.7%を占めます。内訳はGPU本体が148件、HBM3メモリが72件、ネットワークの機器と配線が35件です。それでも有効学習時間は90%を超えており、この水準は自動復旧の仕組みとセットで達成されています。
壊れずに遅いだけの1台も問題になります。同報告は、機能はするが遅い1基が数千基を待たせる現象を挙げ、疑わしい通信を絞り込む道具を作ったと説明しています。環境の影響も測定されており、昼間の気温上昇による動作周波数の低下で、処理量が1日の中で1〜2%変動しました。さらに、数万基が同時に電力を上下させることで、データセンター全体では数十MW規模の瞬時変動が起きたと記録されています。GPUの選定が、そのまま受電と冷却の設計に跳ね返る例です。
保存と復旧の設計も速度に直結します。同じ報告では、GPU1基あたり1MBから4GBの状態を保存し、7,500台のサーバで構成した240PBのストレージが持続毎秒2TB、ピーク毎秒7TBを支えたとされています。保存の間隔を詰めれば失う計算は減る一方で保存中の停止時間が増えるため、復旧までの時間、保存の頻度、再開の速さを合わせて測らなければ、実効性能は見積もれません。
購入前に固定する条件と測る値
第一に、学習か推論か、AIモデル、数値形式、文脈の長さ、一度にまとめて処理する量、目標品質、応答時間の目標を固定します。第二に確認するのは、計算した必要メモリ量が1基または1台へ収まるかです。第三に、1基、8基、64基と台数を変えて測り、通信と同期の待ちが増える地点を見つけます。
第四に、プロファイラで演算、HBM、機器内通信、ラック間通信、入力待ち、遊休時間の割合を分けます。第五に測るのは、24時間以上の連続運転での処理量、95パーセンタイルの応答時間、消費電力、エラー、復旧時間です。第六に、ドライバ、AI開発基盤、演算の書き換え、コンテナ、監視、保守の工数を総保有費用へ入れます。
競争の場は、単体チップからシステム全体へ移っています。HBM、GPU間接続、ネットワーク、ソフトウェア、電力と冷却のどれか一つが細ければ、残りの理論性能は使い切れません。最も良いGPUは、仕様表で最大の数字を持つ製品ではなく、自分の処理を目標時間内に、再現可能に、低い総費用で終えられるシステムです。
| 層 | 固定する条件 | 測る値 |
|---|---|---|
| 処理内容 | AIモデル 数値形式 目標品質 応答時間の目標 | 所要時間 毎秒のトークン数 |
| メモリ | 一括処理量 文脈長 分割方法 | 容量 実効帯域 メモリ不足の発生 |
| 通信 | GPU台数 接続構成 集団通信の種類 | 台数増加時の効率 遅延 |
| 運用 | ソフトウェアの版 連続運転時間 | 消費電力 エラー 復旧時間 総保有費用 |
参照リンク17件
- MLCommonsMLPerf Training v6.0 Results
- MLCommonsMLPerf Training
- MLCommonsA new GPT-OSS benchmark and DeepSeek R1 updates for latency-optimized reasoning
- Meta AIThe Llama 3 Herd of Models
- NVIDIAInside the NVIDIA Vera Rubin Platform
- NVIDIANVIDIA Vera Rubin Platform
- NVIDIANVLink and NVLink Switch
- NVIDIADynamo — Disaggregated Serving
- NVIDIACUDA Programming Guide
- NVIDIAProgramming Systems with Multiple GPUs
- AMDAMD Instinct MI400 Series GPUs
- AMDAMD Instinct MI455X GPU Datasheet
- AMDAMD Helios Rackscale Solution
- UALink ConsortiumIntroducing UALink 200G 1.0 Specification
- Ultra Ethernet ConsortiumUltra Ethernet Specification 1.0
- 産業技術総合研究所ABCI 3.0 計算資源
- 富士通研究所LLM推論性能モデリング
2026年8月19日時点の公式資料を確認しています。仕様は更新される可能性があります。