2026年9月6日時点の公表料金では、L4を1基10時間借りる計算料金は4.90ドル(約735円)から、H100を8基なら239.20ドル(約35,880円)からです。AWS・Google Cloud・AzureとLambda・Runpod・Civoの料金を、CPUとサーバー側メモリを含むサーバー一式の単価で並べました。動かすモデルに要るGPUメモリと基数、確保する時間が決まれば、GPU1基と8基の表から借り先を絞り、1ドル=150円の参考円で試用予算を出せます。
まずはGPU付きサーバー一式の料金から
公開されているAIモデルを自社で試すとき、手元のパソコンで動かなければ、GPU付きのサーバーをクラウドから時間貸しで借ります。開発担当が管理画面でGPUとサーバーの構成を選び、借りた環境へモデルやプログラムを置くと、文章への回答や画像生成を実行できます。
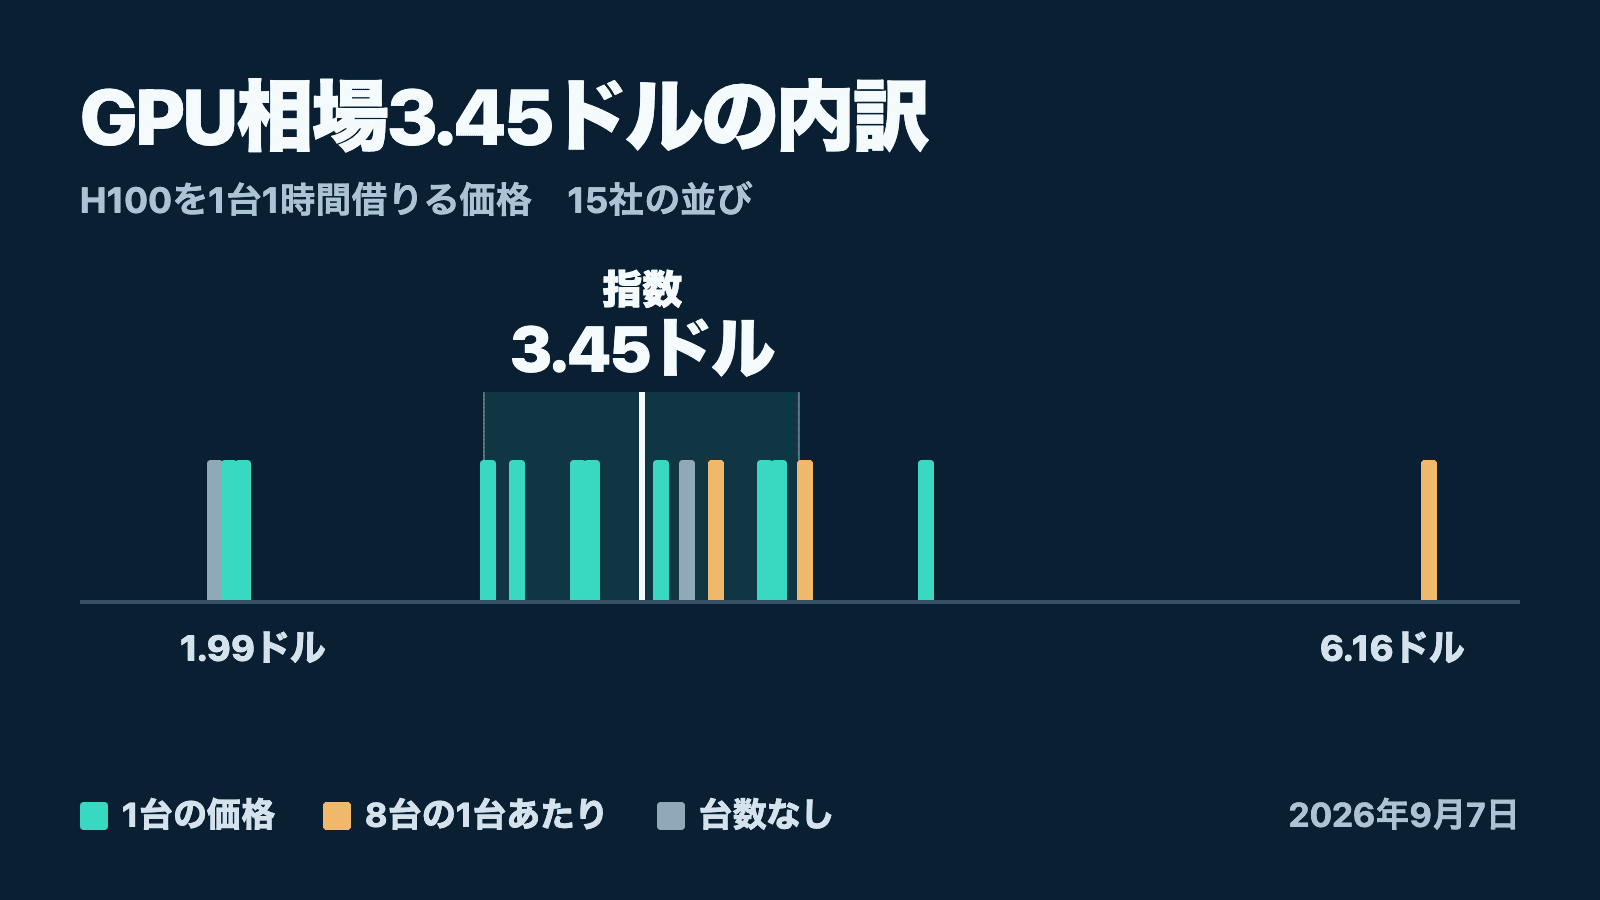
かかる費用は借り先で大きく変わります。専用メモリ80GBのH100を1基使う構成なら、公表料金は1時間2.99ドル(約449円)から6.88ドル(約1,032円)まで開き、10時間確保したときの計算料金は約4,500円と約1万円に分かれます。試用を始める前に決めるのは、必要なGPUの種類と基数、確保する時間、そして借り先です。
GPUはAIの計算を担う部品で、モデルを載せる専用メモリを持っています。ただし、動かすにはプログラムを実行するCPUやサーバー側のメモリも必要です。クラウドでは、この組み合わせを「インスタンス」や「仮想マシン」として選びます。料金表の数字がGPUだけの追加料金なのか、サーバー一式なのかを取り違えると、試用費が予想より膨らみます。
以下はAmazonのAWS、GoogleのGoogle Cloud(GCP)、MicrosoftのAzureで借りる仮想マシンと、GPUの時間貸しを提供するLambda、Runpod、Civoの比較です。表の「一式」は、記載した数のGPUとCPU、サーバー側メモリを含む1つの計算環境を指し、保存領域、通信、税は後から確認します。RunpodのPodsは、GPU付き環境でプログラムを動かすコンテナ方式で、基本ソフト(OS)の管理範囲は仮想マシンと異なります。
比較条件は2026年9月6日確認の米ドル建て公表料金、Linux環境、長期契約のない通常の従量課金です。掲載額はこの日の記録で、その後の価格改定を自動で反映する表ではありません。途中で回収されることのある割安なスポット料金や、企業ごとの値引きは含めていません。
AWSは米国東部のバージニア北部(us-east-1)、GCPは米国中部のアイオワ(us-central1)、Azureは米国東部(East US)を基準にしました。専門3社は地域を指定しない公開料金表の値です。日本の料金や、希望地域で実際に借りられる価格は別に確認する必要があります。
GPUの性能は容量と処理の種類から選ぶ
GPUは、モデルがメモリに収まることを確かめ、求める回答速度や処理量に合わせて選びます。小型モデルを1人で試す仕事と、多人数へ同時に回答したりモデルを学習したりする仕事では、必要な性能が変わるためです。
モデルが入る容量とデータを読む速さ
GPUのメモリ容量は、載せられるモデルの大きさを左右します。たとえば70億個の学習済みの数値を16ビットで保存する単純計算なら、モデルの重みだけで約14GBです。文章生成には、過去の入力に対応する計算結果を保持する領域なども必要になります。長い文章や複数人の同時利用を想定するなら、重みが収まるだけで容量を決めず、使うモデルの動作条件を確認してください。
一方、メモリ帯域は、GPUが専用メモリのデータを読み書きする速さです。単位のGB/sは1秒あたりの転送量を表し、インターネット回線の速度とは別の値です。文章を少しずつ生成する際など、データの読み出しが処理を待たせる場面では、この帯域が効いてきます。
下表はNVIDIAの公表仕様と、そこから考えられる試用候補の目安です。帯域の数値はクラウドで測った実効値ではありません。名前に付くSXMとPCIeは取り付け・接続方式を区別する呼び名です。容量の条件を満たす候補から、用途に近い行を見てください。
表は横にスクロールできます
| GPU | 1基の容量 | メモリ帯域(GB/s) | 候補にする場面 |
|---|---|---|---|
| T4 | 16GB | 最大320 | 小型モデルを低い時間料金で試す |
| A10G | 24GB | 600 | 16GBでは足りないモデルや画像生成を試す |
| L4 | 24GB | 300 | 24GB内の回答生成や動画処理を試す |
| L40S | 48GB | 864 | 24GBで容量が不足する画像生成・推論を試す |
| A100 40GB | 40GB | 1,555 | 学習や大きめのモデルの回答生成を試す |
| A100 80GB | 80GB | 1,935〜2,039 | 40GBを超える容量が必要な学習・推論を試す |
| H100 SXM | 80GB | 3,350 | 大量の回答生成や複数GPUを使う学習を検討する |
| H100 NVL | 94GB | 3,900 | 80GBでは容量が足りない推論を検討する |
| B200 SXM6 | 180GB | 最大8,000 | より大きなモデルを1基で扱う学習・推論を検討する |
A100 80GBの帯域はPCIe版が1,935GB/s、SXM版が2,039GB/sです。同じ24GBでも、A10Gの600GB/sに対してL4は300GB/s。新しい世代へ替えればデータの読み出しも必ず速くなる、という選び方はできません。また、帯域が2倍でも回答速度が2倍になるわけではなく、計算能力や使うソフトウェアも処理時間に影響します。
画像生成や学習では計算機能も確認
演算面では、数値を少ないビット数で扱う機能にも差があります。A10GとA100が使える16ビット形式のFP16・BF16に加え、L4・L40S・H100では8ビット形式のFP8も使えます。B200世代は4ビットのNVFP4にも対応します。
対応するモデルと実行ソフトを使えば、計算を速めたり必要なメモリを減らしたりできる場合がありますが、出力品質が保たれるかも確認が必要です。
画像生成や学習、多数の入力をまとめる処理では、GPUの演算能力も選ぶ基準です。使うソフトウェアの対応GPUと計算形式を先に調べ、その機能を利用できる構成で試します。仕様表の性能値は計算形式や測定条件によって変わるため、条件が違う数値を割り算しても、自分の処理の速度比にはなりません。
GPU1基で試すならGPUメモリと10時間の予算を照合
必要なGPU専用メモリに収まるモデルなら、1基構成から試用費を見積もれます。最初に使いたいモデルの動作条件を調べ、足りるメモリ容量の行を残してください。メモリが同じ容量でも、GPUの種類が違えば計算速度は変わります。
料金表は米ドルと参考円を並べ、円は1ドル=150円で換算しています。現在の為替相場を示すレートではありません。米ドルは1時間を小数第4位、10時間を小数第2位まで表示し、円は丸める前の米ドルから計算して円未満を四捨五入しました。追加の保存費用、通信、税は含めず、実際の円請求は決済時のレートや手数料でも変わります。
表は横にスクロールできます
| 借り先と構成 | GPUと1基の専用メモリ | 一式・1時間 | 一式・10時間 |
|---|---|---|---|
AWS g4dn.xlarge | T4/16GB | $0.526 / ¥79 | $5.26 / ¥789 |
AWS g5.xlarge | A10G/24GB | $1.006 / ¥151 | $10.06 / ¥1,509 |
AWS g6.xlarge | L4/24GB | $0.8048 / ¥121 | $8.05 / ¥1,207 |
AWS g6e.xlarge | L40S/48GB | $1.861 / ¥279 | $18.61 / ¥2,792 |
GCP g2-standard-4 | L4/24GB | $0.7068 / ¥106 | $7.07 / ¥1,060 |
Azure Standard_NC4as_T4_v3 | T4/16GB | $0.526 / ¥79 | $5.26 / ¥789 |
| Runpod Pods Secure Cloud | L4/24GB | $0.49 / ¥74 | $4.90 / ¥735 |
| Runpod Pods Secure Cloud | L40S/48GB | $0.99 / ¥149 | $9.90 / ¥1,485 |
L4を1基、10時間確保する計算料金は、掲載したRunpodで4.90ドル(約735円)、GCPで約7.07ドル(約1,060円)、AWSで約8.05ドル(約1,207円)です。ただし付属するCPUとメモリは同一ではなく、たとえばAWSとGCPの上記L4構成は4仮想CPU・16GiBメモリ、Runpodの公表構成は12仮想CPU・50GBメモリです。使うプログラムの条件が合う候補同士で比べてください。
画像の読み込みや前処理に時間がかかる仕事では、CPU数やサーバー側メモリも見積もり条件に入れます。同じGPUでも、データの準備が追いつかなければGPUの処理を待たせることになります。
GCPでT4を追加する場合は、料金を足す手順が必要です。アイオワの n1-standard-4 はCPUとメモリの部分が1時間約0.19ドル、T4の追加が0.35ドルなので、合計は約0.54ドル(約81円)です。GPU料金表の0.35ドルだけを予算に入れると、サーバーの部分が抜けます。
また、Azureの Standard_NV12ads_A10_v5 はA10の3分の1を使う構成で、GPU専用メモリは8GBです。製品名にA10があっても、24GBのGPUを丸ごと1基借りる構成とは区別します。Runpodは複数の料金区分を持つため、データセンター型の「Secure Cloud」にあるPodsの通常料金で比較します。
A100やH100は容量と型番まで合わせて比較
大きなモデルや学習用のプログラムを試すなら、40GB以上の専用メモリを持つ構成が候補になります。A100には40GBと80GBがあり、H100にも形態や容量の違いがあります。GPU名だけで同じ区分にすると、動かせる条件まで同じだと思い込みやすくなります。
A100を1基使う構成
表は横にスクロールできます
| 借り先と構成 | GPUと1基の専用メモリ | 一式・1時間 | 一式・10時間 |
|---|---|---|---|
GCP a2-highgpu-1g | A100/40GB | $3.6734 / ¥551 | $36.73 / ¥5,510 |
GCP a2-ultragpu-1g | A100/80GB | $5.0688 / ¥760 | $50.69 / ¥7,603 |
Azure Standard_NC24ads_A100_v4 | A100 PCIe/80GB | $3.673 / ¥551 | $36.73 / ¥5,510 |
| Runpod Pods Secure Cloud | A100 PCIe/80GB | $1.39 / ¥209 | $13.90 / ¥2,085 |
| Civo Small | A100/40GB | $1.09 / ¥164 | $10.90 / ¥1,635 |
| Civo Small | A100/80GB | $1.79 / ¥269 | $17.90 / ¥2,685 |
A100の40GBで足りるか、80GBが必要かを先に分けると、候補を減らせます。表の差にはGPUの実装形態、CPU、サーバー側メモリなどの違いも含まれます。
H100を1基使う構成
表は横にスクロールできます
| 借り先と構成 | GPUと1基の専用メモリ | 一式・1時間 | 一式・10時間 |
|---|---|---|---|
AWS p5.4xlarge | H100/80GB | $6.88 / ¥1,032 | $68.80 / ¥10,320 |
Azure Standard_NC40ads_H100_v5 | H100 NVL/94GB | $6.98 / ¥1,047 | $69.80 / ¥10,470 |
| Lambda 1x | H100 SXM/80GB | $4.29 / ¥644 | $42.90 / ¥6,435 |
| Runpod Pods Secure Cloud | H100 SXM/80GB | $3.29 / ¥494 | $32.90 / ¥4,935 |
| Civo Small | H100 SXM/80GB | $2.99 / ¥449 | $29.90 / ¥4,485 |
H100も構成ごとに容量が異なります。Azureの1基構成はH100 NVLの94GB、LambdaやCivoのH100 SXMは80GBです。数字を安い順に並べる前に、動かすモデルが必要とする容量と構成が合うかを見ます。
B200を1基で借りる例もあります。LambdaのB200 SXM6は専用メモリ180GBで、一式1時間6.99ドル(約1,049円)、10時間なら69.90ドル(約10,485円)です。新しい世代ほど自分の処理に割安かどうかは、実際の実行時間で変わります。
GCPのH100を1基で使う a3-highgpu-1g は、スポットか、空きができた時点で起動するFlex-startでの利用が必要です。通常の従量課金だけで比較する今回の1基表には入れていません。GCPで通常の従量課金のH100を検討する場合は、次の8基構成が対象になります。
GPU8基構成は一式の時間料金で予算化
複数GPUにモデルや計算を分ける仕事では、8基構成の一式料金を見ます。1基あたりへ割った値は単価の比較には便利ですが、その値で1基だけ契約できるとは限りません。
表は横にスクロールできます
| 借り先と構成 | GPU構成と1基の専用メモリ | 一式・1時間 | 一式・10時間 |
|---|---|---|---|
AWS p4d.24xlarge | A100×8基/40GB | $21.9576 / ¥3,294 | $219.58 / ¥32,936 |
AWS p5.48xlarge | H100×8基/80GB | $55.04 / ¥8,256 | $550.40 / ¥82,560 |
GCP a3-highgpu-8g | H100 SXM×8基/80GB | $88.49 / ¥13,274 | $884.90 / ¥132,735 |
Azure Standard_ND96isr_H100_v5 | H100×8基/80GB | $98.32 / ¥14,748 | $983.20 / ¥147,480 |
| Lambda 8x | H100 SXM×8基/80GB | $31.92 / ¥4,788 | $319.20 / ¥47,880 |
| Civo Extra Large | H100 SXM×8基/80GB | $23.92 / ¥3,588 | $239.20 / ¥35,880 |
Lambdaの8基構成は1基あたり3.99ドルでも、1時間の一式は31.92ドル(約4,788円)、10時間なら319.20ドル(約47,880円)です。1基で足りる試用なら、前の表にある1基構成の42.90ドル(約6,435円)と比べることになります。AWSのH100も、8基構成の p5.48xlarge と1基構成の p5.4xlarge を別々に選べます。
GPU8基のメモリは、各GPUに分かれています。80GBのH100を8基借りると合計640GBですが、大きなモデルを載せるには、使うソフトウェアがモデルを複数GPUへ分ける処理に対応している必要があります。GPU数を増やすだけで、1基と同じ使い方のまま容量や速度が8倍になるとは考えないでください。
GPU同士で頻繁にデータをやり取りする学習では、GPU間を高速につなぐNVLinkなどの接続も確認します。たとえばL40SはNVLink非対応で、H100 SXMをNVLinkで接続した構成とは通信条件が異なります。8基が必要な仕事では、GPU同士の接続に加え、サーバー間通信やデータを読み出す速さまで候補を照合してください。
日本で動かすなら同じ構成を日本の料金で確認
日本国内にデータを置く必要がある仕事では、国内の地域を選んで見積もります。米国の料金で予算を通し、起動時に東京や東日本へ変えると、同じ構成名でも計算料金が変わります。
表は横にスクロールできます
| 同じ構成 | 米国の一式・1時間 | 日本の一式・1時間 | 日本の地域 |
|---|---|---|---|
GCP g2-standard-4 | $0.7068 / ¥106 | $0.9077 / ¥136 | 東京(asia-northeast1) |
Azure Standard_NC4as_T4_v3 | $0.526 / ¥79 | $0.71 / ¥107 | 東日本(Japan East) |
Azure Standard_NC40ads_H100_v5 | $6.98 / ¥1,047 | $10.121 / ¥1,518 | 東日本(Japan East) |
料金表に載っていることと、今すぐ起動できることは別です。GPUの空きに加え、アカウントで使えるGPUの上限や、その地域での提供状況も申し込み前に確認してください。専門クラウドの公開料金も、希望地域で同じ条件を選べるかまで確認して候補に残します。
保存費用と停止条件を足して見積もりを完成
予算に入れる時間は、AIが計算している時間に加え、環境を準備したり結果を確認したりしながらサーバーを確保している時間です。プログラムが終わっていても、借りた計算環境が課金対象の状態なら料金が続きます。
見積もりは「一式の時間料金×確保する時間」に、追加の保存領域、通信、有料ソフトウェア、税を加えて作ります。付属のローカル保存領域がある構成でも、終了後にデータを残す保存サービスは別契約になる場合があります。円で予算化するなら、社内で使う換算レートも添えてください。
Runpodの保存用Volume diskは、稼働中が1GBあたり月0.10ドル、停止中が月0.20ドルです。100GBを停止したまま1か月残すなら、保存分だけで20ドル(約3,000円)になります。計算環境を止めても、保存費用がなくなるわけではありません。
表は横にスクロールできます
| 借り先 | 計算料金を止めるときに見る状態 | 別に確認する費用 |
|---|---|---|
| AWS | インスタンスの停止 | 残したEBSディスクやIPアドレス |
| GCP | 仮想マシンの停止 | 残した永続ディスクなど |
| Azure | 「停止済み(割り当て解除)」 | ディスクやネットワークなど |
| Lambda | 必要なデータを退避してインスタンスを終了・削除 | 別途契約したファイル保存領域 |
| Runpod | Podの停止 | 残した保存用ディスクや共有保存領域 |
| Civo | 必要なデータを退避してインスタンスを削除 | 残したボリュームやスナップショット |
Azureでは、資源を確保したままの「停止済み」では計算料金が続きます。「割り当て解除」まで確認してください。Civoも、停止しただけでは計算料金が続き、不要になったインスタンスの削除が必要です。停止後にデータを残せるかも保存方式で異なるため、必要な結果を取り出してから環境を終了します。
候補を選んだ後は同じ処理の完了費用へ
借り先を決める最後の比較は、目的の処理を終えるまでにいくらかかるかです。仮に時間料金が半分でも、処理に3倍の時間がかかれば、計算料金は1.5倍になります。今回の表は公表料金の比較で、GPUの速度や実請求額を測ったものではありません。
候補を選ぶときは、既存の会社アカウントとデータをそのまま使える候補と、新しく契約する候補を残し、同じモデル、同じ入力、同じ出力条件で小さく試します。文章生成なら、最初の文字が出るまでと回答全体が終わるまでの時間を分け、同時利用者数も揃えてください。画像生成なら、同じ画像サイズと生成枚数で所要時間を比べます。
移動させるデータ量や環境を整える作業まで含めると、時間単価が安い候補を選ぶ理由があるか判断できます。
開発担当へ見積もりを頼むなら、「モデル名、必要なGPUメモリ、GPU数、地域、確保する時間」を渡し、一式の計算料金と追加費用を分けて返してもらってください。試用予算で動かせる候補が決まった後に、継続契約やスポットの割引が仕事の条件に合うかを検討できます。
参照リンク31件
- Civo停止した環境の課金と請求条件
- Civoインスタンスの削除とデータの退避
- Amazon Web ServicesEC2 オンデマンド料金
- Amazon Web ServicesGPU搭載インスタンスの仕様
- Google Cloudアクセラレータ最適化VMの料金
- Google Cloud追加GPUの料金
- Google Cloud汎用VMの料金
- Google CloudGPU搭載マシンの仕様と利用条件
- Microsoft AzureGPU構成の公式小売料金データ
- Microsoft AzureGPU対応VMのサイズと各シリーズの仕様
- LambdaGPUインスタンスの料金
- RunpodPodsのGPU料金
- CivoGPU構成別の従量料金と継続契約料金
- Amazon Web ServicesEC2の状態と課金
- Google CloudVMの停止と再起動
- Microsoft Azure仮想マシンの状態と課金
- Lambdaインスタンスと保存領域の課金
- RunpodPodsの課金と保存費用
- RunpodPodsの構成とクラウド区分
- Microsoft AzureA10を分割して使うVMの仕様
- NVIDIAT4のメモリ容量と帯域の仕様
- NVIDIA / AWSA10Gのメモリと計算機能の仕様
- NVIDIAL4のメモリ帯域と対応する計算形式
- NVIDIAL40Sのメモリ帯域と接続仕様
- NVIDIAA100の40GB・80GBとPCIe・SXMの仕様
- NVIDIAH100 SXMとH100 NVLの仕様
- NVIDIAHGXのGPUごとの容量・帯域・接続
- NVIDIA計算形式と対応するGPU世代
- Hugging Faceモデルの重みと生成時に必要なメモリ
- NVIDIA文章生成の計算とメモリ帯域の関係
- NVIDIA複数GPUへのデータの分配と通信
2026年9月6日時点の公式資料を確認しています。仕様は更新される可能性があります。