コードの作成後に別のAIへ見直しを頼む手間まで減らしたいなら、GitHubが2026年9月に研究プレビューとして出した「HydraFusion」を、範囲を一回の依頼で渡せる修正から試す価値があります。GitHubの公式評価では、Claude Opus 5に比べて費用が36%から67%下がり、品質は三つの評価のうち一つで上回り、二つでわずかに下回りました。途中で相談しながら進める仕事や、使うモデルを限定したい仕事は、従来のAutoやモデルの明示指定と比べたうえで残す方が安全です。2026年9月7日時点の公式資料と、公開されている利用者の報告を照合し、何が変わり、いくらかかり、誰が試せるかを整理します。
モデルを選んだ後に残る見直しの手配
AIがコードを書いたあと、見落としがないか別のモデルに読ませる。指摘が出たら作成側へ戻して直す。この往復まで人が取り次いでいると、生成が速くなっても手元の作業は残ります。
GitHub Copilotは、コードの作成や修正を助けるAIサービスです。従来の「Auto」は、依頼の複雑さや各モデルの混み具合をもとに、処理を任せるモデルを一つ選びます。モデルを毎回選び直したくないときの選択肢で、どのモデルが答えたかは応答ごとに確認できます。1
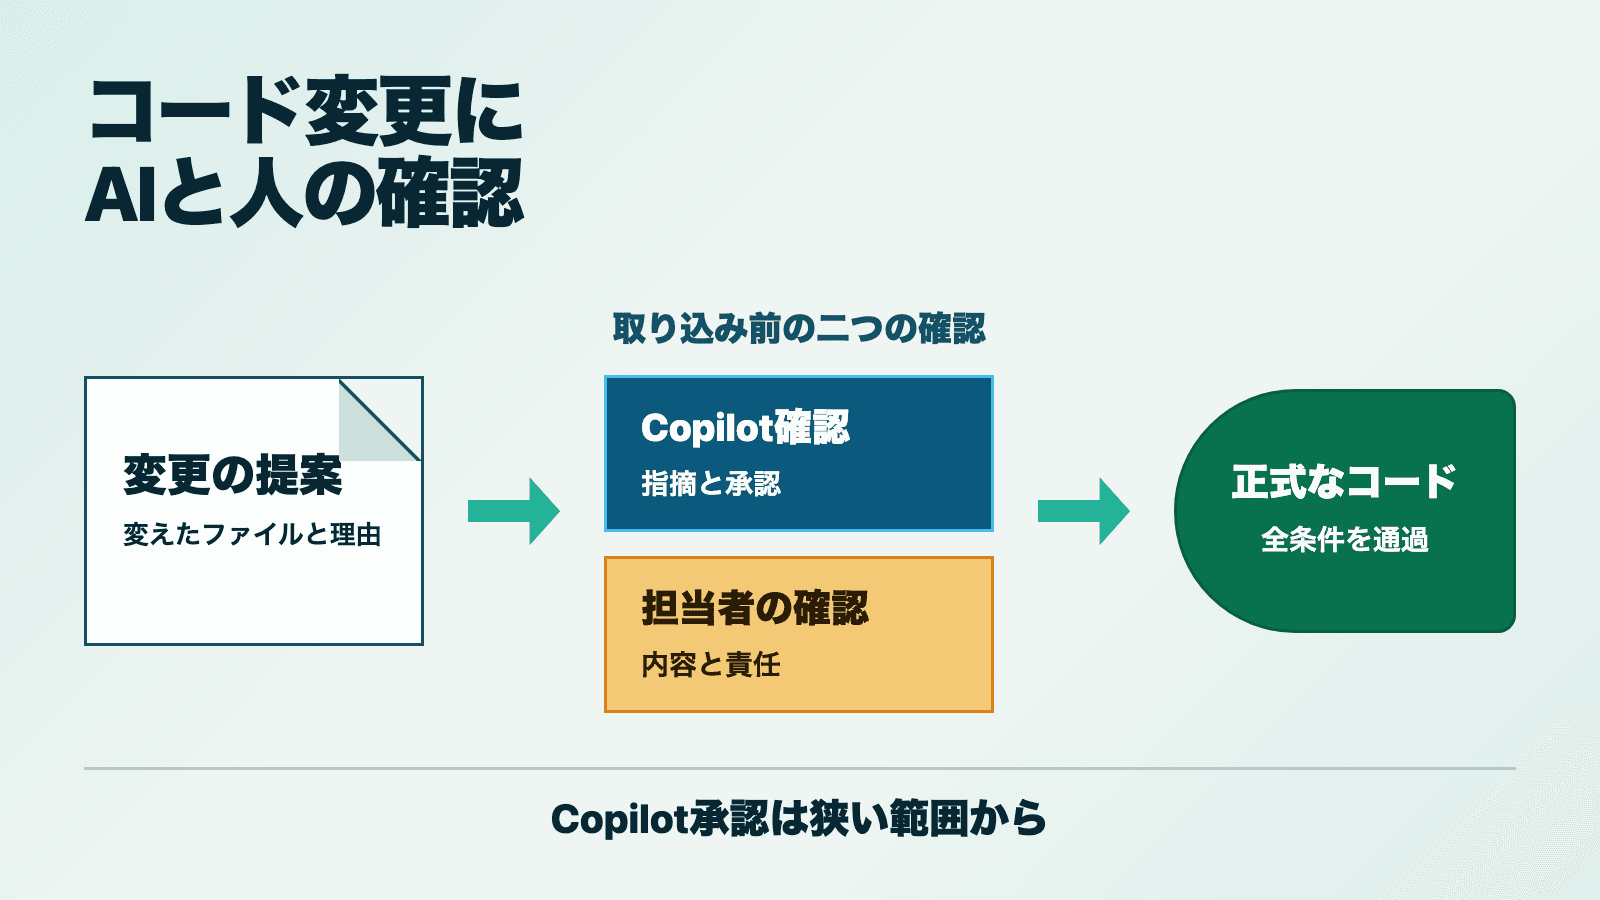
GitHubが発表したHydraFusionは、モデルと仕事の進め方を組み合わせて選びます。一つのモデルで解くか、軽いモデルの案を強いモデルへ引き継ぐか、別のモデルに批評させて直すかまでが選択の対象です。利用者はモデルの一覧からHydraFusionを選び、あとは普段どおり作業を依頼します。2
変わるのは、利用者が手配する範囲です。「誰に解かせるか」の自動化に、必要に応じて「どう見直すか」の自動化が加わります。一つのモデルで足りると判定されれば、批評を挟まずに処理します。
依頼に応じて選ばれる三つの処理方法
公式説明にある処理方法は次の三つです。HydraFusionは依頼ごとに内容を評価し、求められる品質に届くと見込める中で最も単純な方法を選びます。表の順に全部を実行するわけではありません。2
| 処理方法 | 仕事の進み方 | 利用者が理解しておきたい点 |
|---|---|---|
| Single | 選ばれた一つのモデルが解く | 別モデルの批評が必ず付くわけではない |
| Cascade | 軽量なモデルがまず案を作り、品質の判定を通らなければ強力なモデルへ引き継ぐ | 最初のモデルの使用量だけでは費用を見積もれない |
| Critique | 作成側とは別の系統のモデルが読み取り専用で批評し、作成側が一度だけ修正する | 批評する役とファイルを直す役が分かれ、修正は一回で止まる |
批評役は作成役と異なる提供元のモデルから選ばれ、ファイルを直接編集しません。修正も一回で終わるため、批評で見つかった問題がすべて解消される保証はありません。試すときは、完成した変更、テスト結果、人が確認にかけた時間を普段の方法と比べます。批評が加わっても、依頼した機能が動くか、既存の動作を壊していないかは成果物から確かめる必要があります。
公式評価で下がった費用と横ばいの品質
GitHubが公開した評価では、費用は三つの評価すべてで下がり、品質が上回ったのは一つだけでした。比較の基準はClaude Opus 5で、GPT-5.6 Solも基準モデルとして併記されています。すべてのモデルを同じ中程度の推論設定で動かし、費用には下書き、批評、修正、引き継ぎ、再試行、予備の実行まで含めた計算です。2
| 評価 | 費用の変化 | 品質の変化(Claude Opus 5との差) |
|---|---|---|
| TerminalBench 2.1 | 67%減 | 4.9ポイント上回る |
| DeepSWE | 36%減 | 1.5ポイント下回る |
| CheckpointBench(GitHub社内。実際のCopilot利用から作成) | 65%減 | 0.1ポイント下回る |
GitHub自身も、この結果は評価に使った課題の版、処理方法の構成、モデルの顔ぶれ、価格の前提に固有のものだと注記しています。技術メディアのVentureBeatは、費用はどの評価でも下がった一方で、品質で基準を上回ったのは一つだけだと指摘し、Cascadeでは安いモデルの費用がすべての依頼で発生し、強いモデルは判定に落ちた依頼にだけ動くために平均費用が下がる仕組みだと説明しています。7
自分の仕事にそのまま当てはめられる数字は、この表にはありません。得られるのは、同じ品質を安く済ませる方向で設計されていること、品質は基準モデルの前後で揺れることの二点です。自分の仕事も同じ割合で安くなると予算へ織り込む段階ではなく、後述する比較試用で自分の数字を取る段階です。
今使えるのはCopilot CLIの研究プレビュー
公式案内では、HydraFusionはすべてのCopilotプランが対象で、パソコンのターミナルから使うCopilot CLIで提供されています。CLIは文字で指示して作業を進める操作画面です。組織からCopilotを利用している場合、CLIの利用には組織側のポリシーも関わります。34
入口は三つの操作です。Copilot CLIで/updateを実行して最新版にし、/experimental onで実験機能を有効にし、/modelからHydraFusion (Research Preview)を選びます。VS CodeとCopilotアプリへの展開は、公式FAQでは2026年9月中を目標とする追加提供として記載されています。CLI向けの案内を、すべての画面で使えるという意味に広げないでください。3
公開初週の利用者報告と公式の返答から、試す前に知っておきたい挙動が三つあります。計画を先に作るプランモードではHydraFusionの選択が直前のモデルへ戻る不具合が報告され、GitHubの担当者が2026年9月4日に調査中と答えています。起動時の--modelオプションにHydraFusionを指定しても動かず、--experimentalを付けて起動してから画面で選ぶ回避策が案内されています。処理が終わった後も「Working」の表示が残る報告もあります。3
日本語の依頼での品質、待ち時間、実際の請求額は、この記事では確かめていません。以下は公式資料と、公開されている利用者の報告に基づく整理です。
費用はAIクレジットで各モデルの単価を合算
HydraFusion自体に別料金はなく、内部で使った各モデルのトークン量に、そのモデルの標準単価を掛けた合計が費用になります。生成に加えて批評や修正が動くなら、その分も含めて比較する必要があります。3
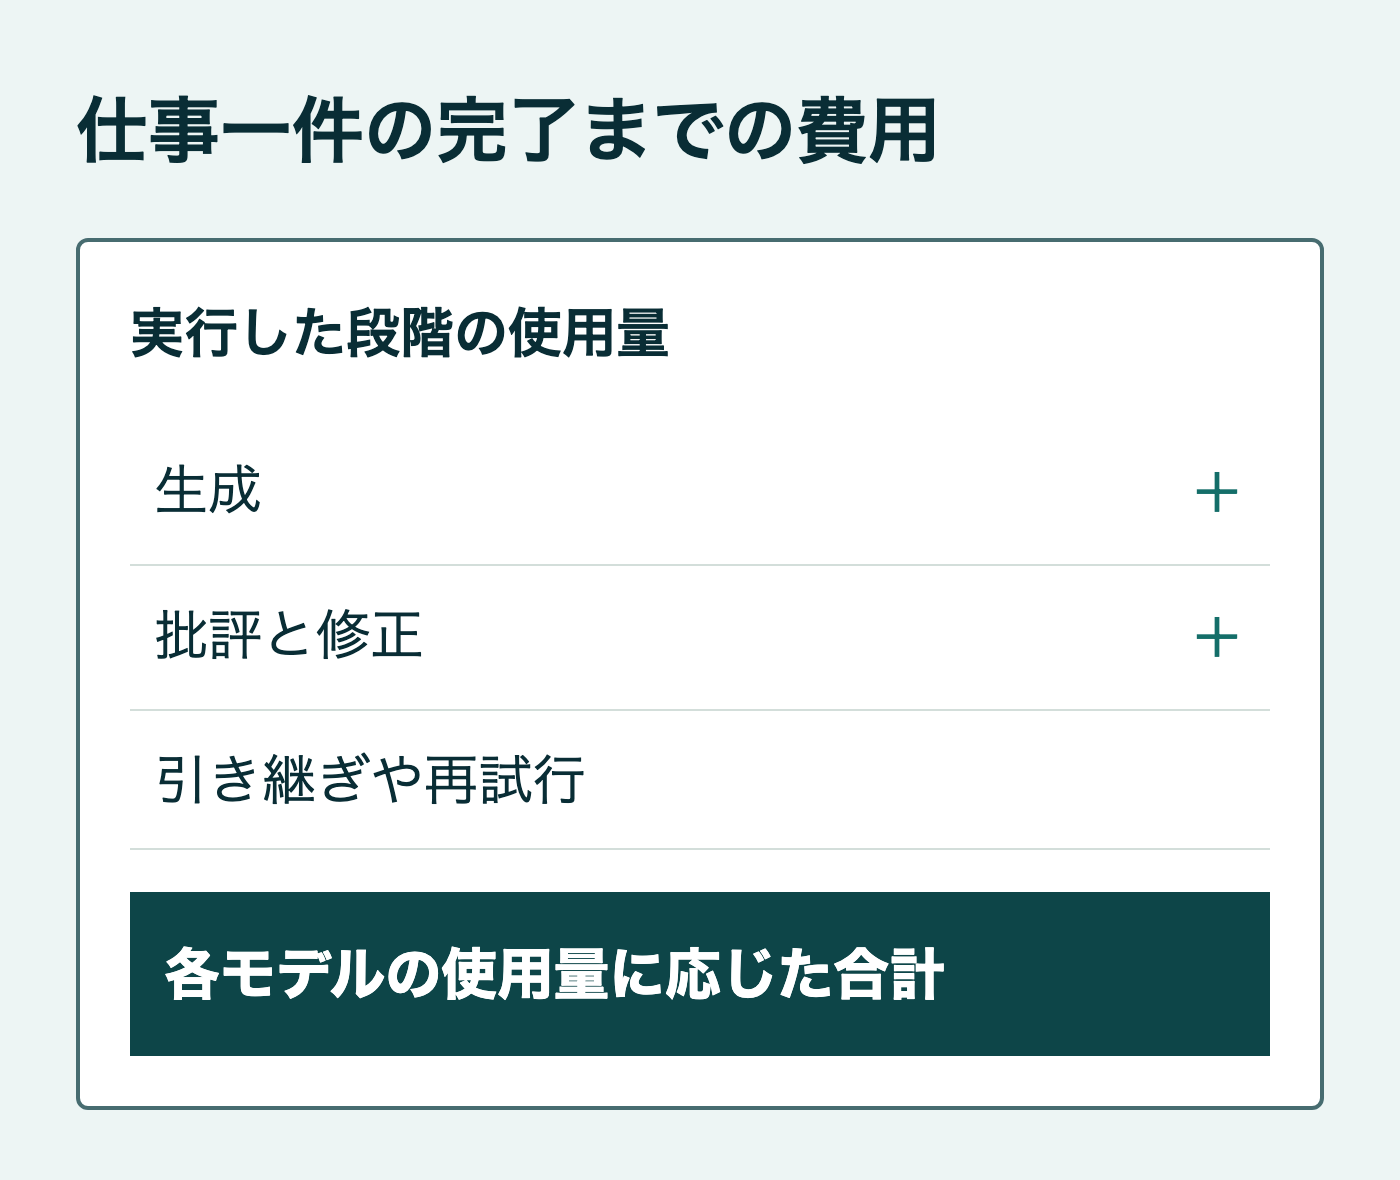
実際に動いた段階の費用を合計します。すべての依頼が図の全段階を通るわけではありません。
単価の土台は、2026年6月1日からCopilot全プランへ移行した使用量課金です。各プランには月額と同額のAIクレジット(公式表記はAI credits)が含まれ、1クレジットは0.01ドルです。個人向けのProは月10ドル分、Pro+は月39ドル分で、使い切った後は追加購入できます。モデルごとの単価は、2026年9月7日時点の公式料金表で次のとおりです。56
| モデル | 入力100万トークン | 出力100万トークン |
|---|---|---|
| Claude Opus 5 | 5.00ドル | 25.00ドル |
| GPT-5.6 Sol | 4.00ドル | 20.00ドル |
| Claude Sonnet 5 | 2.00ドル | 10.00ドル |
| Gemini 3.6 Flash | 0.75ドル | 3.75ドル |
この単価差が、HydraFusionが費用を下げる余地の正体です。軽いモデルで済む依頼を最上位モデルの5分の1以下の単価で処理し、必要なときだけ高い単価のモデルへ引き継ぎます。従来のAutoには、有料プランでモデル費用が10%引きになる条件が公式文書に記載されていますが、HydraFusionのFAQは標準単価と説明しているだけなので、同じ割引を前提にしない方が安全です。13
公開されている利用者の報告は二つの方向に分かれます。ある利用者は、計画に約500クレジット、実装に約2,300クレジットを使い、Pro+の月額分の4割に当たったと報告しました。別の利用者は、普段Claude Opus 5で使う量の1割ほどで同等の結果が得られたと述べています。どちらも一回の仕事の記録で、依頼の大きさも比較条件も異なります。自分の仕事で見るべきなのは、普段使っているAutoか明示したモデルと同じ依頼を同じ状態から始め、完成した変更、追加で頼んだ修正、完了までのクレジットを並べた結果です。人が読み直す時間まで増えているなら、クレジットだけが減っても採用する理由は弱まります。3
途中で相談する仕事と完成品を確認する仕事を分ける
最初に試しやすいのは、変更の範囲と終わり方を一回の依頼で渡せる仕事です。たとえば、再現する不具合と期待する動作が分かり、修正後に通すテストも決まっている仕事です。GitHubも初期の試用では、最初の依頼だけで進められる、内容と範囲が明確な開発課題を勧め、長い対話を重ねる使い方は次に改善する対象としています。2
画面を見ながら仕様を決めたり、調査結果を比べてから方針を変えたりする仕事では、完成前に案と理由を見て方針を変えられることが必要です。HydraFusionは内部の下書きや批評を画面へ出さず、見直しを終えた結果だけを表示する設計で、GitHubの担当者は途中で変わり得る文章を見せない方針だと説明しています。実際に、調査結果を確かめたくて作業を中断した利用者の報告があり、GitHubの担当者はその報告を改善の材料として受け止めると答えました。3
どのモデルが動いたかは、計画と見直しの段階では表示され、実装の段階では表示されなかったという利用者の報告があります。同じ報告では、資料の読み込みにClaude Sonnet 5、引き継ぎ後の実装と見直しにGPT-5.6 Sol、テストの実行にClaude Haiku 4.5が使われていました。内部で使うモデルを利用者が指定したり除外したりする機能は、2026年9月7日時点ではありません。使用モデルを限定する必要があるチームは、その条件を満たせるようになるまで試用範囲を広げない方がよいでしょう。3
Autoと別モデルの批評も比較候補に残す
HydraFusionを使わずに、別モデルの批評だけを足す方法もあります。Copilot CLIの「ラバーダック」は、作業中のモデルとは別のモデルが計画、コード、テストを読み、不具合や設計上の見落としを指摘する組み込みの批評役です。2026年6月に正式機能になり、計画を立てた直後やテストの後など要所で自動的に呼ばれるほか、/rubber-duckで自分から呼ぶこともできます。小さく分かりきった変更では省略され、作業中のモデルがClaudeかGPTのときだけが対象です。48
ラバーダックはファイルを編集せず、指摘の要点を作業の時系列表示へ要約するので、内部の案を見せないHydraFusionと違って批評の理由まで追えます。批評の内容を確かめてから次の依頼を決めたいなら、こちらが向いています。4
| 自分の仕事で優先すること | 比較する選択肢 |
|---|---|
| モデルを選ぶ手間を減らし、普段の対話を続けたい | Auto |
| 範囲の決まった仕事を渡し、見直し方の手配も任せたい | HydraFusionの研究プレビュー |
| 見直す時点を決め、別モデルの指摘の理由も読みたい | 明示したモデルで作業し、ラバーダックで批評 |
モデルの名前を覚えるより、試す仕事の完了条件を一文にしておく方が先です。その一件を終えるまでのクレジットと確認のしやすさを比べれば、研究プレビューを使い続けるか、Autoや明示したモデルでの作業を残すかを決めやすくなります。
参照リンク8件
- GitHubAbout Copilot auto model selection
- GitHubProject HydraFusion
- GitHubHydraFusion research preview and FAQ
- GitHubAbout the rubber duck agent
- GitHubModels and pricing for GitHub Copilot
- GitHubGitHub Copilot is moving to usage-based billing
- VentureBeatGitHub's HydraFusion cuts AI coding costs in every benchmark. It only matches quality in one.
- GitHubCopilot CLI: Improved UI, rubber duck, prompt scheduling, and voice input
2026年9月7日時点の公式資料を確認しています。仕様は更新される可能性があります。