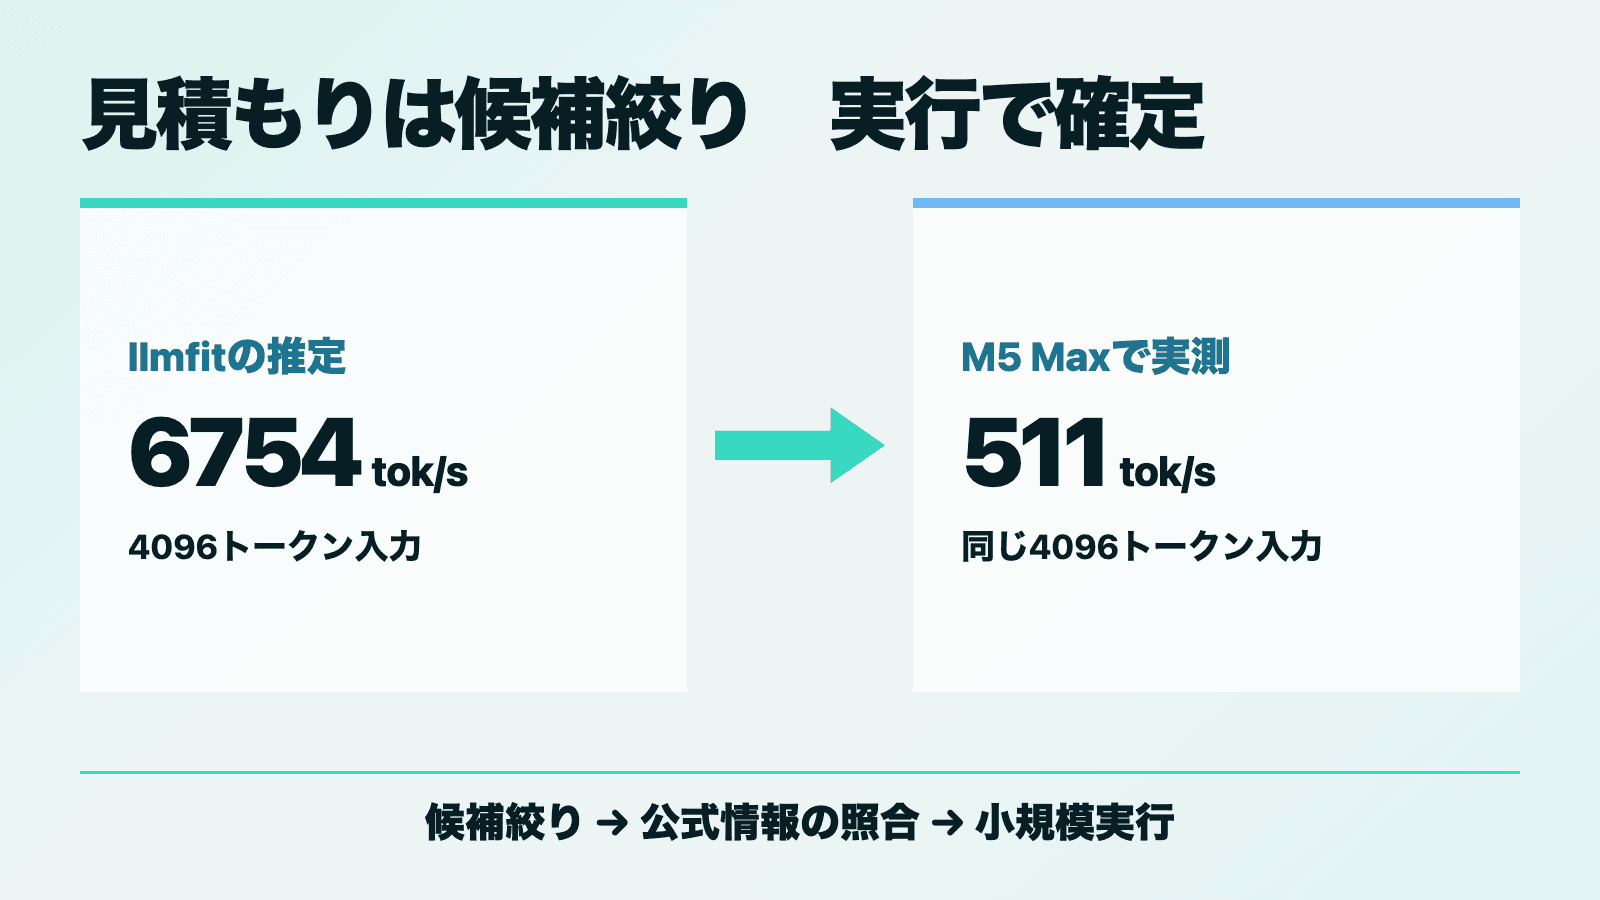
llmfitは、端末と予定文脈からローカルLLMの適合度や速度を見積もる道具です。約278MBの4ビットモデルをM5 Maxで実際に動かすと、4096条件の推定6754 tok/sに対し実生成2回の平均は511 tok/sでした。なぜ今こうした道具が必要なのか、推定はどこまで使えるのかを、内蔵情報の照合と512、4096、8192トークンの実測から整理します。
なぜいま「モデル名だけでは選べない」のか
llmfitは、端末のCPU、GPU、RAM、メモリ帯域幅を読み取り、ローカルLLMが指定条件で載りそうか、どれくらいの速度になりそうかを見積もるオープンソースの道具です。Mac、Linux、Windowsに対応し、対話画面とCLIの両方から使えます。重いモデルを何本も取得する前に、端末に合わない候補を減らせるのが利点です。34
こうした適合ツールが必要になった背景は、ローカルLLMが試しやすくなったことにあります。4ビット量子化済みのモデルを選べば、今回のように重みが約278MBの配布物もあり、数分で生成まで到達できます。量子化とは、重みを少ないビット数で表して容量とメモリ使用を抑える方法です。実験で使うMLX版とは実装が異なりますが、Hugging Faceの日本語文書にも4ビット、8ビットで読み込む考え方が整理されています。8
同時に、モデルが一度に扱える文脈は長くなりました。今回使ったQwen2.5-Coder-0.5B-Instructの公式モデルカードは、32768トークンの文脈を掲げています。5 長いコードや資料を分割せず渡せるのは便利ですが、推論中には重み以外の領域も必要です。
代表がKVキャッシュです。過去のトークンから計算したKeyとValueを残し、次のトークン生成で再利用します。ほかに実行系の作業バッファ、OS、同時に開いているアプリの領域も要ります。つまり、量子化で重みを小さくしたことと、長い文脈を余裕をもって処理できることは同じではありません。9
さらに、同じ元モデルから複数量子化やMLX、GGUFなどの変換版が公開され、似た名前の配布物が増えました。名前が同じでも、形式、重みの大きさ、設定ファイルが同じとは限りません。モデル名と「4ビット」だけで決めるには、選択肢が細かくなりすぎたのです。
この題材を取り上げた直接のきっかけは、llmfitの利用者が2026年8月14日に投稿した議論です。利用者は「文脈長を指定し、その条件で載る最大モデルまで候補を絞れないか」と尋ねました。作者は、CLIなら--max-context 8192で全モデルを再計算できると説明しています。1
量子化で取得しやすくなり、長い入力を使えるようになり、配布形式も増えた。その結果、端末、量子化、文脈長をまとめて計算する道具が必要になりました。llmfit v1.1.11でハイブリッド注意モデルのKVキャッシュや量子化済みモデルの適合判定が修正されたのも、この計算が単純ではないことを示しています。2
llmfitが答えることと答えないこと
llmfitは、検出した端末情報と内蔵するモデル情報を計算式へ入れ、必要メモリ、推奨メモリ、適合度、生成速度を返します。--max-contextは、モデルが公称する最大文脈を書き換える指定ではありません。「自分は8192まで使う」という条件でメモリ計算をやり直す指定です。34
ここで大切なのは、計画と測定を分けることです。plan --jsonの先頭にも、現在のヒューリスティクスを使った推定であり、正確なベンチマークではないと明記されています。出力の役割は、数十ある候補から明らかに厳しいものを外すことです。
| llmfitで先に分かること | 実際に動かさないと分からないこと |
|---|---|
| 内蔵データに基づく必要・推奨メモリ | その配布物を読み込んだときのピークメモリ |
| 条件間の適合度の変化 | 初回トークンまでの待ち時間と実生成速度 |
| GPU、CPU-onlyなどの実行候補 | 自分の文章やコードに対する回答品質 |
| 文脈長を変えた計画値 | OSや同時利用アプリを含む安定性 |
最初の実験案では、大きなモデルについてllmfitの計画値だけを取り、記事にしようとしていました。しかしモデル本体を取得しておらず、それを体験や実測とは呼べません。そこで旧結果を主証拠から外し、軽量モデルを取得して、推定と実行を同じ条件で比べ直しました。
約278MBのモデルを固定して実行した
見積もりをどこまで判断に使えるか確かめるため、推定と実行の条件をそろえました。検証機はApple M5 Max、18コアCPU、128GBユニファイドメモリのMacです。macOS 26.4.1上で、公式配布のllmfit v1.1.11 Apple arm64版を使いました。アーカイブのSHA-256は、リリースページ記載のf42249d8...c6e8bafと一致しています。2
実行するモデルはmlx-community/Qwen2.5-Coder-0.5B-Instruct-4bitです。リビジョンを6b16732...ef7a4へ固定しました。この配布物は、Qwen公式の0.5B InstructモデルをMLX形式へ変換したものです。56
model.safetensorsは278,064,920バイトで、SHA-256は162e6341...d25bdでした。実行環境はPython 3.12.13、MLX 0.32.2、MLX-LM 0.31.3です。システム全体へ入れず、一時的な仮想環境へ分離しました。
入力は512、4096、8192トークンの三条件です。同じ英文を埋め草にし、末尾の質問を固定しました。生成は毎回64トークン、温度0です。終了トークンによる早期終了を抑え、各条件を新しいプロセスで2回ずつ測りました。比較したのは生成速度とMLXが報告するピークメモリです。MLX-LM自身がprompt_tps、generation_tps、peak_memoryを計測して返します。7
初回はモデル9ファイルの取得に約36秒かかりました。測定スクリプトも一度で完成したわけではありません。最初は推論後のバージョン取得で例外が出て、次は終了トークンにより1トークンで止まりました。版の取得方法を修正し、64トークンを揃える処理を加えて全条件を取り直しています。成功値だけでなく、この失敗過程もexperiment.mdへ残しました。
文脈を伸ばすと実生成は610から423 tok/sへ落ちた
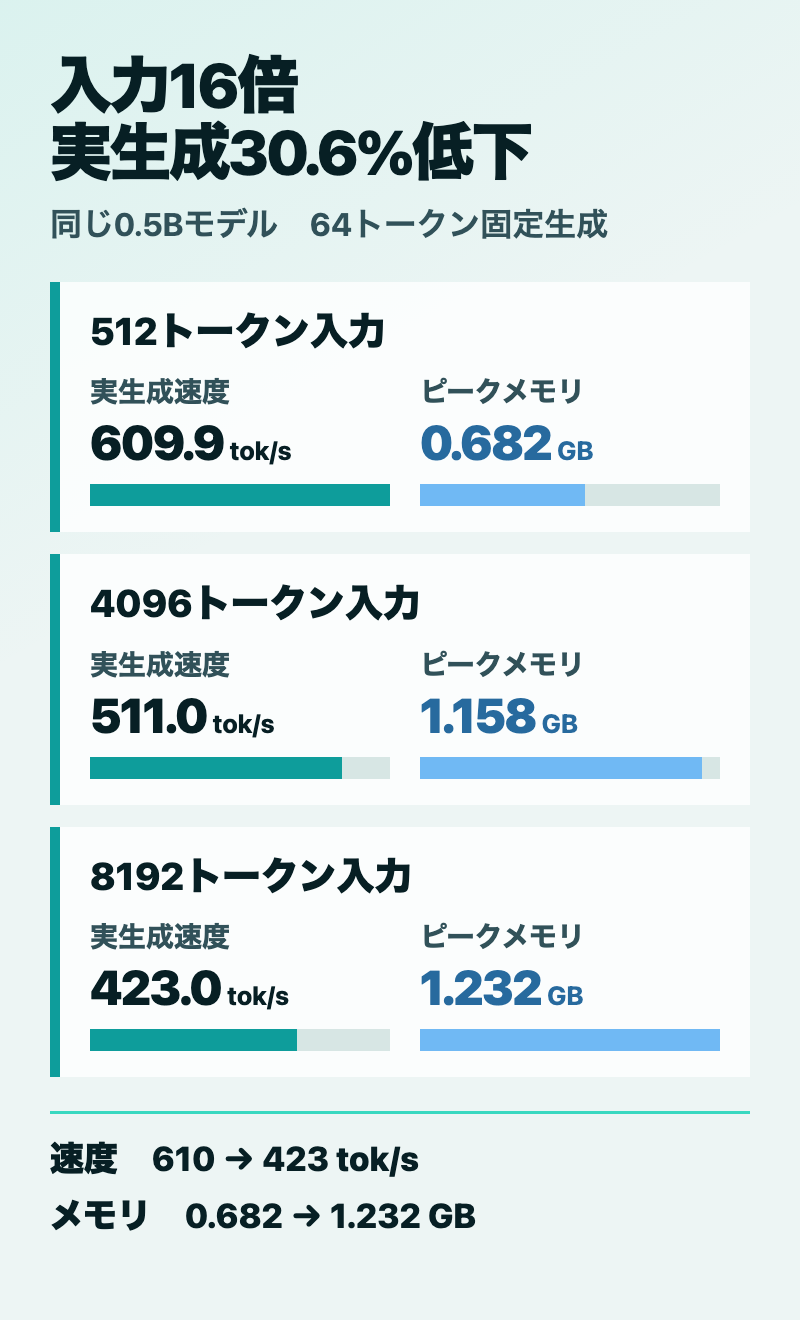
2回の生成速度の平均と、MLXが返したピークメモリは次のとおりです。llmfit側は同じモデルをmlx-4bitに固定した計画値です。
| 入力 | llmfit必要量 | llmfit推定 | 実生成2回の平均 | MLXピークメモリ |
|---|---|---|---|---|
| 512 | 0.543GB | 6754 tok/s | 609.9 tok/s | 0.682GB |
| 4,096 | 0.545GB | 6754 tok/s | 511.0 tok/s | 1.158GB |
| 8,192 | 0.548GB | 6754 tok/s | 423.0 tok/s | 1.232GB |
512から8192へ入力を16倍にすると、実生成は約30.6%低下し、ピークメモリは0.550GB増えました。今回の小さなモデルは128GB機に余裕で載るため、三条件とも停止やスワップはありません。それでも、入力を長くした影響は実行結果へ現れました。
一方、llmfitの推定速度は三条件とも6754 tok/sで変わりません。実生成との差は約11倍から16倍です。llmfitは内蔵情報と式による計画値、MLX-LMは取得した配布物を動かした実行値であり、同じ測定器の誤差比較ではありません。必要量の計画値とMLXのピークメモリも測定範囲が同じではないため、数字を直接の誤差率にはできません。ただし、推定値をそのまま実機ベンチマークとして扱えないほど差があることは確認できました。
llmfitが計算したfp16のKVキャッシュは、512条件の0.000316GBから8192条件の0.005063GBへ増えました。ただし、実際のピークメモリ増加は0.550GBです。両者の測定範囲は同じではなく、この差をKVキャッシュの誤差とは呼べません。実行系の作業領域なども含む実測は、計画上のKV単体より広い数字だと読めます。
入力処理速度は512条件の一回目だけ大きく揺れました。初回コンパイルの影響を受けた可能性が高いと判断し、今回の比較表からは外しています。生成速度は各条件の2回で近い値になりました。短いベンチマークでも、何を揃え、何を除外したかを明示しないと、数字だけが独り歩きします。
モデル情報を照合すると別のずれが見えた
差を「推定器は当たらない」で終わらせず、llmfitのinfoと公式モデルカードを比べました。
| 項目 | llmfit v1.1.11内蔵情報 | 公式・取得物で確認した値 |
|---|---|---|
| パラメータ規模 | 77M | 全体0.49B、埋め込みを除いて0.36B |
| 文脈長 | 4,096 | 32,768 |
| ディスク量 | 0.08GB | 重みファイル約0.278GB |
同じリポジトリ名に対して、llmfitは77M、公式モデルカードは全体0.49B、埋め込みを除いても0.36Bと示しました。定義の違いだけでは77Mを説明できません。さらに文脈長とディスク量も、llmfit側が小さい方向へずれています。MLX版の設定ファイルには24層、最大32768トークン、4ビット量子化とあります。56
llmfitの速度推定は、内蔵するモデル規模とメモリ帯域幅を使います。そのため77Mという入力値が、速度を高く見積もる一因になった可能性があります。ただし、正しい規模へ直したカタログで再計算していないため、11倍から16倍の差をこれだけで説明できるとは断定しません。
これは、llmfit全体が使えないという結論ではありません。むしろ、なぜinfo確認が必要なのかを示す例です。適合計算の式が正しくても、モデルカタログの名前、規模、文脈が配布元とずれていれば、結果もずれます。公開直後のモデル、派生名の多いモデル、変換済みモデルほど、公式カードとの照合を一工程に入れた方が安全です。
見積もりから実行までを三段階に分ける
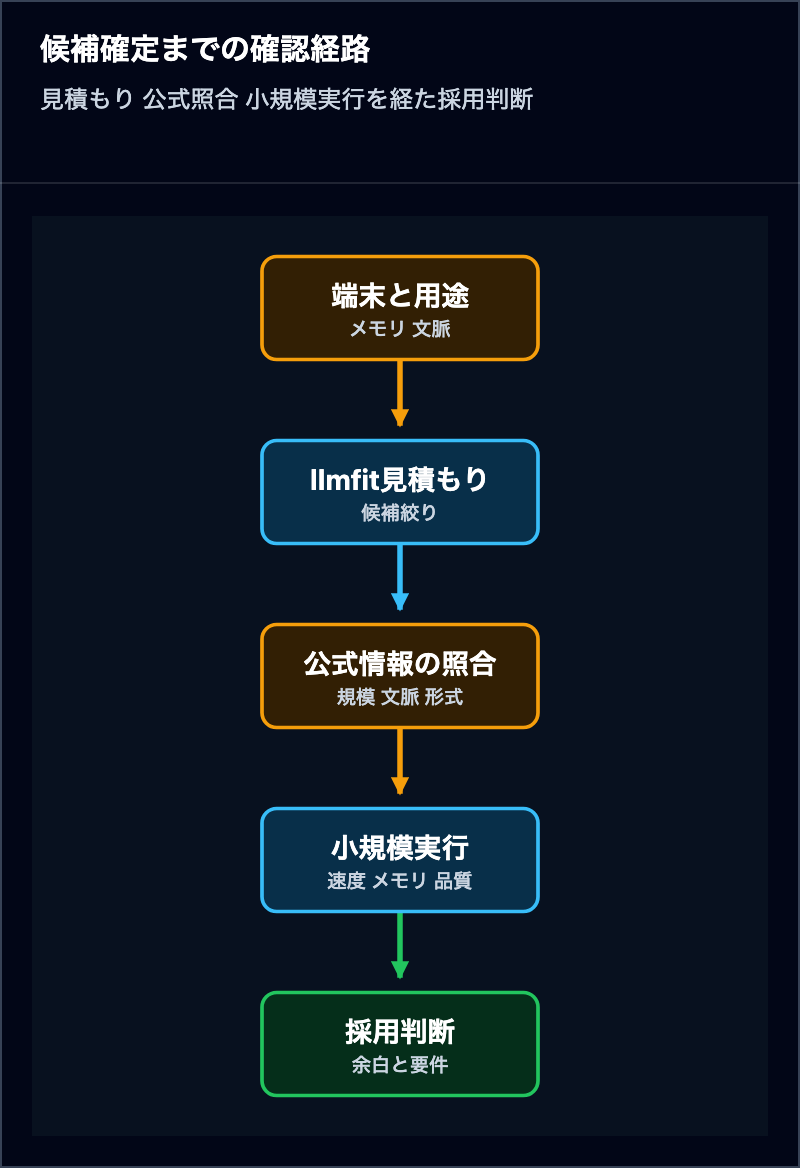
今回の経験から、ローカルLLMは次の順で選ぶのが実用的です。見積もりだけで採用を決めず、段階ごとに不確かな部分を減らします。
| 段階 | やること | ここで止める条件 |
|---|---|---|
| 1 | llmfitで端末、量子化、予定文脈を入れ、候補を絞る | 必要量が利用可能メモリに近すぎる |
| 2 | llmfit infoと公式モデルカードで規模、文脈、形式を照合する | 名前やパラメータ数が大きく食い違う |
| 3 | 最小のモデルまたは候補本体を動かし、速度、ピークメモリ、回答を測る | 実務で必要な速度、余白、品質に届かない |
まずは一回だけ生成してみる
自然文を一回生成するだけなら、uvがあるAppleシリコンMacで次の一行を実行できます。初回だけMLX-LMと約278MBのモデルを取得します。
uvx --from mlx-lm==0.31.3 mlx_lm.generate --model mlx-community/Qwen2.5-Coder-0.5B-Instruct-4bit --prompt '見積もり後に実モデルを動かす理由を一文で答えてください。' --max-tokens 64 --temp 0
本文と同じ固定リビジョン、入力長、64トークン生成を再現するコードは、記事付属のexperiment/run_mlx_measurement.pyです。512と8192だけでも、文脈が伸びたときの速度とメモリの変化を体験できます。大きなモデルを先に取得する必要はありません。
ただし、この結果を32GB機や別のモデルへそのまま外挿はできません。0.5Bモデルの回答品質も評価していません。目的は速度ランキングを作ることではなく、計画値と実測値を混同しない選び方を確かめることです。
llmfitが便利なのは、ダウンロード前に問いを具体化できるからです。「このモデルは載るか」ではなく、「この端末で、この量子化を、この文脈長で使う候補に残せるか」と聞けます。その答えを確定するのは、公式情報との照合と、自分の実行です。
参照リンク9件
- llmfitContext size / KV cache overhead in fit calculations
- llmfitllmfit v1.1.11 release
- llmfitCLI & Automation
- llmfitllmfit公式日本語README
- QwenQwen2.5-Coder-0.5B-Instruct model card
- mlx-communityQwen2.5-Coder-0.5B-Instruct-4bit fixed revision
- MLX-LMMLX-LM v0.31.3 generate.py
- Hugging FaceTransformers日本語版 量子化
- Hugging FaceKV cache strategies
2026年8月27日時点の公式資料を確認しています。仕様は更新される可能性があります。