Granite Speech 5.0はTTSではなく、英語音声を文字へ変えるSTT/ASRモデルです。Whisperやクラウド音声認識との違い、英語文字起こしへ機能を絞った背景を整理し、Apache 2.0版と非商用版を計9音声で試しました。公式差0.15ポイントより先に、必要な役割、モデルカードの利用条件、録音の扱いを確認する選定順を説明します。
まず音声認識と音声合成を分ける
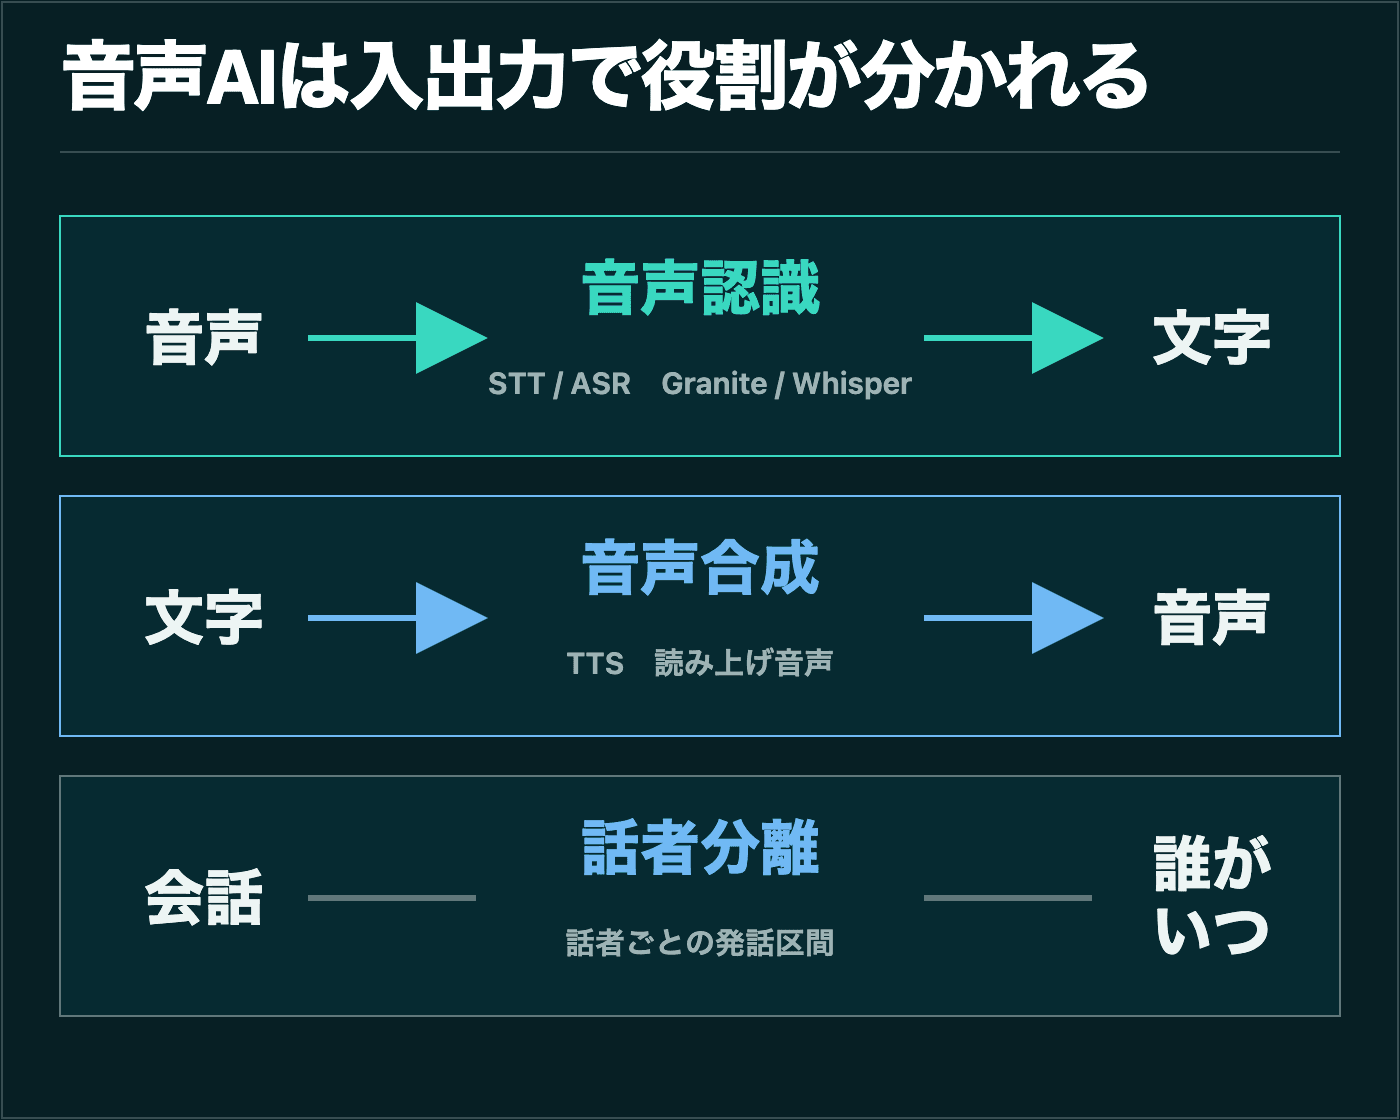
「音声AI」という言葉には、向きの違う技術が一緒に入っています。入力と出力を矢印で考えると、役割を取り違えません。
| 技術 | 入力 → 出力 | 具体的な用途 |
|---|---|---|
| STT / ASR | 音声 → 文字 | 会議録、字幕、通話検索 |
| TTS | 文字 → 音声 | 読み上げ、音声案内 |
| 話者分離 | 会話 → 誰がいつ話したか | 複数人会議の区切り |
| 音声翻訳 | ある言語の音声 → 別言語の文字や音声 | 多言語会議 |
STTはSpeech to Textの略です。ASRはAutomatic Speech Recognitionの略で、製品説明ではほぼ同じ「音声認識」の意味で使われます。Granite Speech 5.0 TurboCTCとWhisperはこの列に入ります。反対向きのTTSは、文章から読み上げ音声を作る技術です。
話者分離も文字起こしとは別の仕事です。音声認識が「何を話したか」を文字にし、話者分離が「誰がいつ話したか」を区切ります。会議録アプリでは両方が一画面に入るため同じモデルに見えますが、内部では別部品を組み合わせることがあります。Granite Speech 5.0のモデルカードが中心にしているのは英語の文字起こしで、話者名の確定や読み上げ音声の生成ではありません。12
音声認識にはモデルと完成サービスがある
「Whisperのようなモデル」と「クラウドの音声認識API」も、同じ土俵に見えて運用範囲が違います。
| 選択肢 | できること | 自分で用意するもの | 向く場面 |
|---|---|---|---|
| Whisper | 多言語の音声認識・英語への翻訳 | 実行環境、API、監視、画面 | 多言語、ローカル実行、広い検証 |
| Granite Speech 5.0 TurboCTC | 英語の文字起こし | 実行環境、API、監視、画面 | 英語限定、端末実行、大量処理の候補 |
| Google Cloud Speech-to-Text | 管理された音声認識API | クラウド設定、認証、費用管理 | 短期導入、ストリーミングや各種機能 |
| Azure Speech to Text | 管理された音声認識API | クラウド設定、認証、費用管理 | Azure連携、リアルタイム・一括処理 |
Whisperは、音声認識、言語識別、英語への翻訳を含む汎用的な多言語モデルとして公開されました。5 Granite Speech 5.0 TurboCTCは、対象を英語の文字起こしへ絞った約4.7億パラメータのモデルです。12 GoogleやAzureは、モデルそのものをダウンロードして組み込むのではなく、音声を管理されたAPIへ送り結果を受け取るサービスです。67
どれが上というより、担当範囲が違います。自前モデルなら音声を自社環境から出さない構成を作れますが、サーバー更新、メモリ、同時実行、障害対応は自分たちの担当です。クラウドAPIへ任せる場合は、音声の送信先、保存条件、料金、地域を確認します。
モデルを選んだだけではアプリは完成しない。実用品には、録音、16kHzへの変換、長い音声の分割、話者分離、固有名詞の補正、保存、検索、権限管理、画面が必要です。この記事で試すGraniteは、その中央に置く「音声から文字を出すエンジン」に当たります。
なぜ英語文字起こし特化の新モデルが必要なのか
音声認識は、機能を増やすほど便利になります。多言語、翻訳、質問応答、キーワード誘導まで一つの大きなモデルで扱えれば、用途は広がります。一方で、コールセンターの録音を毎日何千件も処理する、ノートPCや店舗端末で英語字幕を出す、といった用途では、使わない機能のためにメモリと計算時間を払うことになります。
IBMの以前のGranite Speechは言語モデルを組み合わせ、音声の理解や翻訳など広い機能を扱っていました。5.0の470M TurboCTCは、言語モデルを持たないエンコーダー中心の構成へ絞り、英語文字起こしの小ささと処理量を優先しています。その代わり、翻訳やキーワードによる誘導など、以前の多機能モデルが持つ機能は対象外です。1
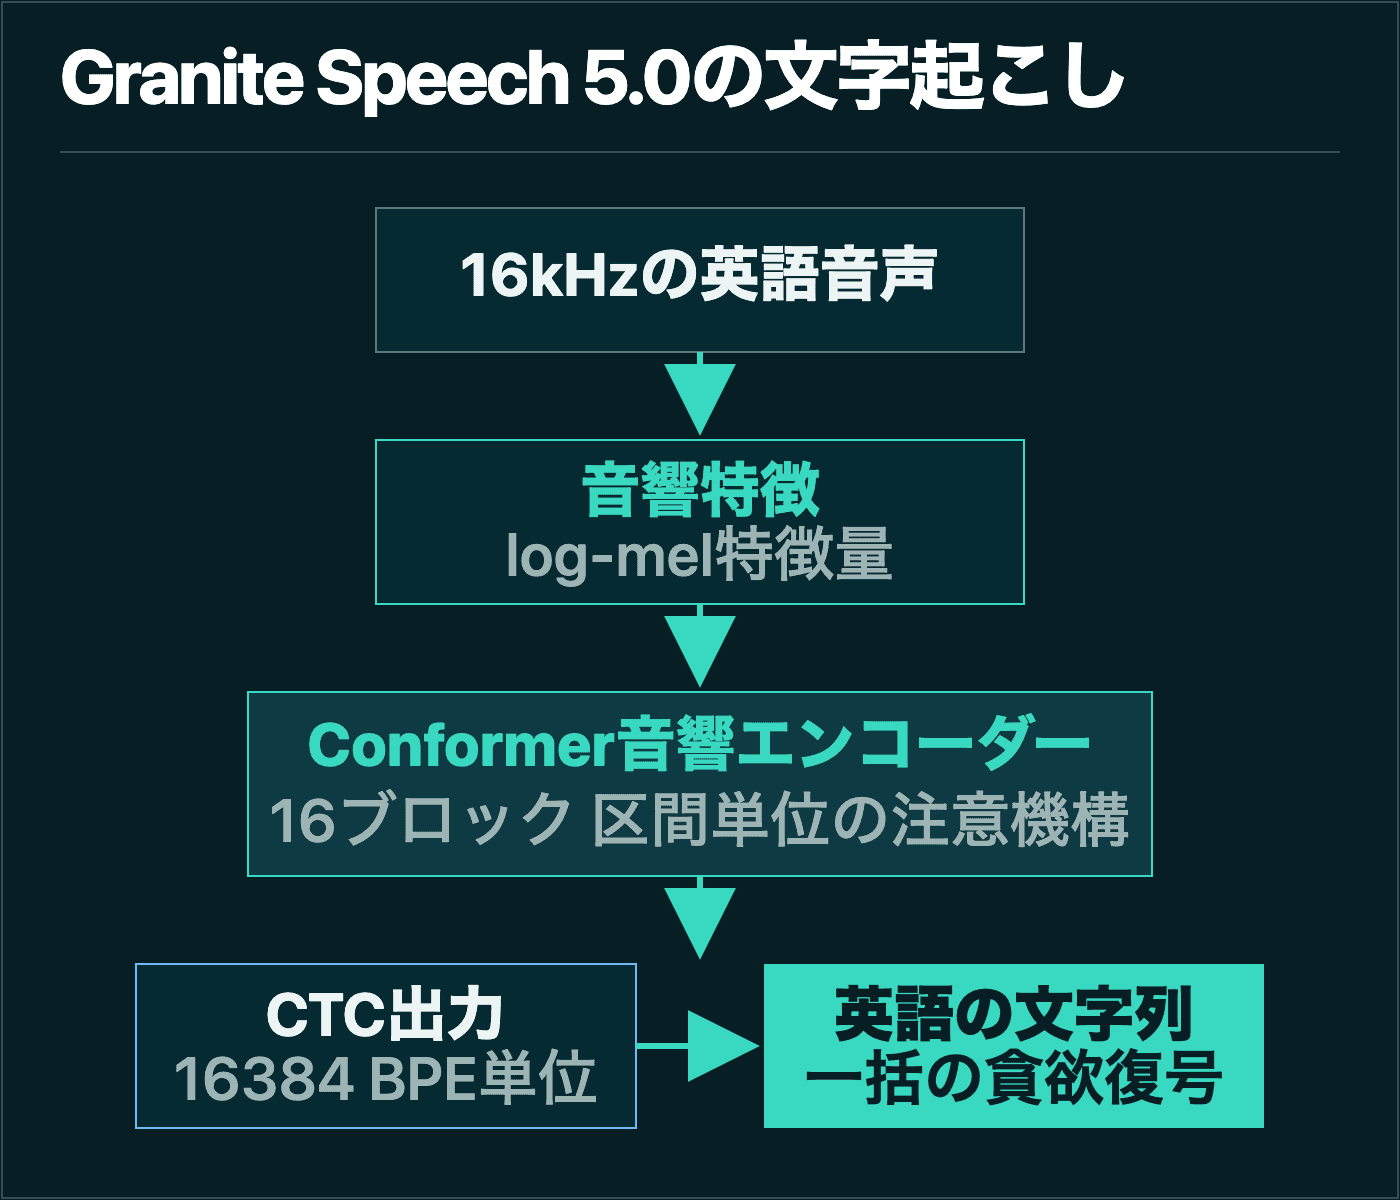
処理では、16kHzの英語音声を音響特徴へ変え、16ブロックのConformer音響エンコーダーへ通し、CTCで文字列の単位を出します。CTCを使うと、音声の各時点と完成文を一語ずつ手作業で対応付けなくても学習しやすくなります。TurboCTCは16,384個のBPE単位を使い、モデルカードの例では一括の貪欲復号で文字列を得る構成です。124
ここでの新しさは「Whisperを全面的に置き換えること」ではありません。英語の文字起こしだけが必要な現場に、より小さく、端末や高処理量を狙える別の選択肢を作ったことです。機能を減らしたこと自体が設計判断になっています。
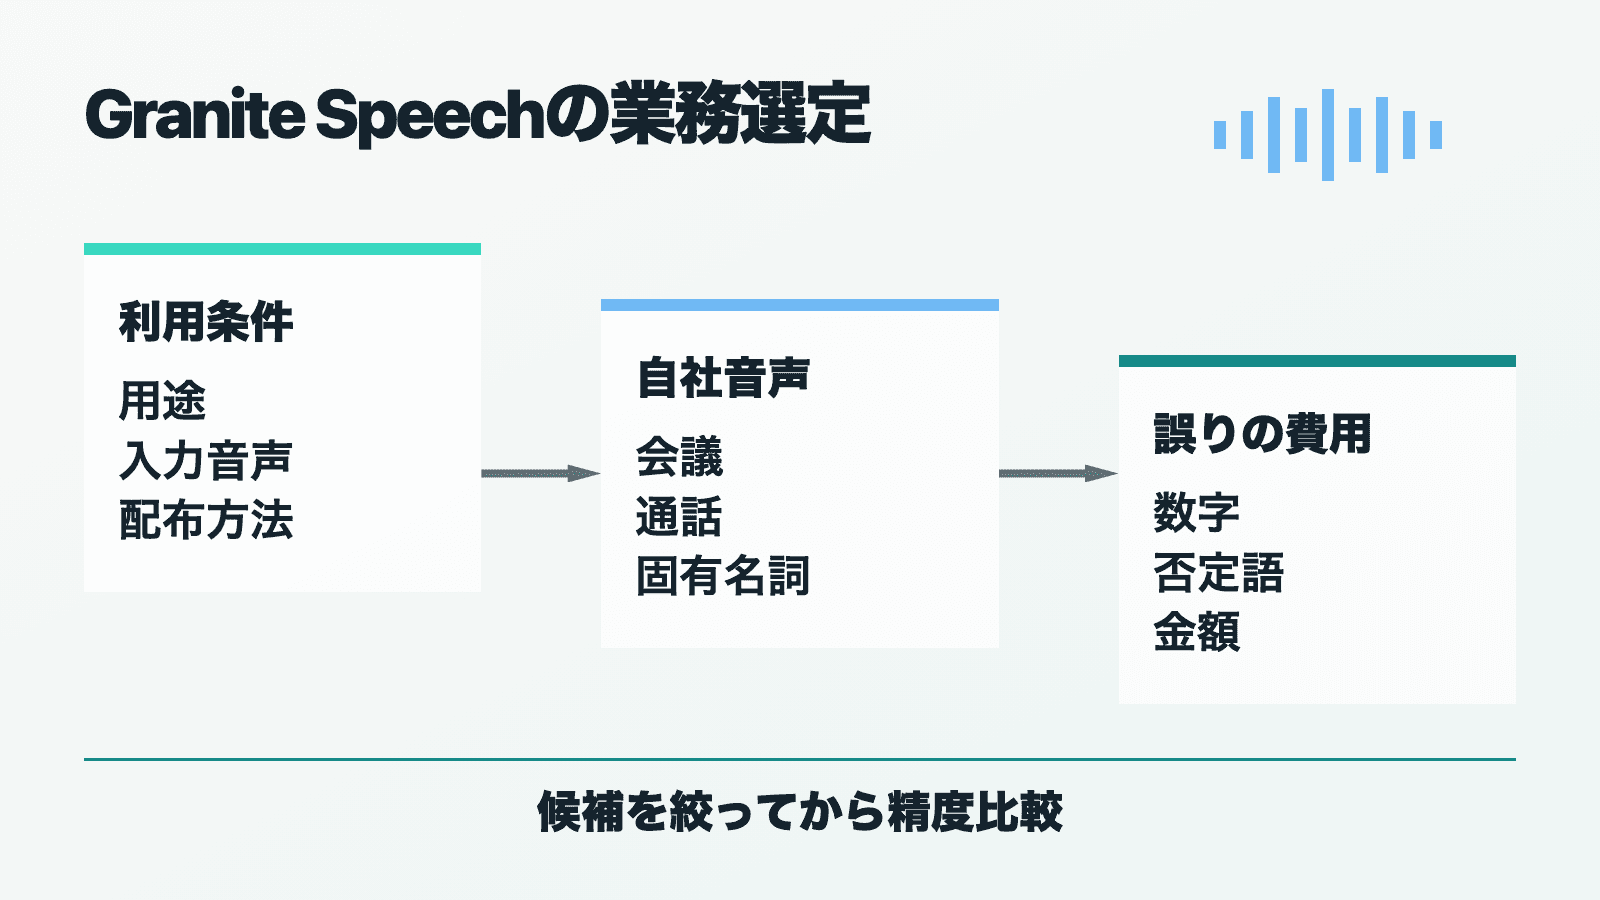
最初に用途を一文で書く
モデルを触る前に、「誰が、どの音声を、何のために文字へ変え、結果をどこへ出すか」を一文にします。たとえば次のような書き方です。
社内の担当者が、同意を得て録音した英語の顧客通話を、問い合わせ記録の下書きに使う。モデルは自社環境で動かし、重みは再配布しない。
この一文があると、確認する対象が見えてきます。商用か非商用かだけでは足りません。入力音声を処理してよいか、個人情報をどこへ保存するか、モデルや改変物を配布するか、生成した文字列を誰へ見せるかも選定条件です。
Granite Speech 5.0 TurboCTCは日本語音声の認識モデルではありません。英語の文字起こしが今回の範囲です。日本語会議を文字にしたい、音声を別言語へ翻訳したい、話者名まで自動で付けたい、という要件なら、この時点で別モデルや周辺サービスを候補へ足します。
同じ名前でもモデルカードの条件が違う
二つのモデルは大きさも基本構造も同じですが、モデルカードのライセンス表示と学習データが違います。
| モデル | モデルカードのライセンス | 記載された用途 |
|---|---|---|
granite-speech-5.0-470m-turboctc | Apache License 2.0 | 企業向け英語文字起こし |
granite-speech-5.0-470m-turboctc-nc | CC BY-NC-SA 4.0 | 研究・非商用のみ |
名前に -nc が付く後者は、非商用条件を含む版です。Creative Commonsの日本語版証書では、営利目的の利用を認めず、改変して共有する場合は同じライセンスを求めています。310 会社で使うことを一律に判断はできません。具体的な利用が営利目的に当たるか、どの行為が翻案や共有に当たるかは状況で変わるため、曖昧なら権利者への確認や法務判断が必要です。
一方、Apache 2.0版も「何をしても確認不要」という意味ではありません。ライセンス本文には著作権表示、ライセンスの写し、変更の表示、NOTICEの扱い、特許、商標に関する条件があります。9 さらに、学習データの来歴、入力する録音の権利や同意、個人情報、使うコードと依存ライブラリ、出力の扱いはモデルカードのラベルだけでは解決しません。
したがって、この記事ではApache 2.0版を「モデルカード上、業務利用の候補に残しやすい版」と呼びます。個々の利用について法的な結論を出す記事ではありません。
公式値は5.00対4.85
IBMの記事にある学習データ表をJSONへ転記し、Node.jsで再集計しました。1
| 区分 | Apache 2.0版 | 非商用版 |
|---|---|---|
| 共通の自然音声 | 57,710時間 | 57,710時間 |
| 共通の合成音声 | 2,740時間 | 2,740時間 |
| 追加の自然音声 | 0時間 | 14,900時間 |
| 合計 | 60,450時間 | 75,350時間 |
非商用版にはGigaSpeech 1万時間とSPGI Speech 4,900時間が追加されています。Apache 2.0版の学習時間に対して24.6%増です。Open ASR Leaderboardを使ったIBM公称の公開英語短音声テスト群の平均単語誤り率は、Apache 2.0版が5.00%、非商用版が4.85%でした。18
差は 5.00 - 4.85 = 0.15 ポイントです。Apache 2.0版を基準にした相対差は3.0%になります。「3%低い」と「0.15ポイント低い」は同じ比較を別の尺度で表したもので、0.15%ではありません。
ただし、学習時間が増えたから差のすべてが生じた、とまでは言えません。データの内容、混合比、学習手順も影響します。公開表から確定できるのは、データ量と公称結果が違うところまでです。
隔離環境で二つとも動かした
システム環境を変えず、uv でPythonを一時ディレクトリへ入れ、二つの隔離環境を作りました。モデルカードは公開後に更新され、現在は transformers>=5.16.0 で利用できます。234
最初の環境では、合計62.45秒、151語のLibriSpeech由来の公開音声5件を一括処理しました。二つ目では、公式利用例のバルセロナ天気音声と、macOSの音声合成で作った会議、固有名詞、金額を含む3件を処理しました。
| 観測 | Apache 2.0版 | 非商用版 |
|---|---|---|
| パラメータ数 | 472,928,256 | 472,928,256 |
| 重みファイル | 946,180,704バイト | 946,180,704バイト |
| 公開音声5件の誤り | 13語 / 151語 | 13語 / 151語 |
| 公開音声5件のWER | 8.61% | 8.61% |
| 別の4音声 | 意味上同じ出力 | 意味上同じ出力 |
この結果は「二つの精度が同じ」という証明ではありません。5件の音声は学習データにも含まれるLibriSpeech由来で、短い確認用です。別の4件も、公式サンプルと合成音声にすぎません。分かったのは、両方をローカルで実行でき、この9件では非商用版を選ぶ決定的な差が見つからなかったことです。
速度は順位から外しました。キャッシュ済みの5件一括推論はApache 2.0版が0.819秒、非商用版が0.735秒でしたが、各1回で、実行順とウォームアップの影響を除けていません。そのため0.084秒の差をモデル固有の優位とは扱いません。
失敗から分かった実行条件
実行は一度で成功しませんでした。モデルカードに載る主なライブラリだけを入れた最初の試行は、特徴抽出器が torchaudio を必要として停止。追加後、MPSへ標準のBF16で載せると、正規化処理の型が合わずLLVMエラーで終了しました。
そこでモデルを float32 で読み込み、入力と重みの型をそろえると、MPSで4件すべて成功。これはMacなら常にfloat32が正解という意味ではありません。今回のmacOS、PyTorch、Transformersの組み合わせで通った回避策でした。GPU、CPU、ライブラリの版が変われば、必要な型も速度も変わります。
もう一つの環境では、datasets のAudioデコーダーでmacOS上の torchcodec シンボルエラーが発生しました。データに埋め込まれたFLACを soundfile で直接読むと続行できました。モデルの失敗と、音声を読み込む周辺部品の失敗を分けて記録しておくと、原因を誤りにくくなります。
WERは文字の整え方でも変わる
単語誤り率、WERは、正解文に対する置換、削除、挿入の合計を正解の単語数で割った値です。低いほど誤りが少ない指標ですが、計算前に文字をどうそろえるかで値が変わります。1112
今回のバルセロナ音声は、意味としては正しくても、正解文の thirty five に対して出力が 35 でした。金額音声も、twelve point five percent と three million dollars が 12.5%、$3000000 になります。単純に小文字化して記号を消すだけの計算では、同じ内容を複数の単語誤りとして数えました。
これはモデルの欠点というより、評価規則の問題です。業務で数字を数字として保存したいなら、この変換はむしろ望ましい結果です。反対に、字幕で話した語をそのまま残したい用途では不一致になります。WERの一つの数字だけでなく、数字、固有名詞、否定語、金額など、間違えたときの費用が高い語を別に数える必要があります。
候補を絞ってから自分の音声を測る
今回の結果から、筆者が選ぶ順番は次の通りです。
| 順序 | 作業 |
|---|---|
| 1 | STT、TTS、話者分離のどれが必要かを分ける |
| 2 | 利用者、入力音声、目的、実行場所、配布方法を一文にする |
| 3 | モデルカードとライセンス本文を保存し、候補に残せる版を決める |
| 4 | 録音の同意、個人情報、保存期間、外部送信の有無を確認する |
| 5 | 自分の音声を会議、電話、雑音、固有名詞などに分ける |
| 6 | WERに加え、業務上困る誤り、実時間、メモリを測る |
| 7 | モデルのコミット、評価音声、正規化コード、依存版を一緒に残す |
英語だけを自社端末で処理したいなら、Granite Speech 5.0は試す価値のある候補です。多言語や翻訳が必要ならWhisper系、運用を自前で持ちたくないならクラウドAPIも同じ入力で比べます。Apache 2.0版が自分の精度基準を満たさなければ、固有名詞の後処理や別モデルとの比較へ進みます。
九つの短い音声を動かしてみて、公式表の小さな差より先に目についたのは、モデルが担当しない周辺作業と利用条件でした。Graniteは録音アプリではなく、英語音声を文字へ変える部品です。その位置が分かれば、TTSを期待して試すことも、非商用版を業務候補の先頭へ置くことも避けられます。精度を軽く見るのではなく、必要な役割と使える条件を通った候補だけを、意味のある音声と測り方で比べる。その順序が業務用の音声認識選びには合っています。
参照リンク12件
- IBM GraniteGranite Speech 5.0 470M TurboCTC
- IBM Granitegranite-speech-5.0-470m-turboctc model card
- IBM Granitegranite-speech-5.0-470m-turboctc-nc model card
- Hugging FaceOpen ASR Leaderboard
- Hugging FaceGraniteSpeech5
- OpenAIIntroducing Whisper
- Google CloudSpeech-to-Textの概要
- Microsoft Learn音声テキスト変換の概要
- Hugging Face自動音声認識の評価
- Hugging Face単語誤り率
- Creative Commons表示—非営利—継承 4.0 国際
- Apache Software FoundationApache License 2.0
2026年8月29日時点の公式資料を確認しています。仕様は更新される可能性があります。